
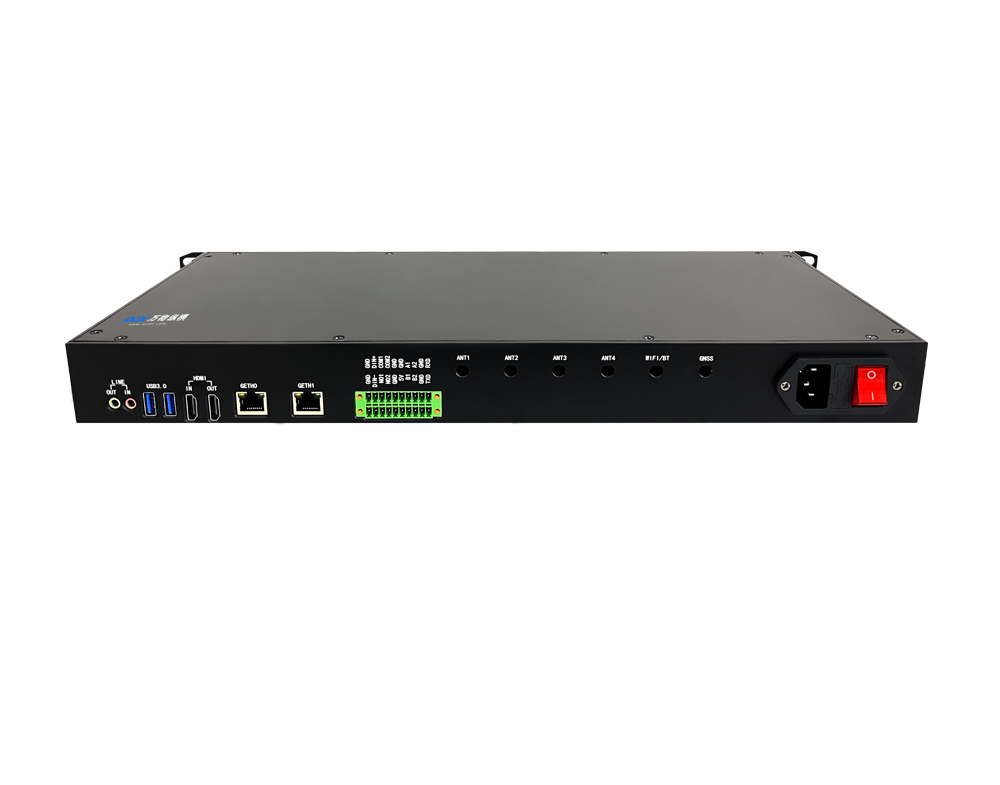
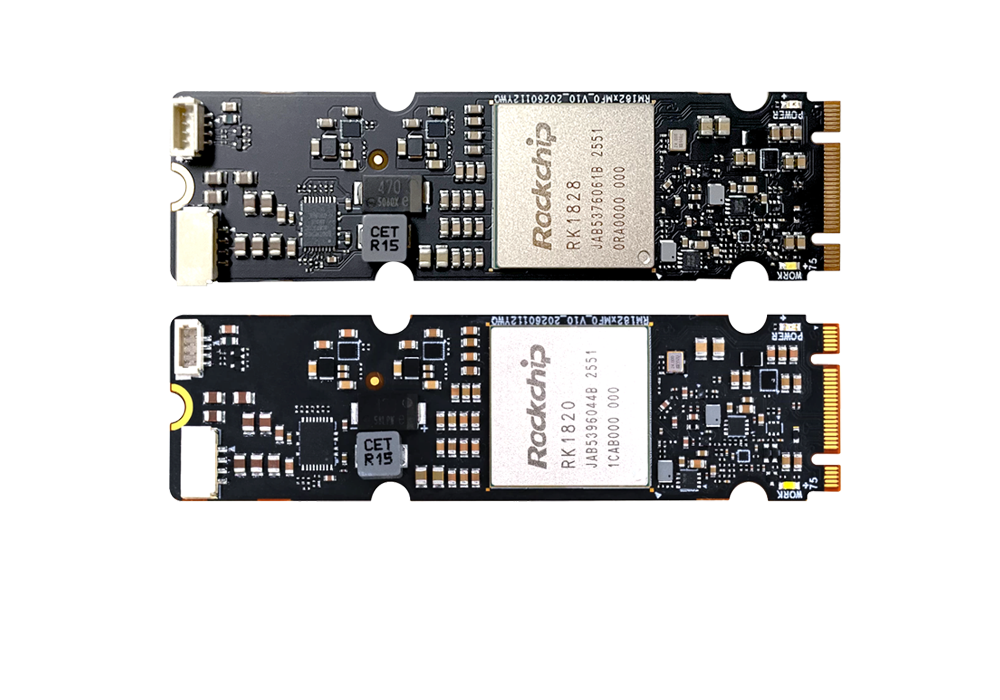
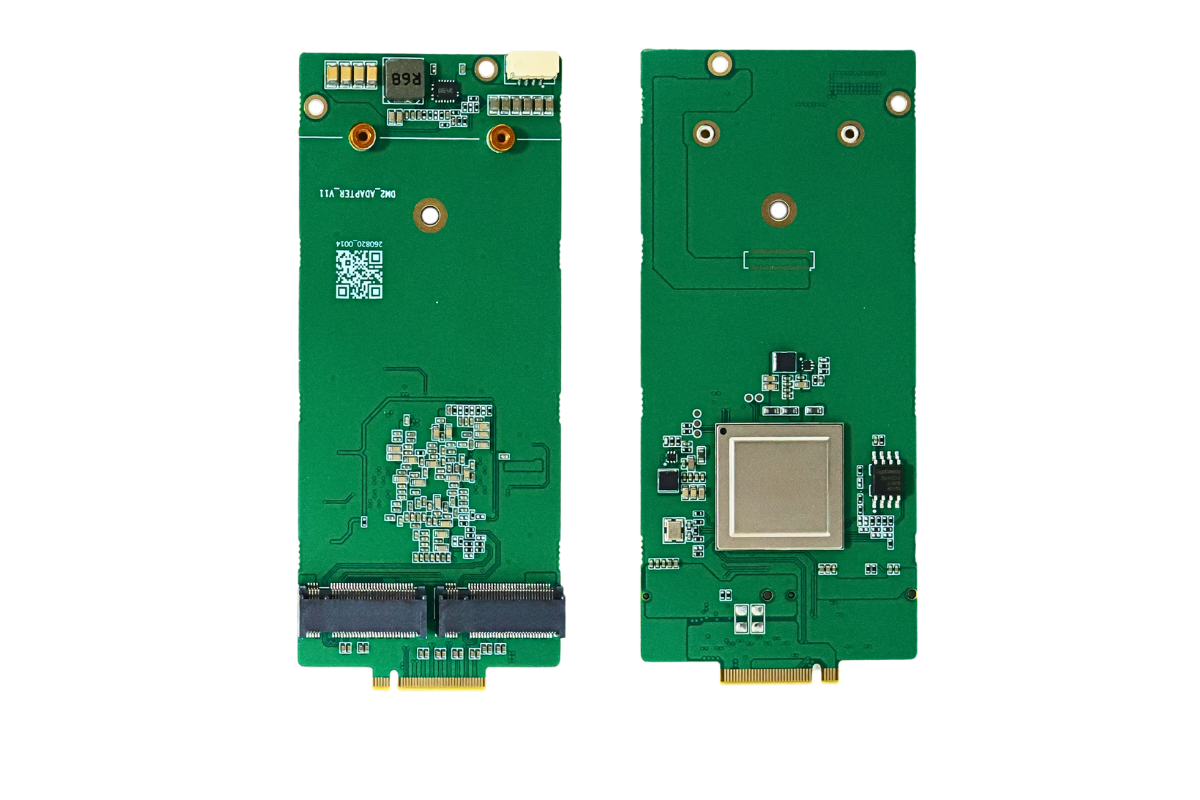


RK1828 是 RK3588/RK3576 配套 NPU 协处理器,仅支持 RKNN3 Toolkit V1.0+,PyTorch 模型必须走「PyTorch → ONNX → RKNN3」标准链路,分PC 主机模型转换、开发板端推理部署两大阶段,下文全流程含代码、配置、踩坑要点。
一、环境前置准备(PC 转换主机 + RK1828 开发板)
1. PC 转换主机环境(x86 Ubuntu20.04/22.04,推荐 Conda 虚拟环境)
(1)基础依赖安装
# 1. 创建虚拟环境
conda create -n rknn3 python=3.8
conda activate rknn3
# 2. PyTorch(匹配CUDA,导出ONNX用)
pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
# 3. ONNX链路工具(核心,解决算子不兼容)
pip install onnx onnxsim onnxruntime numpy opencv-python pillow
# 4. RKNN3 Toolkit(RK1828专用,不可用RKNN2)
# 从瑞芯微官网下载 rknn_toolkit3-1.0.0-cp38-cp38-linux_x86_64.whl
pip3 install rknn_toolkit3-1.0.0-cp38-cp38-linux_x86_64.whl
# 校验安装成功
python3 -c "from rknn.api import RKNN; print('RKNN3导入正常')"
关键约束
RKNN3 仅支持 Python3.8;RK1828 target_platform="rk3588"(RK1828 绑定 RK3588/RK3576 主芯片)
禁止混用 RKNN2 Toolkit,转换出的模型无法在 RK1828 运行
2. RK1828 开发板环境(Linux ARM64)
1. 固件要求:系统 SDK 内置RKNN3 Runtime [librknnrt.so](librknnrt.so) v1.0+,旧固件需全量升级
2. 板端依赖包:rknn_api_arm64、交叉编译工具链 aarch64-linux-gnu-gcc
3. 传输工具:ADB/SSH,用于推送 rknn 模型、推理程序、动态库
二、阶段 1:PyTorch 模型导出标准 ONNX(最易踩坑环节)
步骤 1:模型预处理(必须 eval+cpu,禁用动态训练逻辑)
核心规则:
1. 模型切model.eval(),关闭 Dropout/BatchNorm 训练分支
2. 移至 CPU 导出(GPU 导出易出现动态 shape 算子)
3. 固定输入尺寸(推荐静态 shape,动态输入会大幅降低 RK1828 推理速度)
4. 禁用 Torch 自定义算子、torch.where/ 复杂interpolate,尽量替换为标准 ONNX 算子
导出完整代码(通用分类 / 检测模型)
import torch
import torchvision
# 1. 加载训练好的PyTorch模型(.pt/.pth)
model = torchvision.models.resnet18(pretrained=True)
model.eval()
model.cpu()
# 2. 固定输入:NCHW [1,3,640,640] 匹配你的模型输入分辨率
dummy_input = torch.randn(1, 3, 640, 640)
# 3. ONNX导出参数(RKNN3兼容配置)
onnx_path = "model_raw.onnx"
torch.onnx.export(
model,
dummy_input,
onnx_path,
opset_version=17, # RKNN3推荐opset16~17,过低算子缺失
do_constant_folding=True, # 常量折叠,减少计算节点
input_names=["input"],
output_names=["output"],
dynamic_axes=None, # 静态输入,注释掉则开启动态shape
)
print(f"原始ONNX导出完成:{onnx_path}")
步骤 2:ONNX 简化 + 校验(必做,解决冗余算子转换失败)
# 1. 模型简化,消除Reshape/Unsqueeze冗余节点
python3 -m onnxsim model_raw.onnx model_simplified.onnx
# 2. 合法性校验,报错则修改PyTorch导出逻辑
python3 -c "
import onnx
m = onnx.load('model_simplified.onnx')
onnx.checker.check_model(m)
print('ONNX模型校验通过')
"
常见导出报错修复
1. interpolate算子异常:替换align_corners=False,onnxsim 二次简化
2. 动态 Batch:删除dynamic_axes强制静态 batch=1
3. 自定义 loss / 推理分支:导出前注释训练相关代码
三、阶段 2:RKNN3 Toolkit 转换 ONNX → RK1828 专用.rknn 模型
RK1828 NPU 支持W8A8 对称 / 非对称 INT8 量化,大模型 LLM 支持 W4A16,CNN 视觉模型默认 W8A8,下面是完整转换脚本onnx2rknn_rk1828.py
完整转换脚本(含量化、仿真推理、模型导出)
from rknn.api import RKNN
import numpy as np
# ====================== 配置区(根据自己模型修改)======================
ONNX_MODEL = "model_simplified.onnx"
RKNN_MODEL = "rk1828_model.rknn"
DATASET_TXT = "./calib_dataset.txt" # INT8量化校准数据集
TARGET_PLATFORM = "rk3588" # RK1828配套主芯片固定填rk3588
# 图像预处理均值标准差(PyTorch归一化映射到RKNN NHWC格式)
# 例1:ImageNet归一化 input = img/255 mean / std
mean = [0.485, 0.456, 0.406]
std = [0.229, 0.224, 0.225]
# RKNN要求mean/std乘255,RGB通道顺序
MEAN_VALUES = [[m*255 for m in mean]]
STD_VALUES = [[s*255 for s in std]]
# ======================================================================
# 1. 初始化RKNN3对象
rknn = RKNN(verbose=True)
# 2. RKNN全局配置(适配RK1828 NPU)
print("===== RKNN配置 =====")
rknn.config(
target_platform=TARGET_PLATFORM,
mean_values=MEAN_VALUES,
std_values=STD_VALUES,
quantized_dtype="asymmetric_quantized-8", # 视觉模型推荐非对称INT8
quantized_algorithm="normal",
optimization_level=3, # 最高算子优化,释放RK1828算力
rknn_batch_size=1,
force_use_cpp_infer=True
)
# 3. 加载简化后的ONNX模型
print("===== 加载ONNX =====")
ret = rknn.load_onnx(model=ONNX_MODEL)
assert ret == 0, "ONNX加载失败,检查opset/算子兼容性"
# 4. 构建+INT8量化模型(核心步骤,使用校准数据集)
print("===== 构建并量化RKNN模型 =====")
ret = rknn.build(do_quantization=True, dataset=DATASET_TXT)
assert ret == 0, "模型构建量化失败"
# 5. PC端仿真推理校验(和PyTorch输出对比,判断量化精度损失)
print("===== PC仿真推理校验 =====")
# 构造测试输入 NCHW
test_input = np.random.randn(1, 3, 640, 640).astype(np.float32)
# RKNN自动转NHWC,无需手动调换通道
output = rknn.inference(inputs=[test_input])
print("RKNN推理输出shape:", output[0].shape)
# 6. 导出RK1828可部署.rknn模型
print("===== 导出RKNN模型 =====")
ret = rknn.export_rknn(RKNN_MODEL)
assert ret == 0, f"导出失败,目标文件:{RKNN_MODEL}"
# 7. 释放资源
rknn.release()
print(f"RK1828模型转换完成:{RKNN_MODEL}")
配套量化校准数据集制作(calib_dataset.txt)
INT8 量化必须提供真实样本校准,降低精度损耗:
1. 选取 100~300 张训练集图片,每行写图片绝对路径
/data/calib/img1.jpg
/data/calib/img2.jpg
/data/calib/img3.jpg
...
2. 脚本读取图片自动做和训练一致的预处理,RKNN 内部完成量化校准
量化策略选型(RK1828 专属)
模型类型 | 量化方案 | 参数配置 | 适用场景 |
CNN/YOLO 检测 / 分类 | W8A8 非对称 | quantized_dtype="asymmetric_quantized-8" | 工业视觉、摄像头实时推理 |
ViT / 多模态小模型 | W8A8 对称 | quantized_dtype="symmetric_quantized-8" | 精度敏感场景 |
LLM 大语言模型 | W4A16 AWQ 量化 | 开启 weight_separate=True | RKLLM 专用大模型推理 |
四、阶段 3:RK1828 开发板端部署(ARM64 Linux 推理)
1. 板端文件准备
将 PC 生成文件推送至 RK3588 (RK1828) 开发板:
1. rk1828_model.rknn 转换完成模型
2. RKNN3 ARM64 运行时库:librknnrt.so、rknn_api.h
3. C++ 推理 Demo 源码(瑞芯微 RKNN3 SDK 自带示例)
推送命令(ADB):
adb push rk1828_model.rknn /data/ai_model/
adb push rknn_runtime/lib/aarch64-linux-gnu/librknnrt.so /data/ai_model/lib/
2. ARM64 交叉编译推理程序
CMakeLists.txt 核心配置:
cmake_minimum_required(VERSION 3.10)
project(rknn_demo)
set(CMAKE_CXX_STANDARD 11)
# RKNN3头文件&库路径
include_directories(./rknn_runtime/include)
link_directories(./lib)
add_executable(infer_demo main.cc)
target_link_libraries(infer_demo rknnrt)
编译脚本build.sh:
aarch64-linux-gnu-g++ -o infer_demo main.cc -I./include -L./lib -lrknnrt
3. 板端运行推理(RK1828 NPU 调用)
# 进入开发板shell
adb shell
cd /data/ai_model
# 指定RKNN3运行时库路径
export LD_LIBRARY_PATH=./lib:$LD_LIBRARY_PATH
# 运行推理程序,加载RK1828模型
./infer_demo ./rk1828_model.rknn
板端推理核心逻辑(C++ 极简流程)
1. rknn_init 加载.rknn 模型,自动绑定 RK1828 NPU 协处理器
2. 图像预处理:VPU 硬件缩放 + 通道转换 BGR→RGB(减轻 NPU 负载)
3. rknn_input_set 填充 NHWC 格式输入数据
4. rknn_run 调用 RK1828 多核 NPU 并行推理
5. rknn_output_get 获取推理结果,后处理(NMS / 分类解码)
6. rknn_destroy 释放 NPU 硬件资源
五、全链路关键适配要点(RK1828 专属避坑)
1. 数据格式转换(PyTorch NCHW ↔ RKNN NHWC)
PyTorch:[Batch, Channel, H, W]
RK1828 NPU 原生:[Batch, H, W, Channel]
RKNN3 内部自动转置通道,只需在rknn.config填写正确 mean/std,无需手动调换输入维度。
2. 输入预处理对齐(精度损失头号来源)
训练时归一化逻辑必须和 RKNN 配置完全一致:
训练:img = img / 255.0 mean / std
RKNN config:mean_values=[[m*255]], std_values=[[s*255]]
若训练直接归一化到[-1,1],则mean=127.5, std=127.5
3. RK1828 算力优化配置
1. optimization_level=3:开启层融合、算子重排,多核调度优化
2. 静态输入 shape:禁用dynamic_axes,NPU 缓存固定计算图,帧率提升 30%+
3. 多路视频:使用 VPU 硬解码预处理,不占用 CPU 做 resize/crop
4. 常见报错解决方案
1. 转换报错:target_platform 不匹配
RK1828 依附 RK3588 主芯片,必须填target_platform="rk3588",不能填 rk1828
2. 板端加载模型失败:版本不兼容
PC RKNN3 Toolkit 版本必须与板端 [librknnrt.so](librknnrt.so) 完全一致(均 V1.0.x)
3. 量化后精度暴跌
校准数据集数量不足、预处理均值 std 不匹配;改用混合量化hybrid_quantization固定关键卷积层 FP16
4. RK1828 推理速度慢
开启静态输入、优化等级 3;输入分辨率不要超过 NPU 最优尺寸(640×640/1280×720)
六、完整流程总览
1. PyTorch 模型 eval+CPU 导出 ONNX (opset17)
2. onnxsim 简化模型 + onnx 校验
3. RKNN3 配置 RK3588 平台、INT8 量化、输入归一化参数
4. 构建量化 RKNN 模型,PC 仿真推理校验精度
5. 导出.rknn 模型推送至 RK1828 开发板
6. ARM64 交叉编译 RKNN3 Runtime 推理程序
7. 开发板加载模型,调用 RK1828 NPU 完成端侧推理
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部