现象总结:批量交付才暴露、常温可能稳定、高温(通常60℃+壳温/环境55℃以上)随机NPU掉卡、系统识别不到NPU、PCIe链路降速/重训练(LTSSM Ret
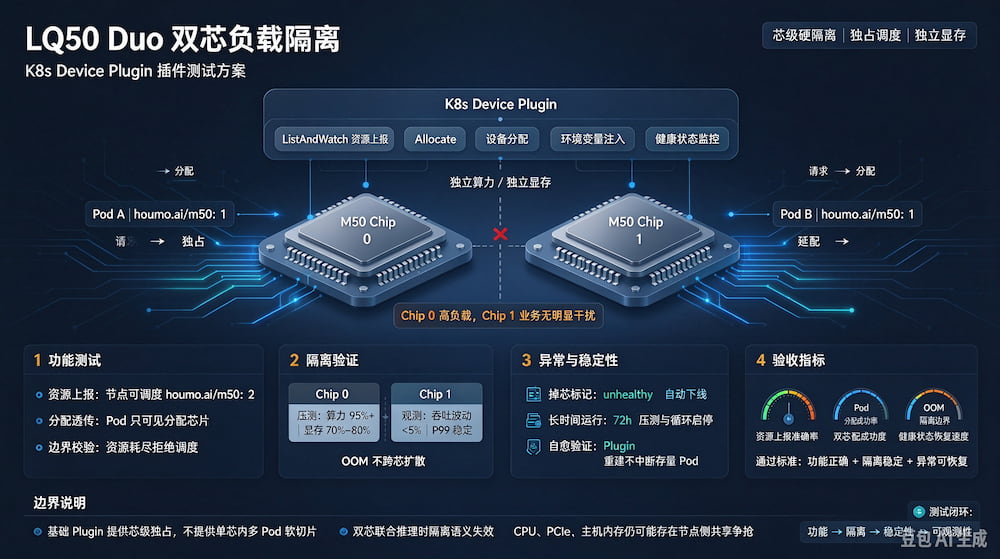
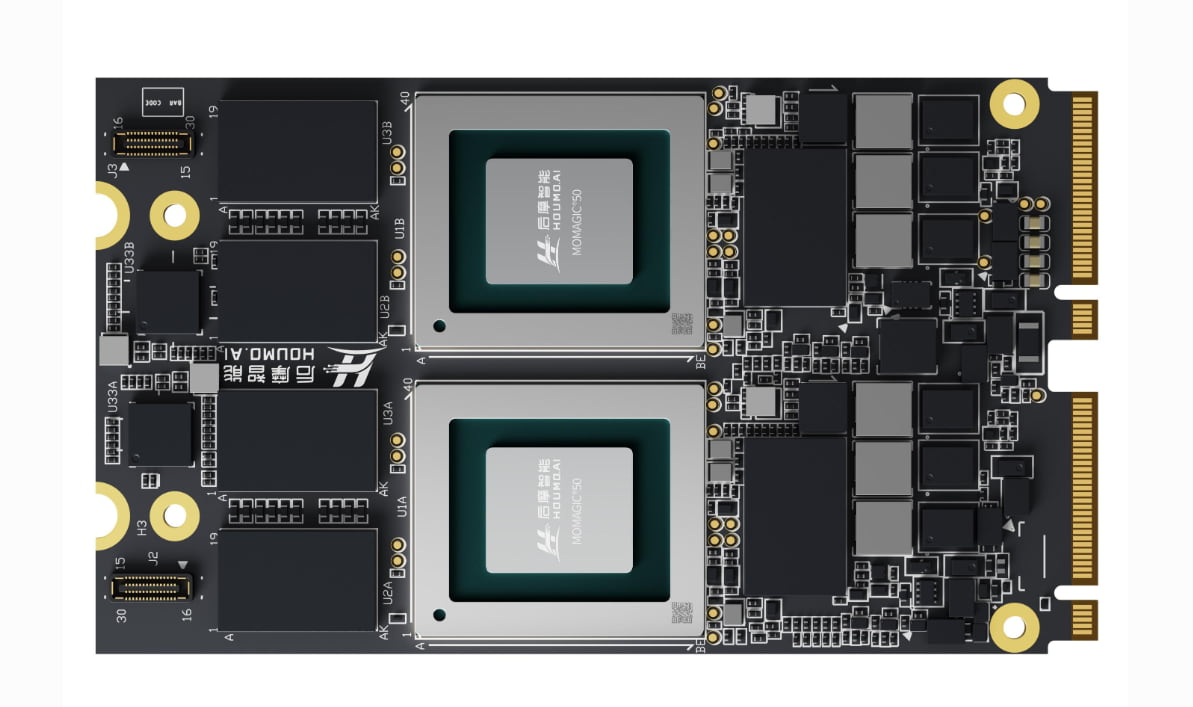
核心前提:LQ50 Duo 板载两颗独立 M50 芯片,硬件上双芯是独立算力单元、独立显存。目标是把每一颗 M50 作为独立可调度资源,实现芯级硬隔离——Pod
更新要点LQ50 DUO 双 IPU 共享 PCIe 通道,多任务同时收发张量、KV 缓存搬运时,容易出现带宽争抢,引发单路推理吞吐波动、token 速率忽高忽
一、测试概要硬件平台:BM1688 边缘 AI 盒子,SOPHON BM1688 TPU,8 核 A53@1.6GHz,8GB LPDDR4,32GB eMMC
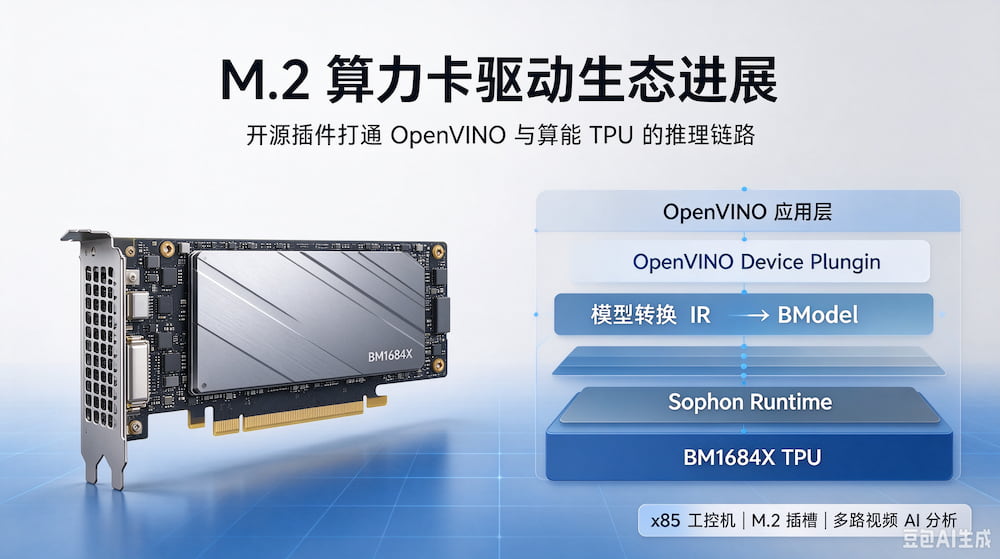
算能正式开源面向 BM1684X M.2 PCIe 算力卡 的 OpenVINO Device Plugin,打通 OpenVINO 推理框架与算能 TPU 硬
一、硬件架构主控:RK3588(仅做任务调度、外设管理,不参与 LLM 算力计算)加速卡:4 张 M.2 2280 Key-BM RK1828 AI 算力卡,P
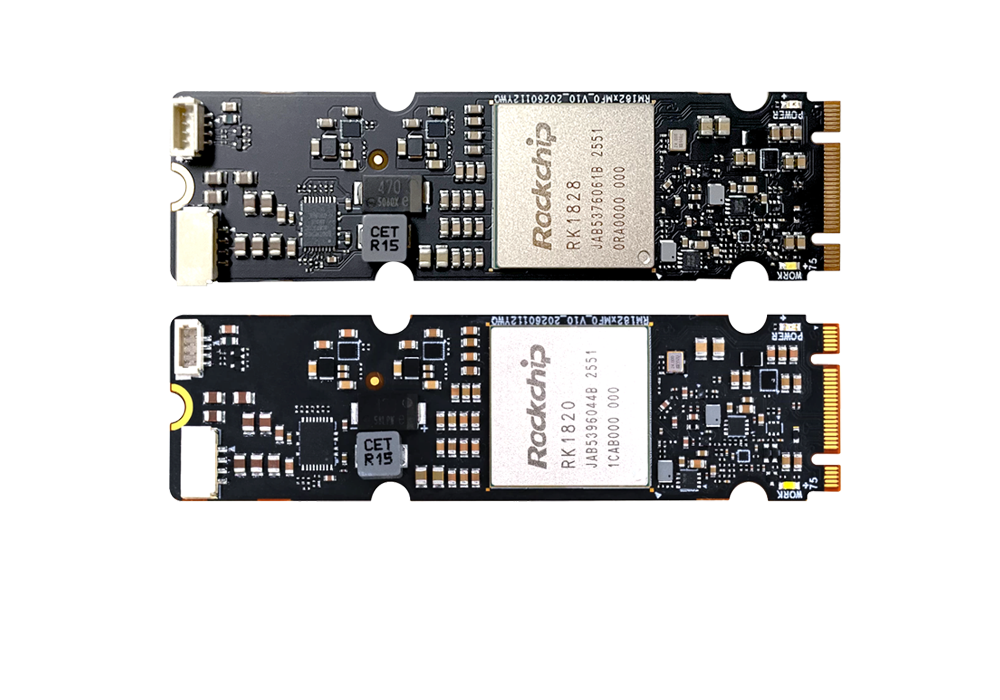
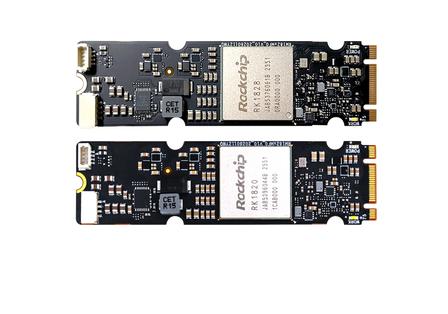
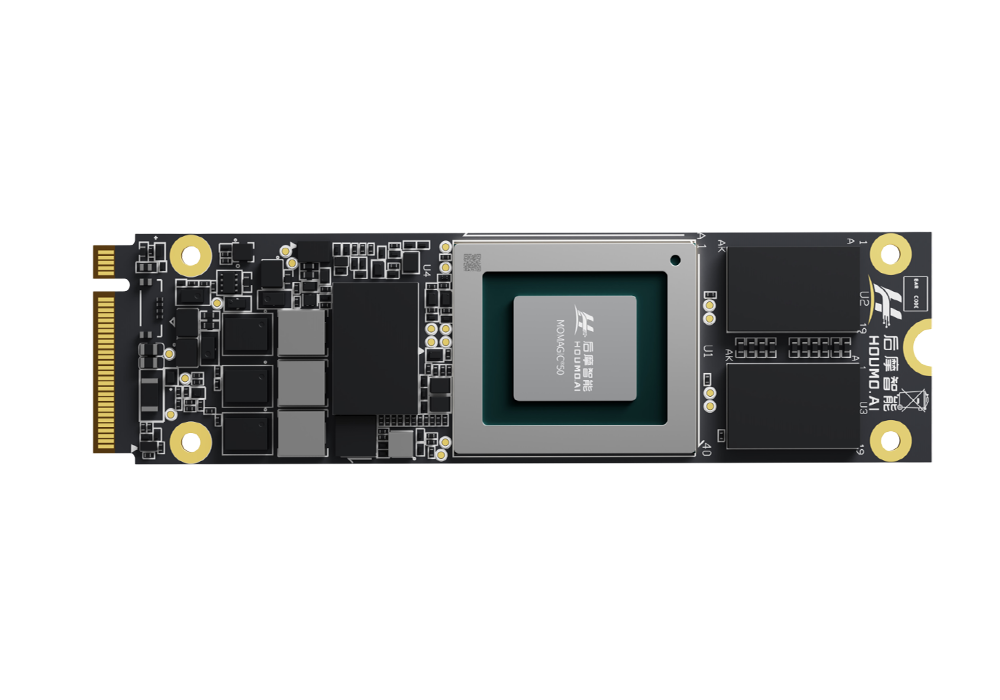
一、硬件核心规格RK1828 是瑞芯微 RK182X 系列 M.2 2280 形态 AI 协算力卡,定位边缘端本地大模型推理,峰值算力 20TOPS@INT8接
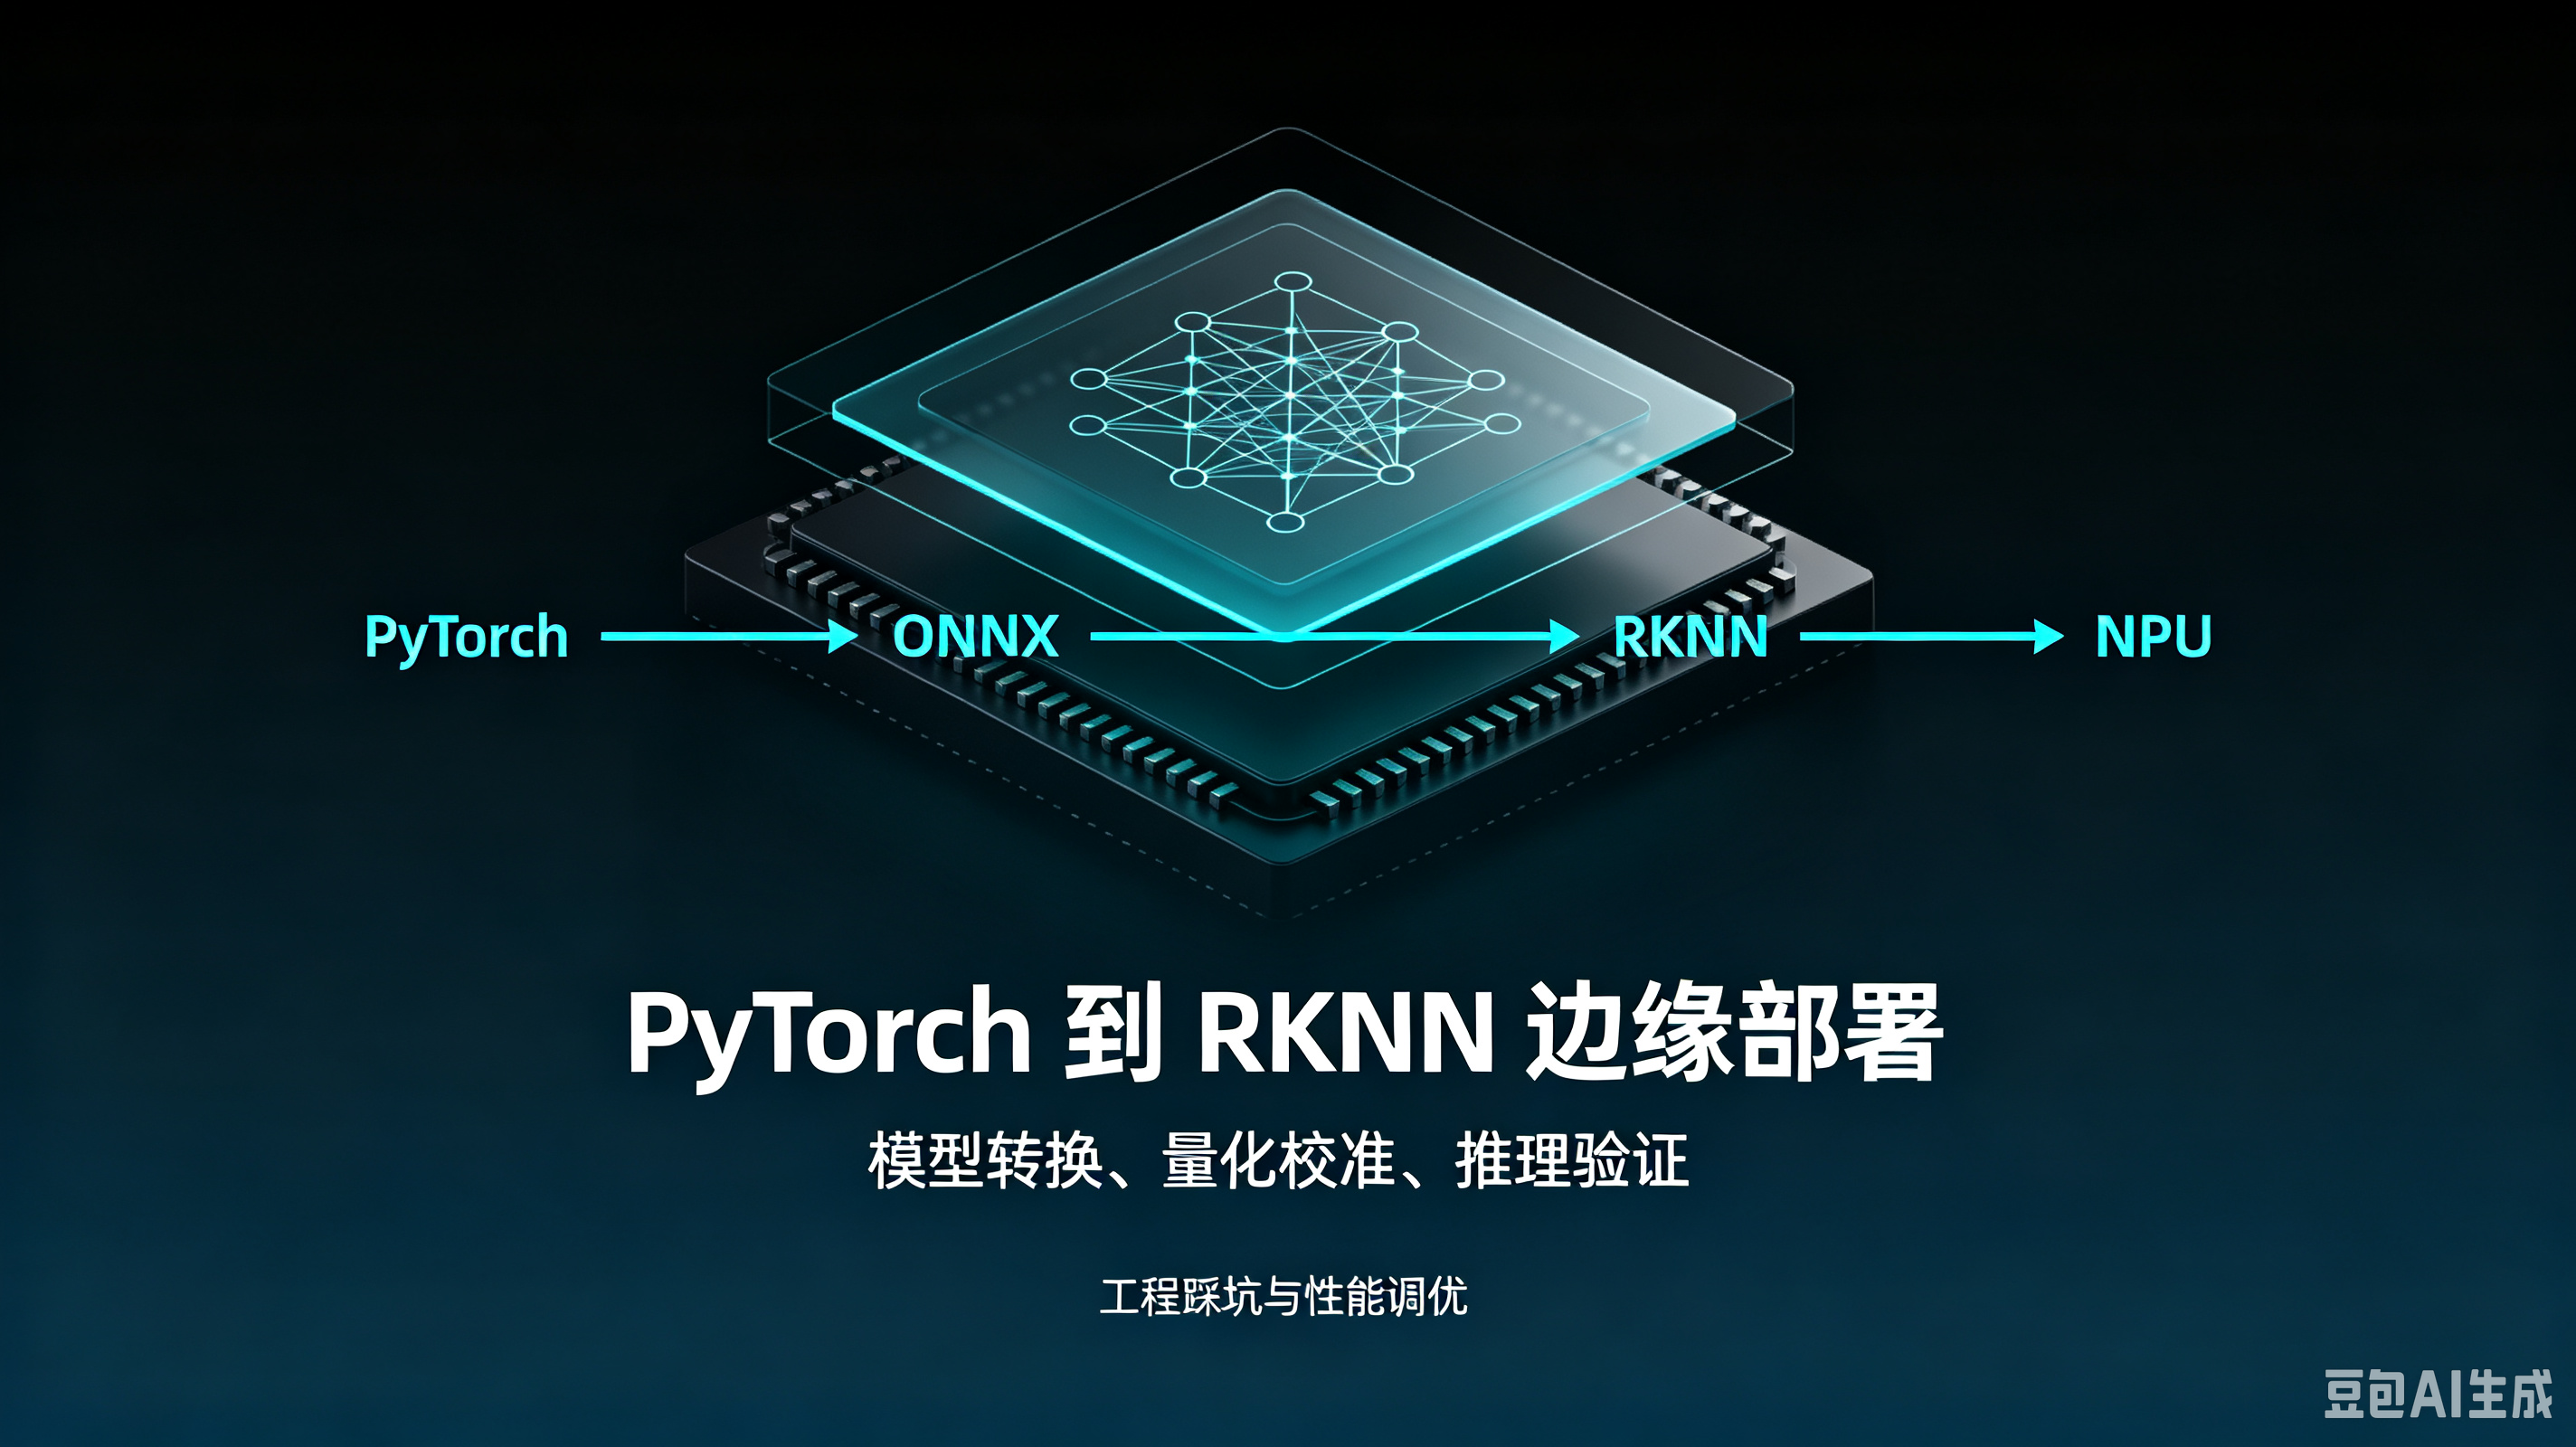
适用:瑞芯微 RK3588/RK3568 等边缘盒子,RKNN‑Toolkit2,PyTorch 训练模型,覆盖转换、踩坑、推理、性能调优、实际部署整套流程。整
两套均为国内信创项目主流国产边缘方案,硬件 + 操作系统全栈国产化,用来替代 Jetson 海外平台,面向智慧工地、明厨亮灶、工业网关、电力能源、政务园区场景。
重要前置说明1. RKNN3 / RKLLM3 官方原生不支持多卡张量并行跑 27B 稠密大模型,没有开箱即用多卡 demo;整套多卡分片协同推理需要上层自研调
测试对象:算能 SE5‑16 (BM1684)、SE7‑32 (BM1684X)、SE9‑16 (BM1688);对比参考国产 RK3588 盒子;模型 YOL
测试基准统一条件:1. 硬件形态:均为 M.2 2280 算力卡;2. 主控平台:RK3588 工业主板,PCIe 直连;3. 量化标准:INT8 量化,统一推
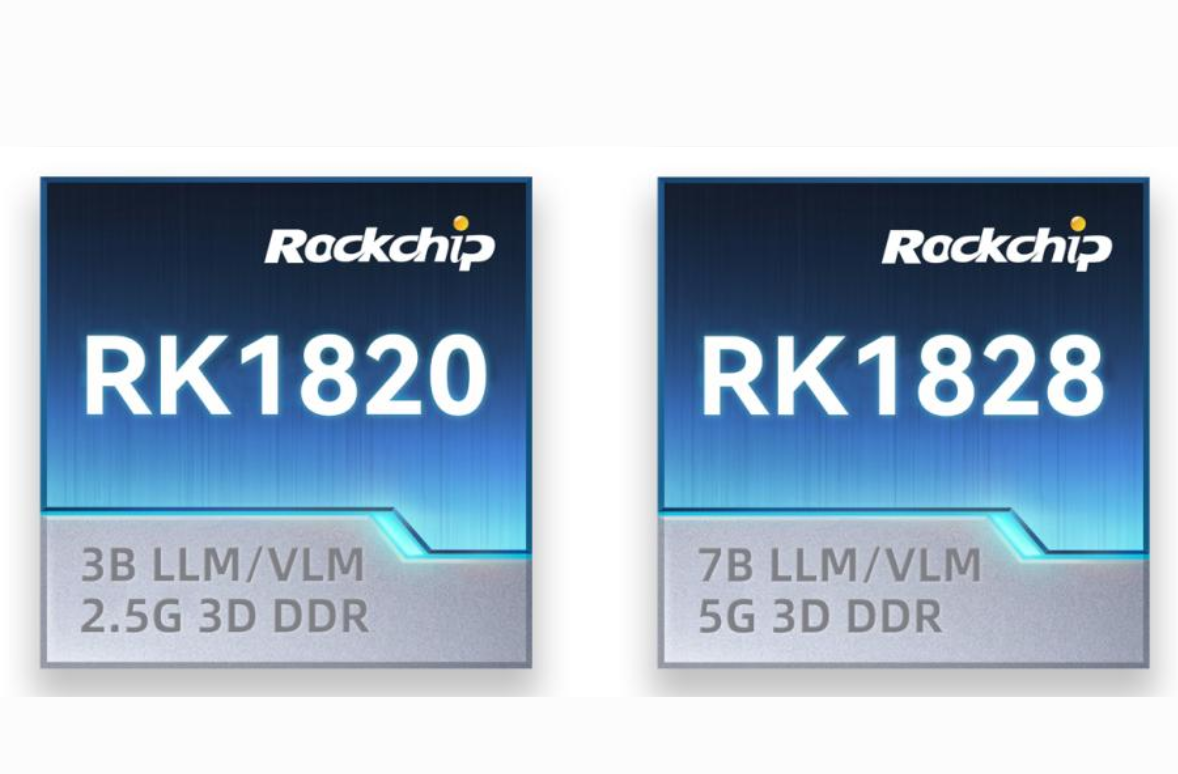
RKNN3 适配 RK1828、力擎 LQ50 算力卡 全量优化技巧 + PCIe 传输延迟专项降延迟方案RK1828搭载 5GB 片内 3D DRAM,通过
LQ50 为基于 RK1828 的 M.2 算力卡,目标芯片统一填 rk1828;RK1820 目标芯片填 rk1820。RKNN3 SDK V1.0,硬件架构
架构说明:RK3588 为主控,RK1820/RK1828(瑞芯微 M.2 协算卡)、力擎 LQ50 M.2 算力卡作为 PCIe AI 加速卡,异构协同;RK
一、方案概述1. 技术组合检测模型:YOLO 系列(YOLOv5 / YOLOv8 / YOLOv9 / YOLOv10),负责目标检测、类别识别、目标坐标输出
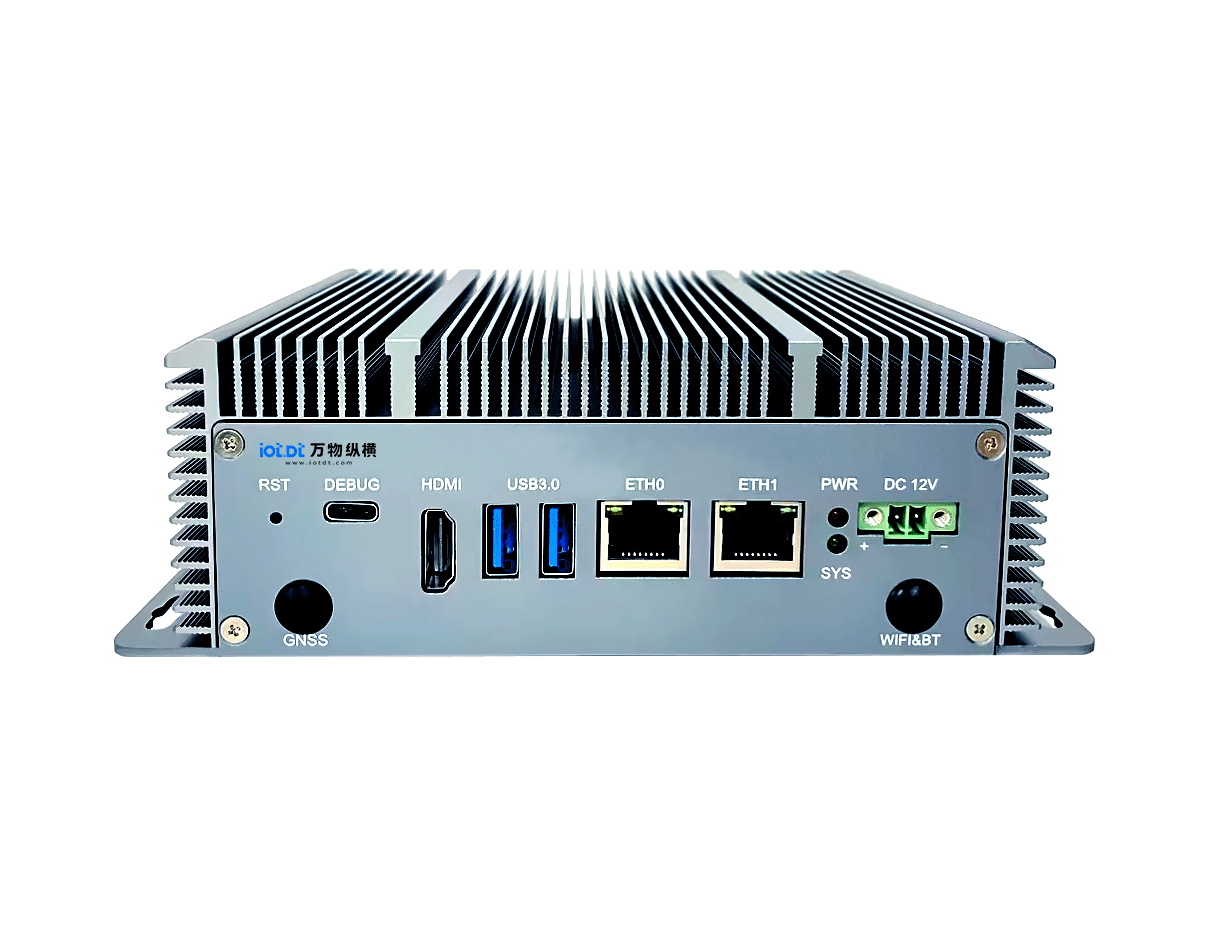
一、基础概念边缘计算盒子(边缘 AI 网关 / 算法盒子):内置嵌入式算力芯片(瑞芯微 RK3588/RK1828、算能 BM1688、昇腾、力擎 LQ50 等
一、两种离线部署路线(瑞芯微 AIBOX 实测)方案 1:RKLLM(NPU 硬件加速,首选)瑞芯微官方大模型推理框架,支持 W8A8 / W4A16 量化,模
一、核心亮点概述RKNN3 作为瑞芯微新一代模型转换与推理工具链,针对 RK3588 NPU 深度适配,解决旧版 RKNN2 移植繁琐、算子适配难、多框架兼容差
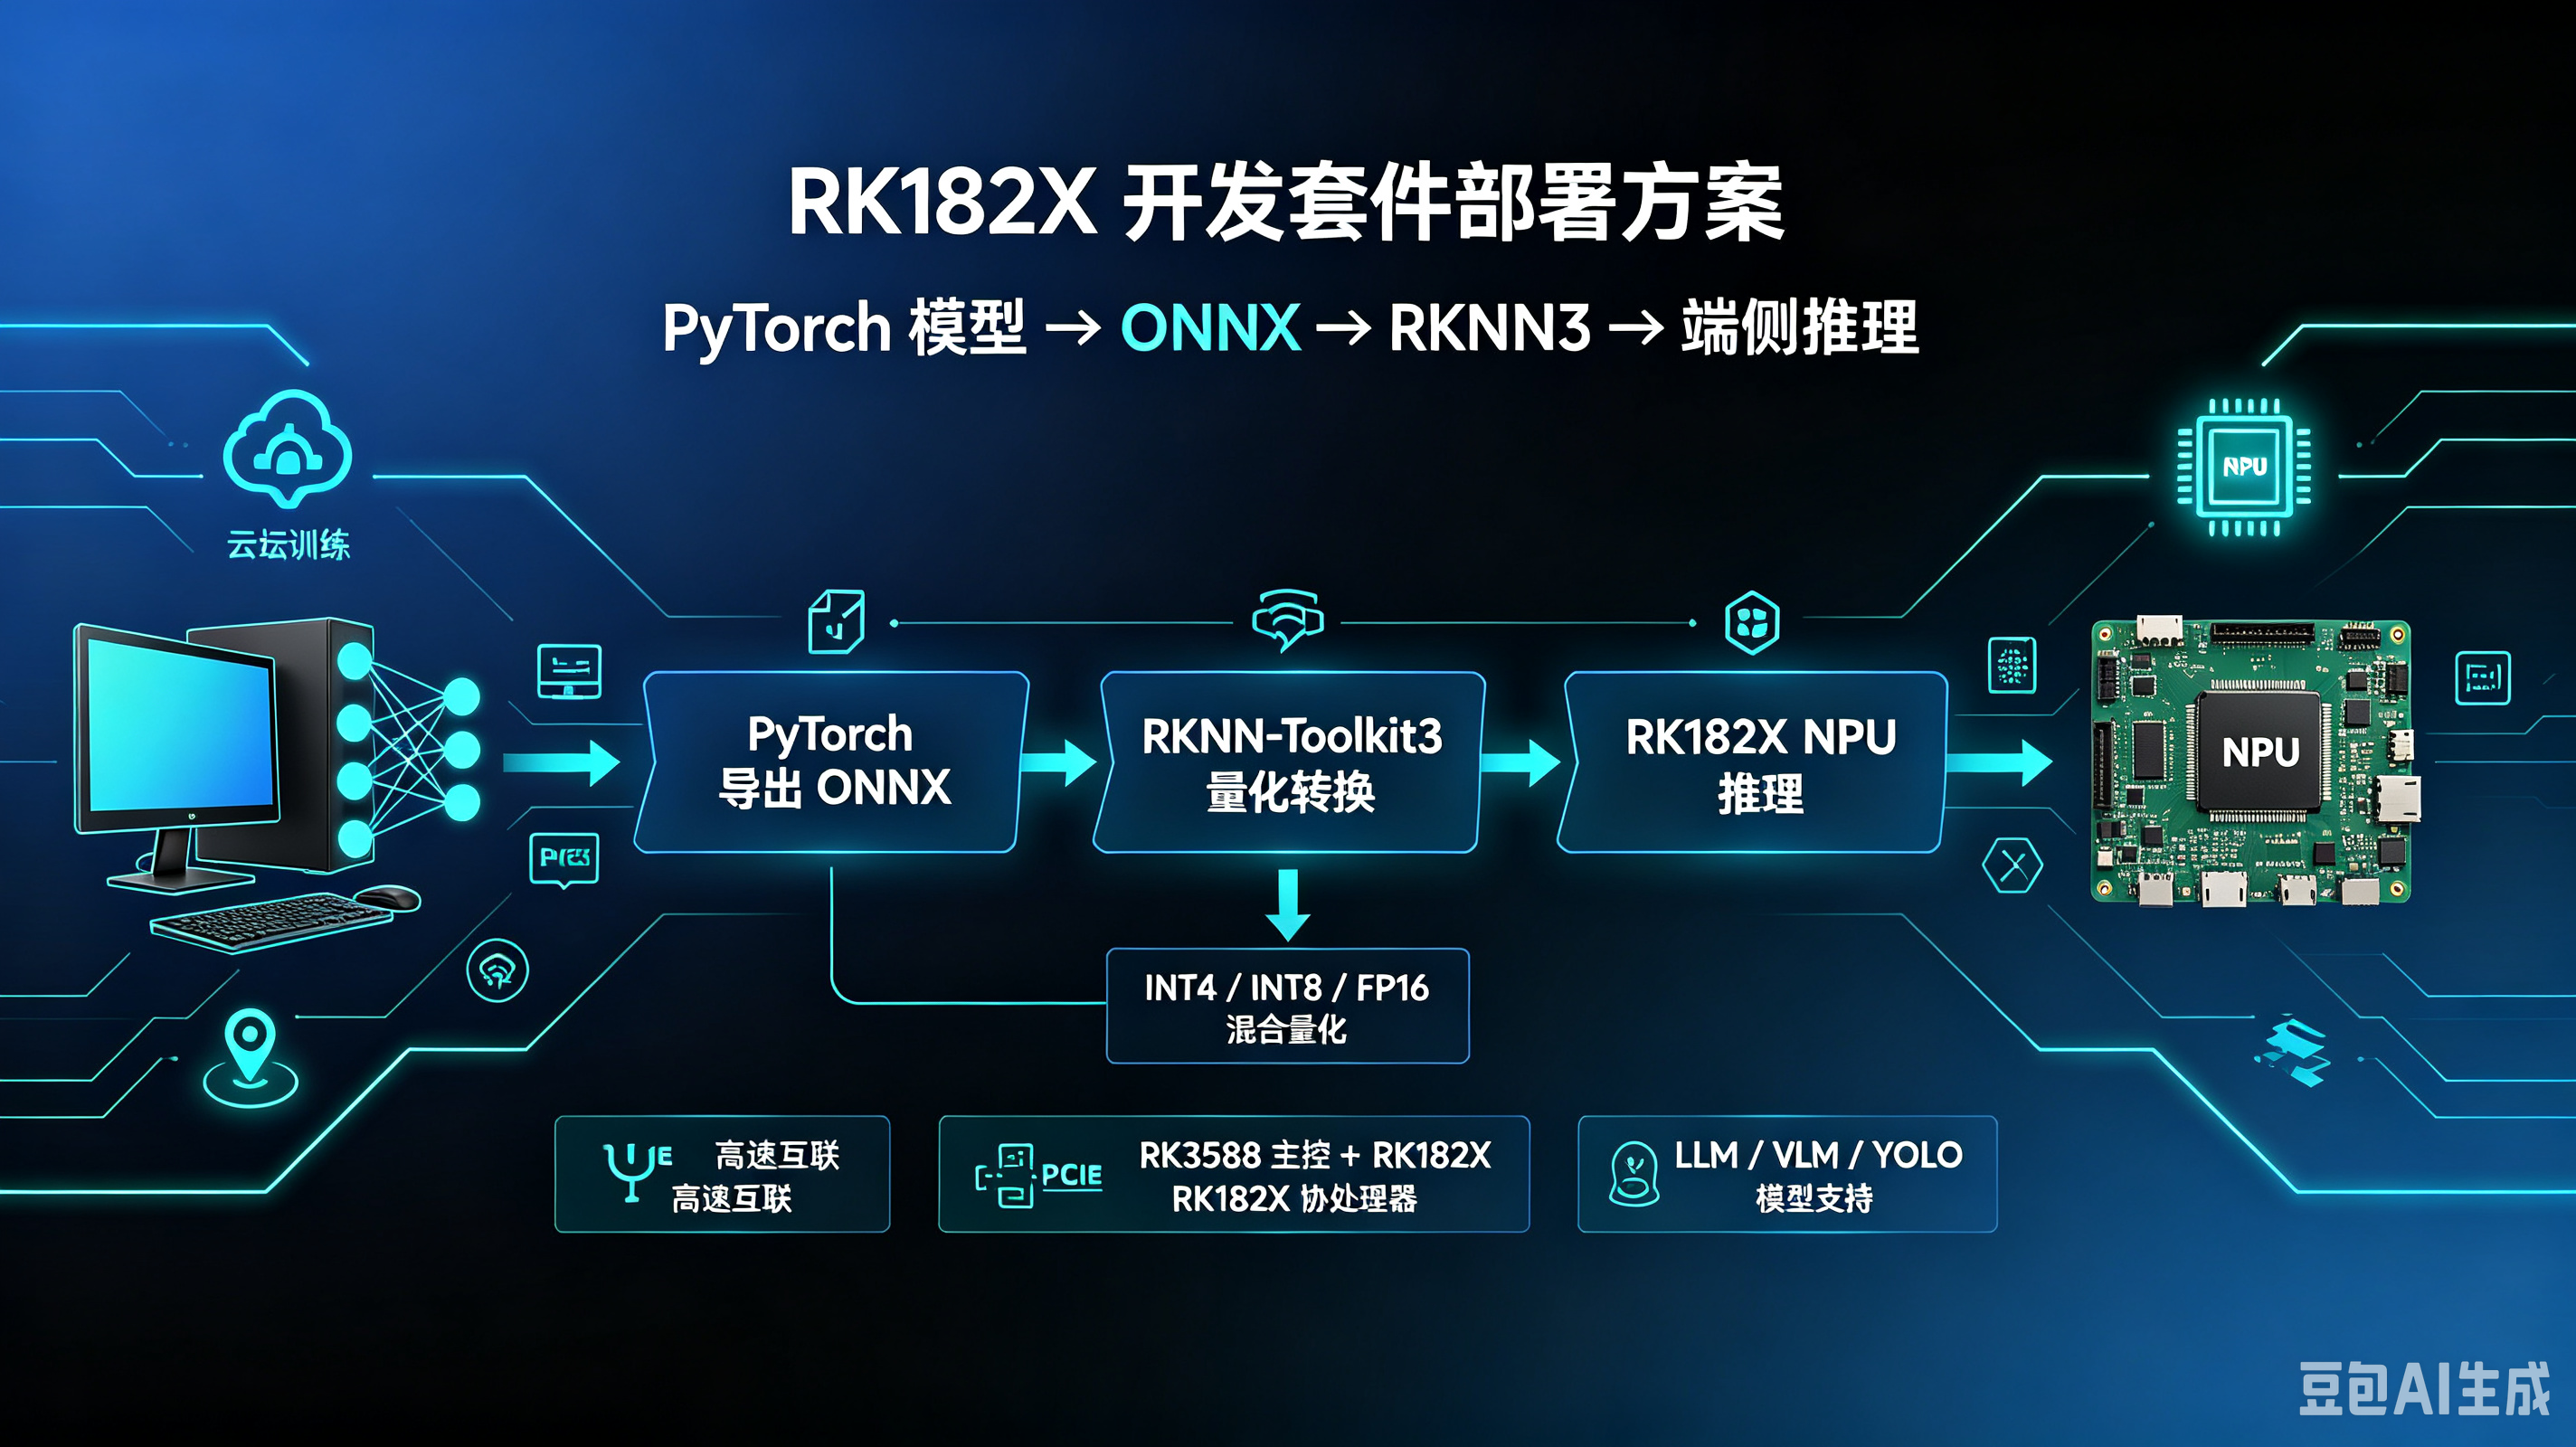
一、总体结论RK182X(RK1820/RK1828)开发套件完全支持 PyTorch 和 RKNN‑3 框架,搭配 RK3588/RK3576 主控,是当下端
一、前置硬件与方案选型(32TOPS 盒子基础说明)1. 主流 32TOPS 边缘盒硬件规格(INT8 峰值 32TOPS)分国产 NPU 方案、NVIDIA
一、硬件与方案前置说明1. RV1126B 硬件限制(部署 LLM 核心前提)主控:4Cortex-A53@1.6GHz,3TOPS INT8 NPU,支持 I
RK1828 是 RK3588/RK3576 配套 NPU 协处理器,仅支持 RKNN3 Toolkit V1.0+,PyTorch 模型必须走「PyTorch
一、测试前置说明(无水分基准条件)1. 硬件平台核心板:RK3588 EVB 8GB LPDDR4X + 32GB eMMC供电:12V/3A 稳压电源,满载稳
RK3588 采用 RKNN Toolkit2,NPU 算力 6TOPS,部署 YOLOv5 是边缘视觉高频方案,但链路长、版本兼容、后处理、量化、驱动五大类坑
环境总览硬件瑞芯微 RK3588 开发板(8nm,NPU 6TOPS,RKNN Toolkit2 适配)软件环境1. PC 端(模型转换量化):Ubuntu20
FP8 通过算力翻倍、显存 / 带宽减半、通信压缩三大核心机制,在支持混合精度与动态缩放的同时,实现大模型训练 1.3–2 倍加速,且精度损失可控。一、FP8
*













 试用申请
 产品咨询
 在线客服
 回到顶部