


一、背景:边缘算力的痛点——单卡算力瓶颈,整机方案太贵
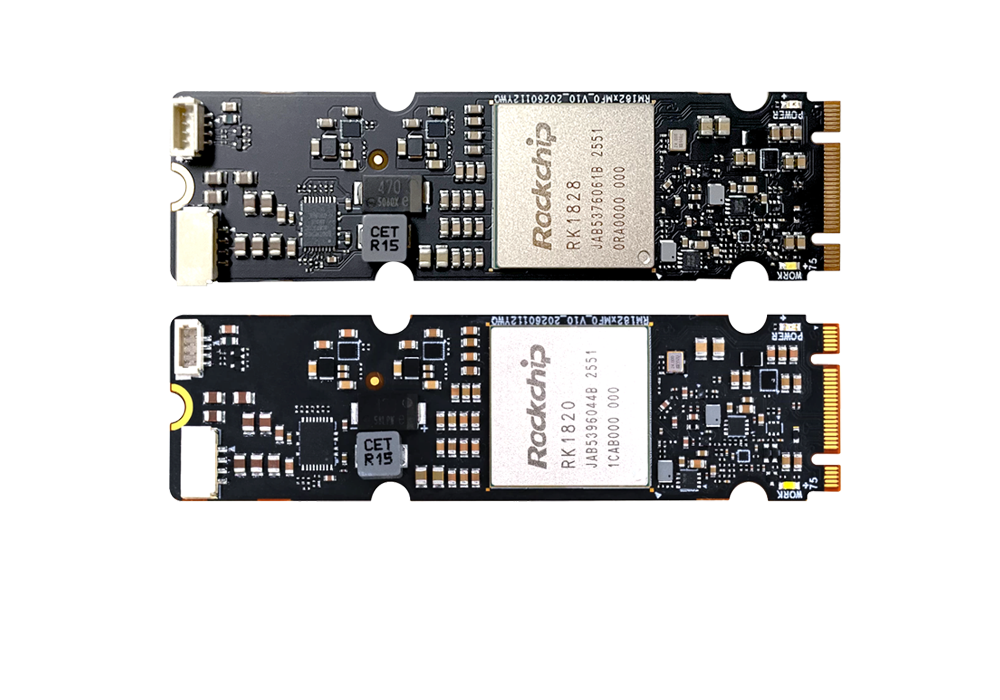
传统边缘AI部署大多采用单M.2算力卡(LQ50、BM1684X、BM1688、RK1828这类M.2 2280形态NPU),优点是体积小、功耗低;但短板很明显:
1. 单卡算力有限,多路视频分析、多模态大模型推理任务容易跑满;
2. 主板原生M.2插槽数量极少,一般最多2~4个,扩容必须换主板/整机;
3. 不同品牌NPU(算能、力擎、瑞芯微)硬件接口都是M.2,但原生无法统一调度,算力孤立,不能池化;
4. 工业服务器、AI一体机整机方案成本高,小项目、试点场景预算压力大。
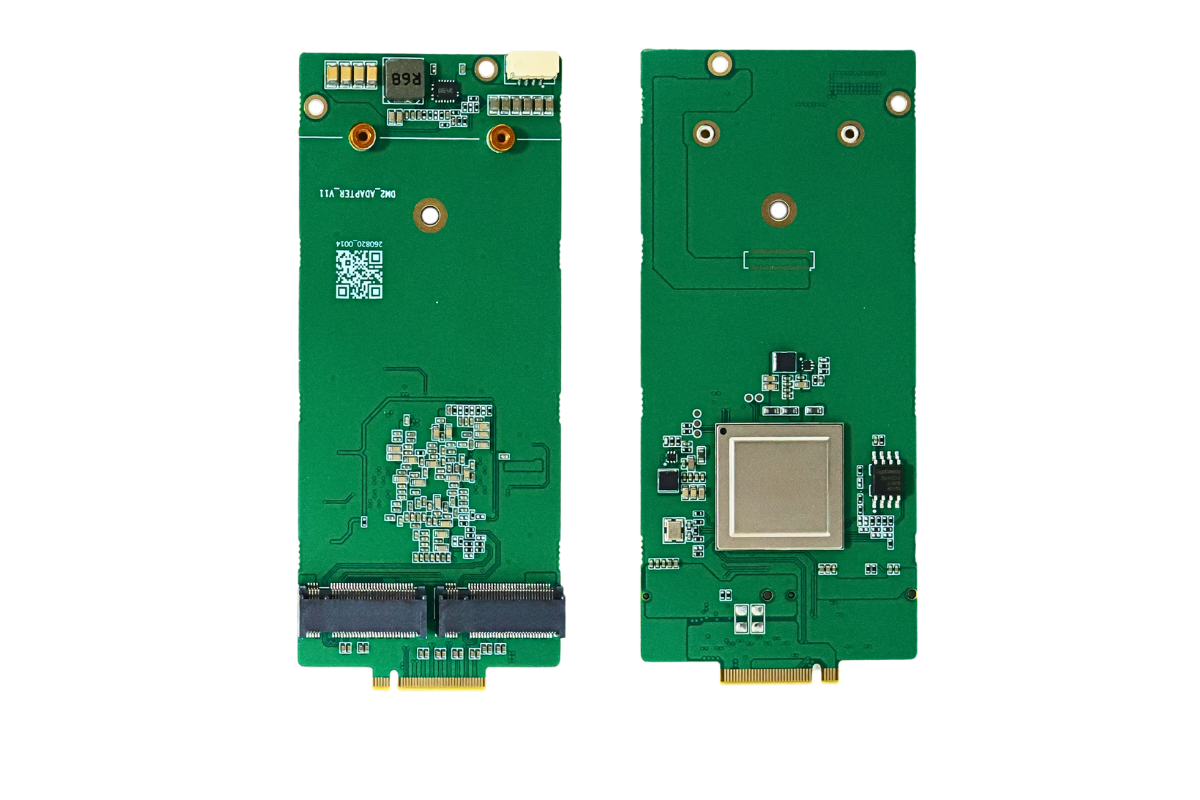
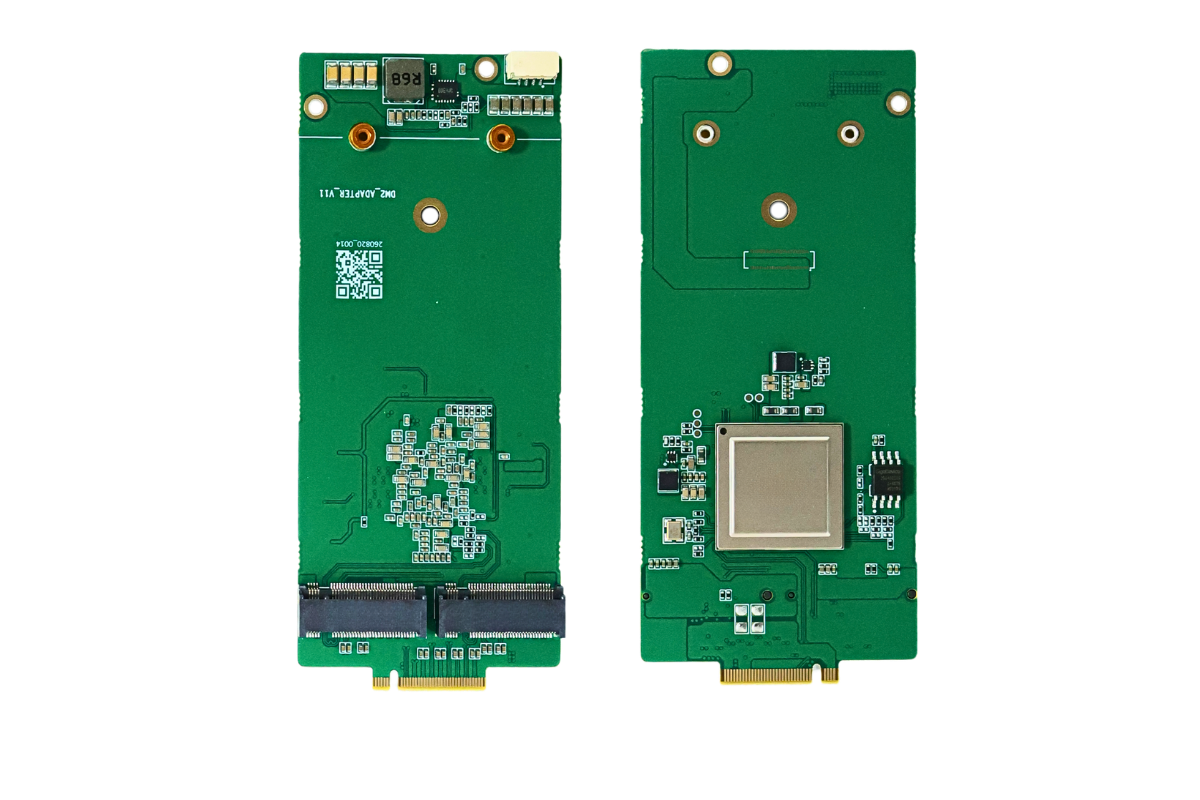
PCIe Switch背板就是解决这个问题的核心:不用更换主机,通过PCIe交换芯片扩展M.2插槽,把多张M.2算力卡接入同一主机,实现异构多卡算力池,低成本搭建小型边缘算力集群。
二、方案原理:PCIe Switch 背板架构
PCIe Switch本质是PCIe总线的"交换机":
上游:1路PCIe信号接入主机CPU/SoC;
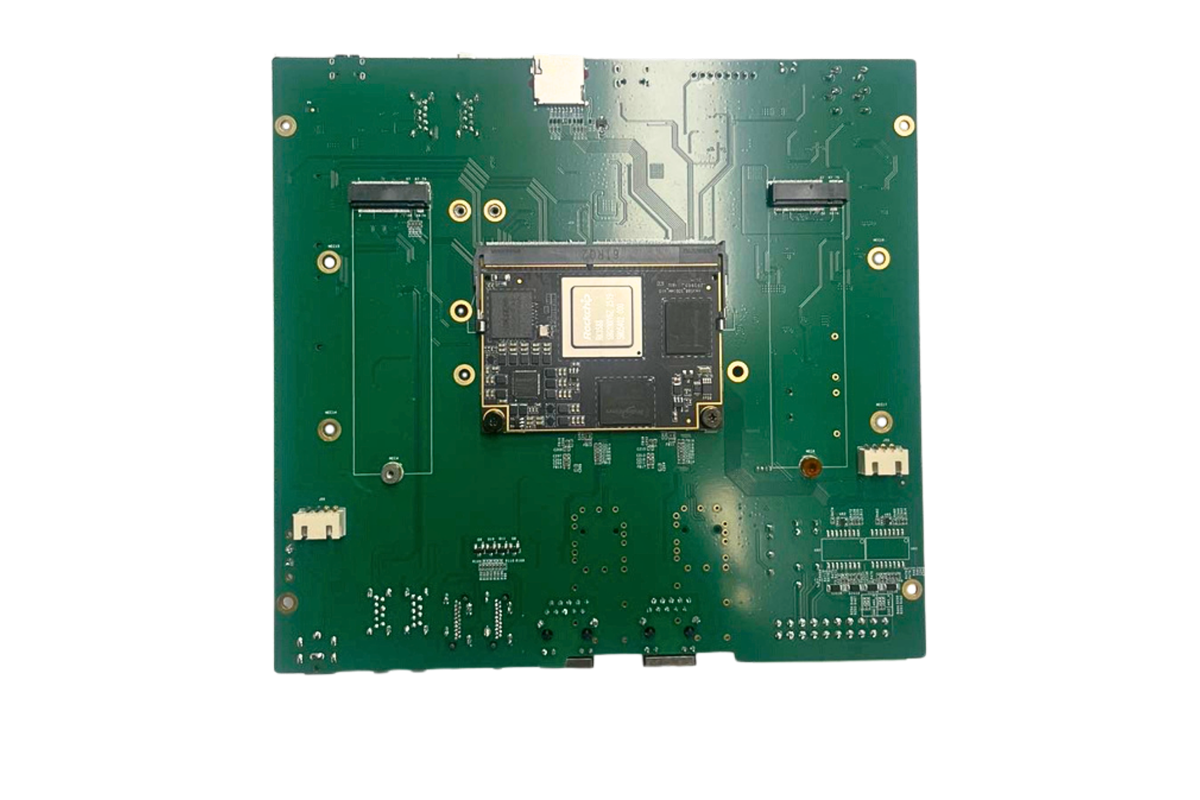
下游:扩展多路PCIe通道,引出多个M.2 2280插槽,直插M.2 NPU算力卡;
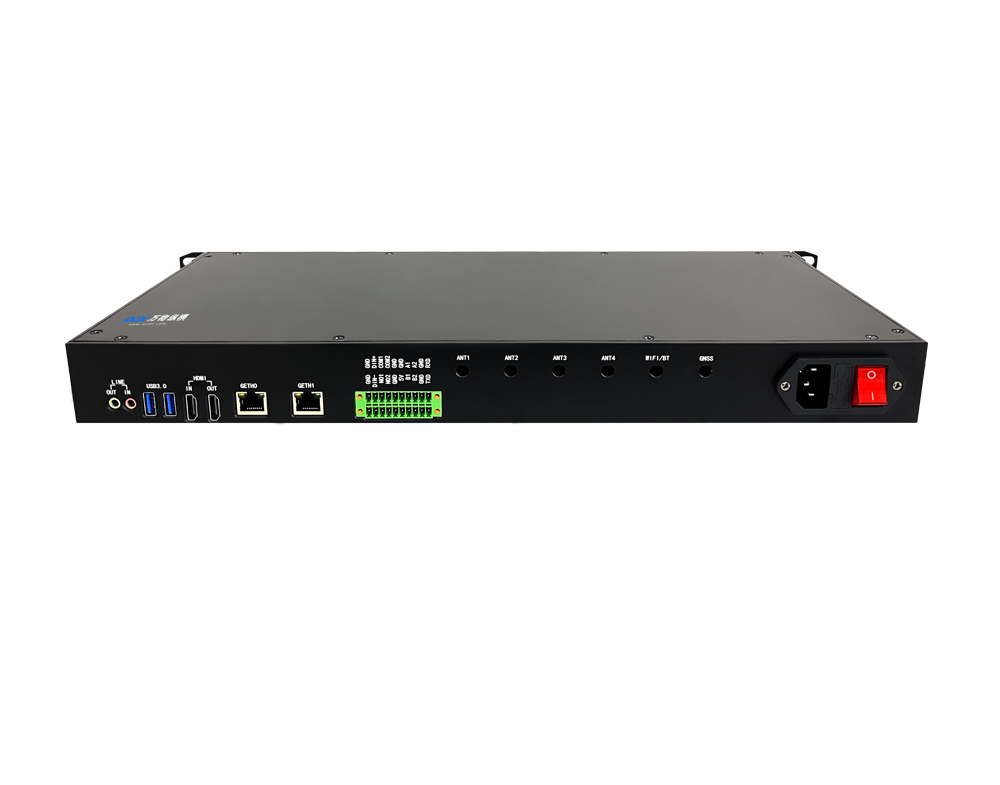
背板集成供电、信号均衡、热插拔保护,适配工业边缘场景。
支持异构混插:同背板可同时搭载力擎LQ50、算能BM1684X、BM1688等不同NPU,硬件层面全部挂载到同一主机PCIe域,上层框架做算力调度。
架构优势
1. 扩容灵活:单Switch可扩展4/8/16路M.2,按需插卡,不用一次性满配;从1卡起步,后续按需增加算力卡,平滑升级;
2. 复用现有主机:基于x86工控机、国产信创主板(麒麟V10)均可接入,不用采购昂贵多槽位服务器;
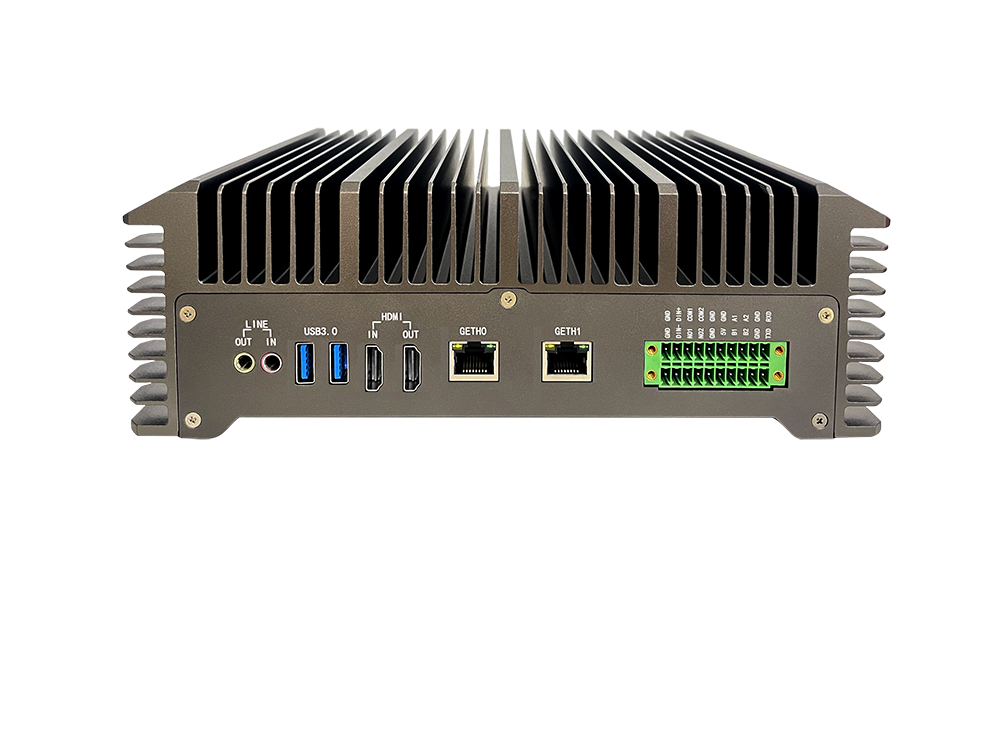
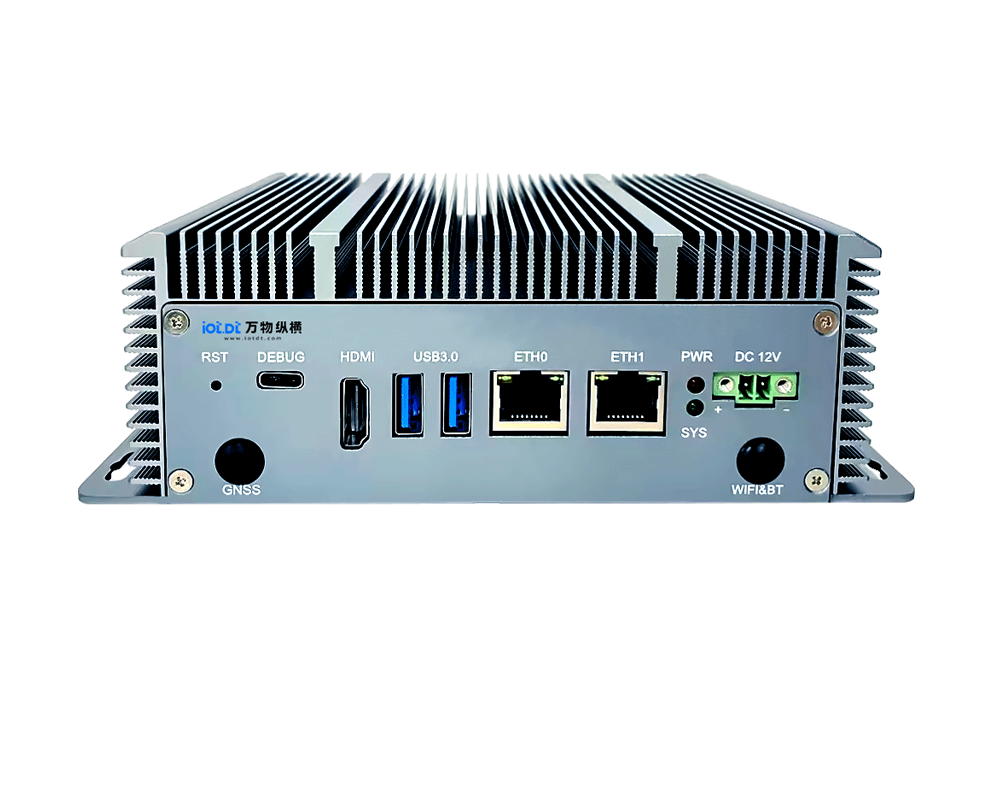
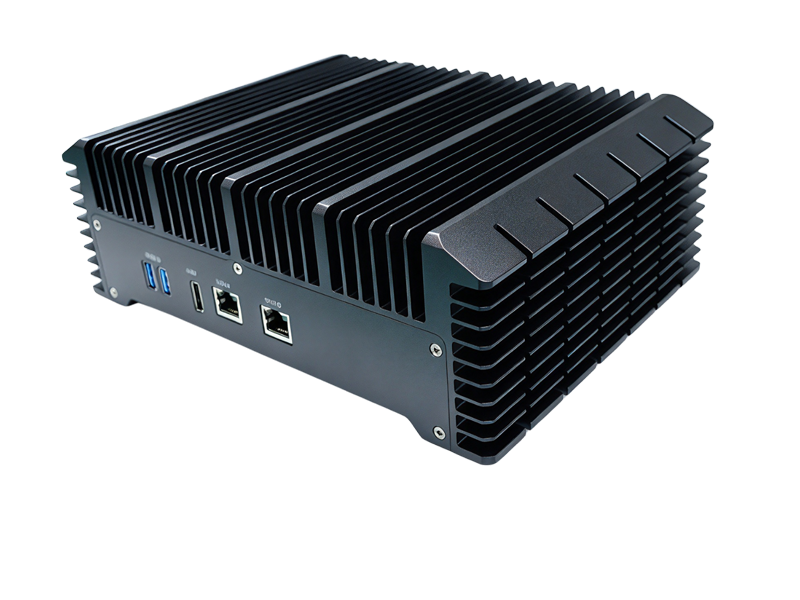
3. M.2形态优势:M.2算力卡无独立散热机箱,体积紧凑,背板+多卡可塞进AI算法盒子、小型工控箱;功耗低,整机功耗远低于标准PCIe全高算力卡集群;
4. 异构池化:不同NPU各司其职,比如BM系列负责视频编解码+目标检测,LQ50负责大模型/多模态推理,算力统一调度,任务分流。
三、软硬件层:多卡异构池化实现思路
硬件层
PCIe Switch背板:选PCIe 3.0/4.0版本,根据带宽需求选型;边缘场景AI推理PCIe3.0带宽基本够用,成本更低;
M.2算力卡:统一M.2 2280 Key-M,不同品牌NPU混插;
供电与散热:背板集中供电,搭配整机风道,M.2卡被动/薄型散热片,满足7×24h边缘持续运行;
整机形态:嵌入式箱体、壁挂工控箱,适配智慧工地、明厨亮灶、园区低空安防等边缘现场。
软件层(算力池化)
1. 驱动:各NPU原厂驱动独立部署,主机识别到多张独立PCIe设备;
2. 调度层:自研/开源调度中间件,把多张异构NPU封装成统一算力池:
任务分片:视频流、LLM推理任务分发到空闲NPU;
负载均衡:自动识别各卡负载,避免单卡过载;
故障隔离:单张算力卡异常,自动切走任务,集群继续运行;
3. 上层应用:算法服务、多模态推理、视频分析业务直接调用算力池,无需关心底层是哪款NPU。
四、成本对比:单卡 → PCIe Switch M.2集群
方案 | 可部署算力卡数量 | 硬件成本 | 体积 | 适用场景 |
原生主板M.2单卡/双卡 | 1~2 | 低 | 很小 | 少量视频、轻量推理 |
原生主板多M.2(高端工控板) | 最多4 | 中高 | 中等 | 小规模试点,扩容受限 |
PCIe Switch M.2异构集群 | 4~16,按需插卡 | 中等 | 小型箱体 | 多路视频+大模型混合边缘业务,可平滑扩容 |
标准机架PCIe算力卡服务器 | 8+ | 高 | 机架式机房 | 中心机房,不适合现场边缘部署 |
核心亮点:按算力付费,按需增卡。项目初期只插2张卡,后期业务量上涨,直接在背板插槽新增M.2算力卡,不用更换主机、机箱。
五、适用落地场景
1. 智慧安防:多路摄像头视频结构化、烟火/安全帽识别,多卡分担视频解码+AI推理;
2. 本地多模态Agent:边缘端本地大模型+视觉检测,异构分工,LQ50跑LLM/VL,BM系列做视觉分析;
3. 明厨亮灶、智慧工地、园区边缘节点:现场部署,不需要回传云端,低延迟;
4. 信创边缘方案:国产主板+麒麟V10+国产M.2 NPU,PCIe Switch扩展,满足国产化要求;
5. 产品原型/算法测试集群:低成本搭建异构算力测试台,快速验证算法在不同NPU上的性能。
六、需要注意的工程坑点
1. PCIe带宽瓶颈:多路高吞吐场景(大量4K视频)要核算每个下游端口带宽,避免Switch带宽拥塞;
2. 异构调度难度:不同厂商NPU编程接口不一样,池化调度开发工作量高于同品牌多卡;
3. 散热:高密度满配M.2卡时热量集中,箱体风道设计必须做好;
4. 信号完整性:背板走线质量差时,高速PCIe信号容易丢包、识别不稳定,工业场景优先选成熟背板方案;
5. 驱动兼容性:信创系统下,要提前验证PCIe Switch与各款M.2 NPU驱动兼容性。
七、总结
M.2算力卡 + PCIe Switch背板是当前小型边缘算力集群性价比很高的路线。打破主板原生M.2插槽限制,支持从单卡起步、平滑扩容,还可以异构混插不同国产NPU,实现算力池化。
非常适合现场边缘部署,兼顾体积、功耗、成本,在视频分析、本地多模态推理这类场景,替代传统昂贵的边缘服务器,是中小规模边缘AI项目优选方案。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部