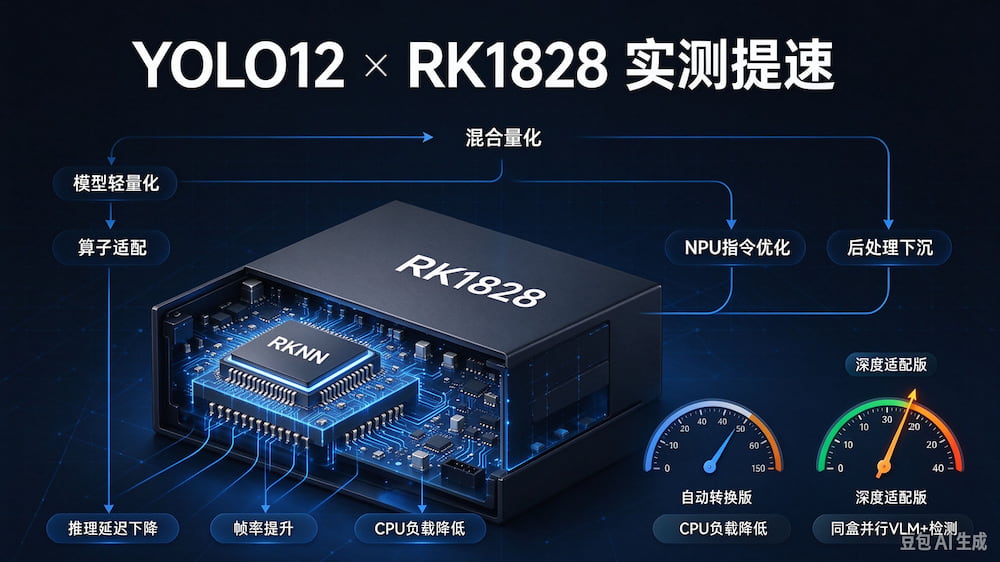
YOLO12-N(nano 轻量化版本,注意力架构 R-ELAN)完成 RKNN3 深度算子适配、混合量化优化,在 RK1828 AI 算力盒子上落地实测。相比
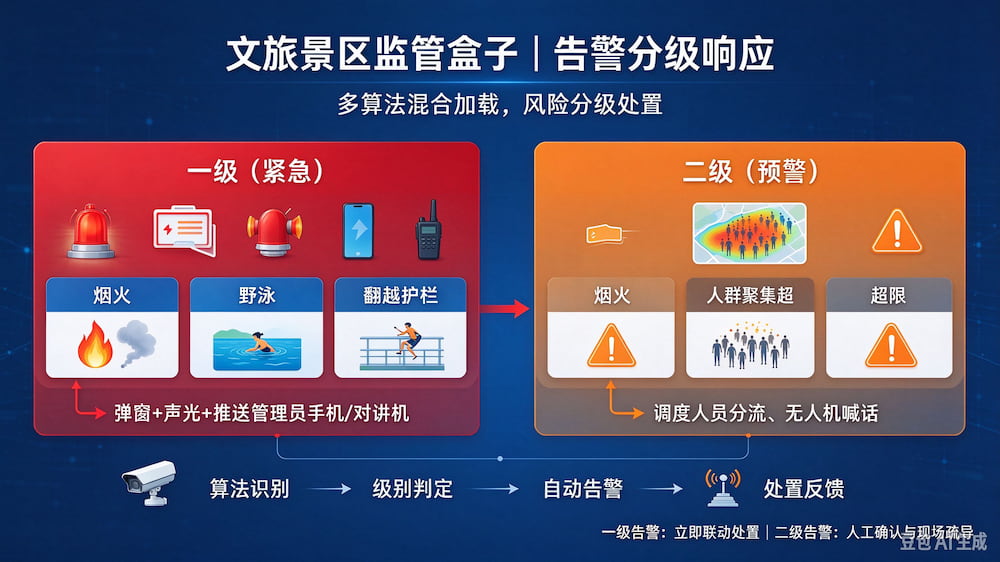
一、需求背景文旅景区旺季客流激增、点位分散、临水临崖林区多,传统监控只能事后回看,值守人力不足。当前项目明确要求单路视频流并发加载4类风险算法,边缘本地解析、秒
一、方案概述园区原有停车大多是出入口车牌机独立工作、车位靠地磁/人工巡检、消防通道、主干道占道缺少自动预警,设备分散、数据割裂,误报多、改造成本高、路面开挖麻烦
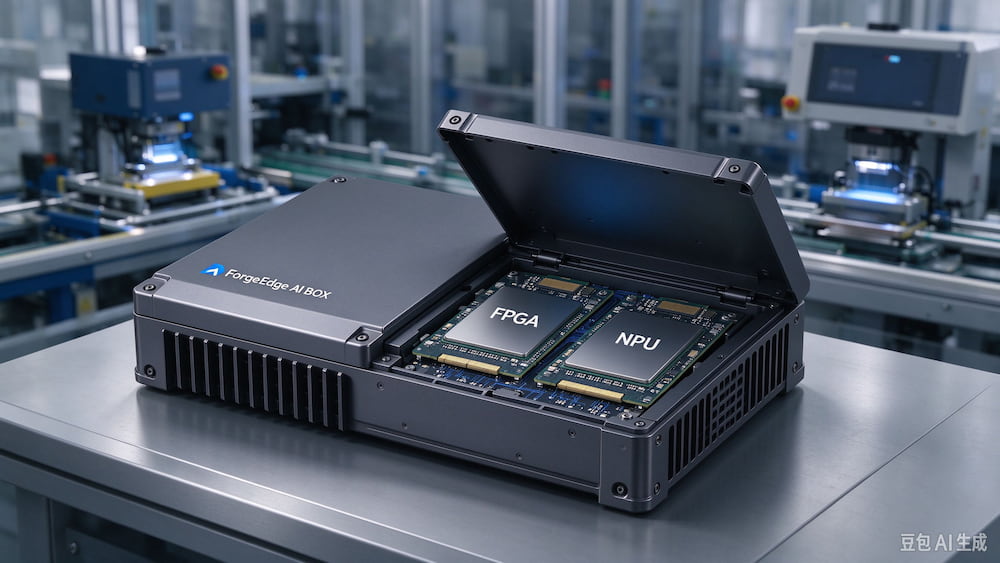
海外一款面向工业场景的模块化边缘AI盒子ForgeEdge AI Box近期流出方案细节,采用FPGA+NPU异构混合架构,主打工业产线实时视觉、传感器融合、运
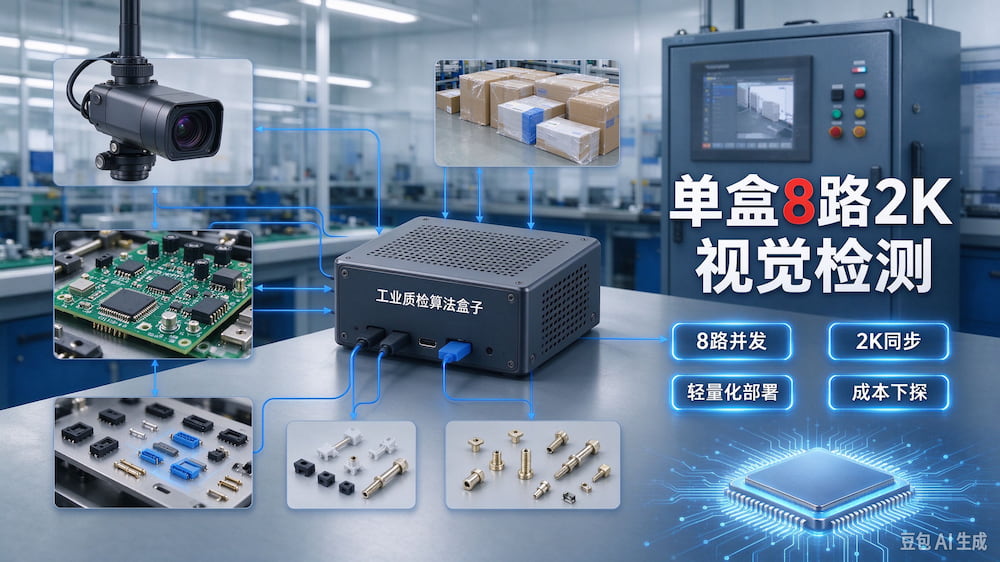
近年国产NPU芯片、模型蒸馏量化、多路解码调度技术成熟,工业AI质检正从高价工控机方案,转向轻量化边缘算法盒子路线,单盒8路2K同步视觉检测成为中小产线的主流标
随着"人工智能+制造"专项行动持续推进,工业AI进入规模化复制落地阶段,大量工厂、工地、能源站点,需要在现场完成多路视频实时AI识别,边缘算
随着智慧监管政策持续推进,明厨亮灶、智慧工地进入深度普及阶段。传统监控模式只能实现视频回看,缺少实时智能分析能力;纯云端AI方案则面临带宽成本高、网络中断就丧失
近期,端边轻量化大模型落地、云边协同架构成为行业热点,越来越多行业项目不再一味追求云端大算力,转而寻求低成本、高可靠、低功耗的本地边缘推理硬件,推动AI能力从云
2026年,AI产业正在发生明确的结构性变化:大模型不再只运行在大型智算中心,越来越多推理任务向边缘侧迁移,本地私有化部署、低时延响应、原始数据不出现场,成为工
随着大模型产业从云端走向边缘侧,本地私有化部署、低时延推理、数据安全可控已经成为工业物联网、智慧安防、智慧城市领域的核心诉求。四川万物纵横科技股份有限公司正式发
2026年被业内视作端侧AI规模化落地元年,轻量化大模型下沉边缘成为产业热点,越来越多项目不再将全部数据回传云端,转而追求本地推理、低时延响应、数据不出场的业务
近期,算网融合、异构算力纳管成为算力行业热点,运营商加速推进边缘算力网络落地,"算力下沉"由概念走向规模化商用,市场对全国产、高可靠工业级边
当大模型从实验室走向生产一线,"如何在工厂车间、会议室、户外点位实现安全稳定运行"成为摆在众多数字化转型企业面前的现实难题。云端大模型受网络
近日,四川万物纵横科技股份有限公司正式发布DA600系列大模型一体机,该产品基于RK3588/RK3588J芯片平台打造,创新采用主控+M.2专用算力模组异构扩
核心要点:后摩智能在10月生态大会披露,首颗 3D CIM 存算一体芯片 A20 已经投产,属于面向大模型端边推理的下一代旗舰芯片。一、架构逻辑:3D CIM
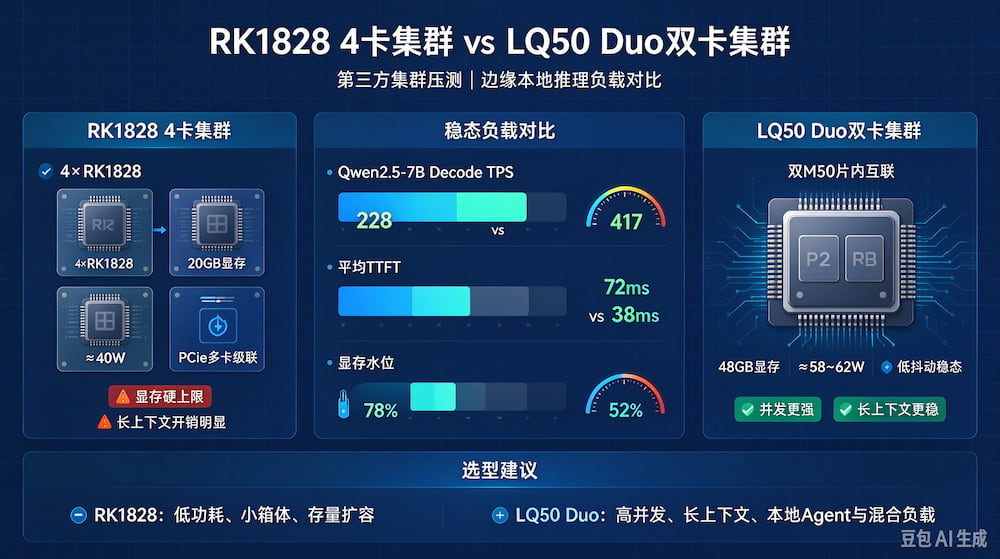
测试说明:本次为第三方独立压测,统一测试底座、模型、调度框架,聚焦边缘本地推理场景(LLM/VLM、多并发会话、持续负载稳定性、功耗、TTFT、解码 TPS、显
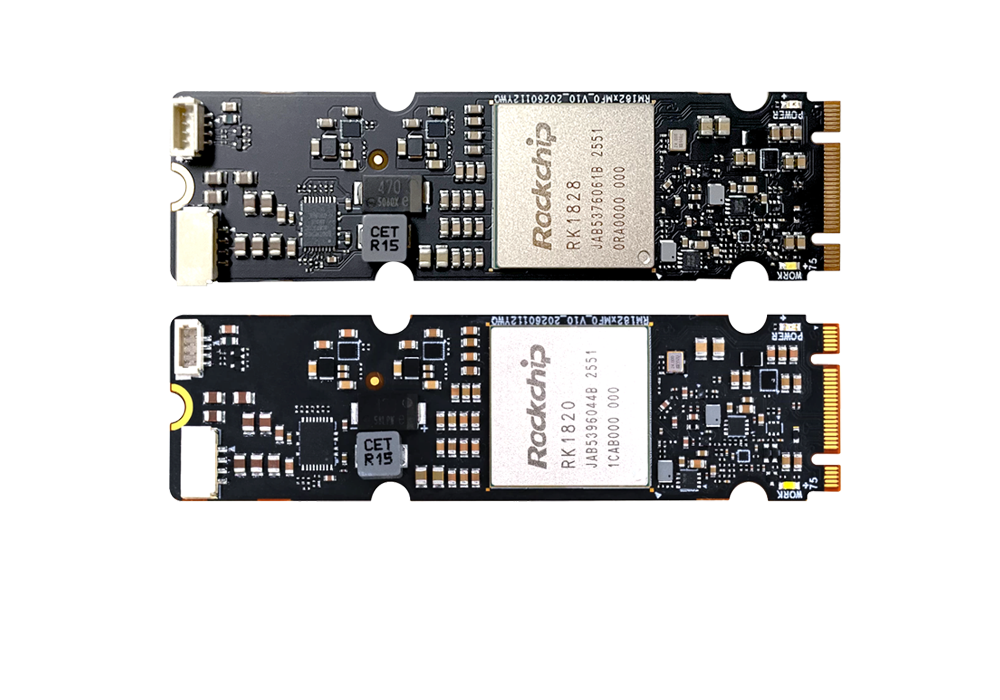
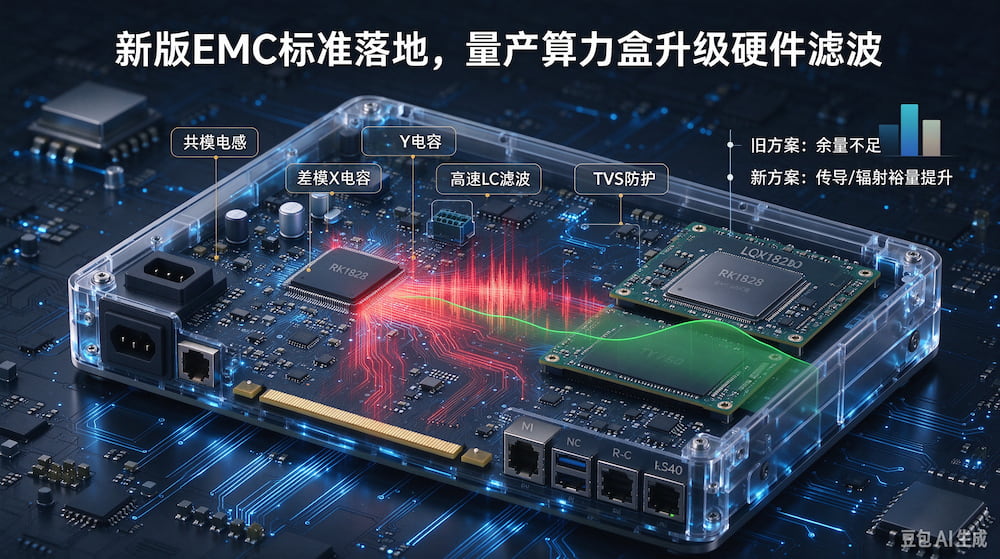
随着新版工业EMC标准收紧辐射发射限值、强化端口传导骚扰与抗扰度考核,以RK1828、LQ50(LQ50 Duo)为核心的边缘算力盒子,原有滤波方案余量不足,批
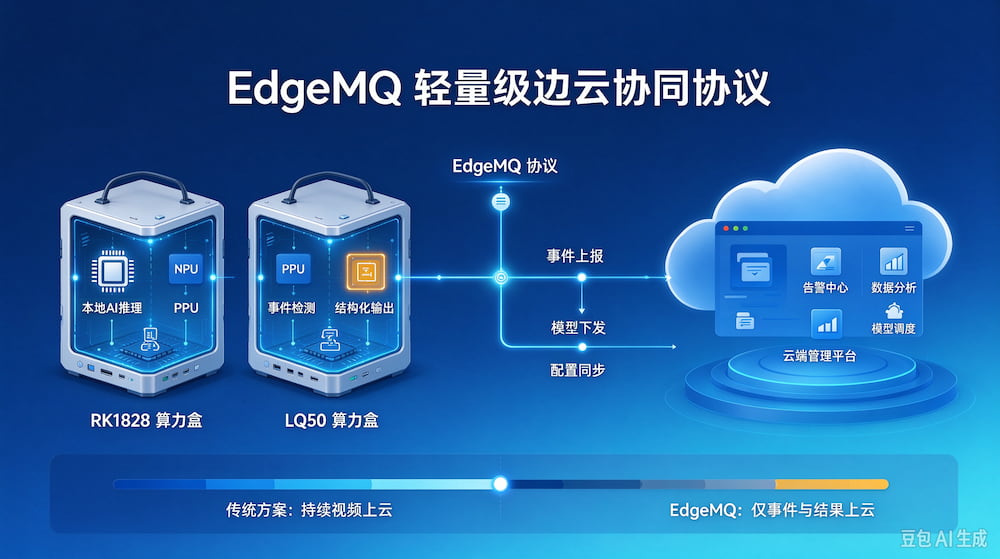
EdgeMQ 面向边缘 AI 盒子定制的轻量边云协同协议,深度适配 RK1828、LQ50 异构算力硬件,依托本地 NPU 推理 + 协议层按需上报机制,从根源
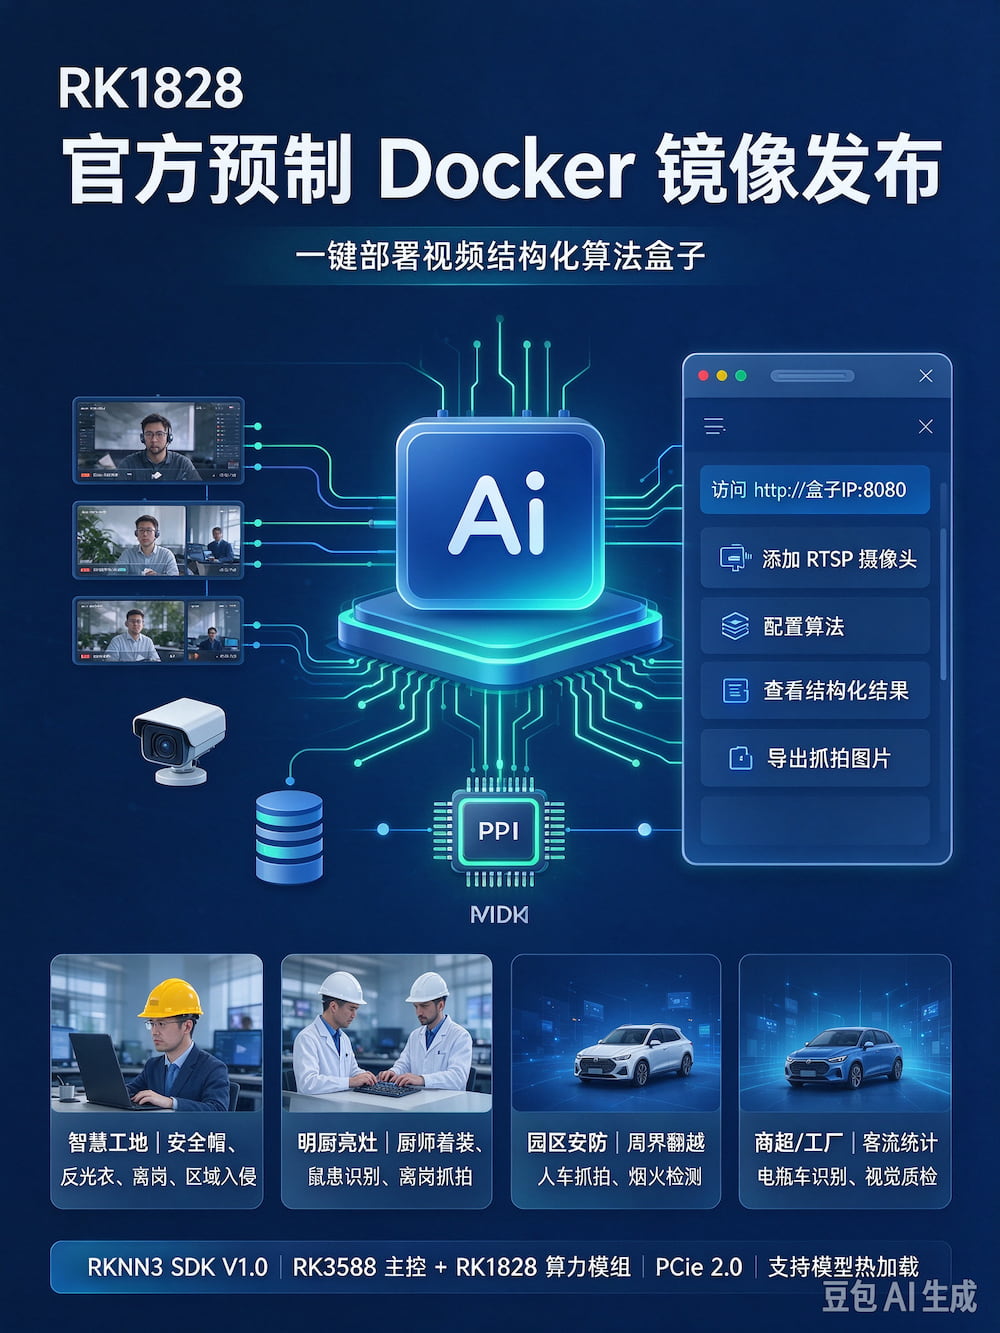
RK1828 预制 Docker 镜像正式上线,基于 RKNN3 Runtime 预编译打包,面向 RK3588/RK3576 + RK1828 PCIe 协处
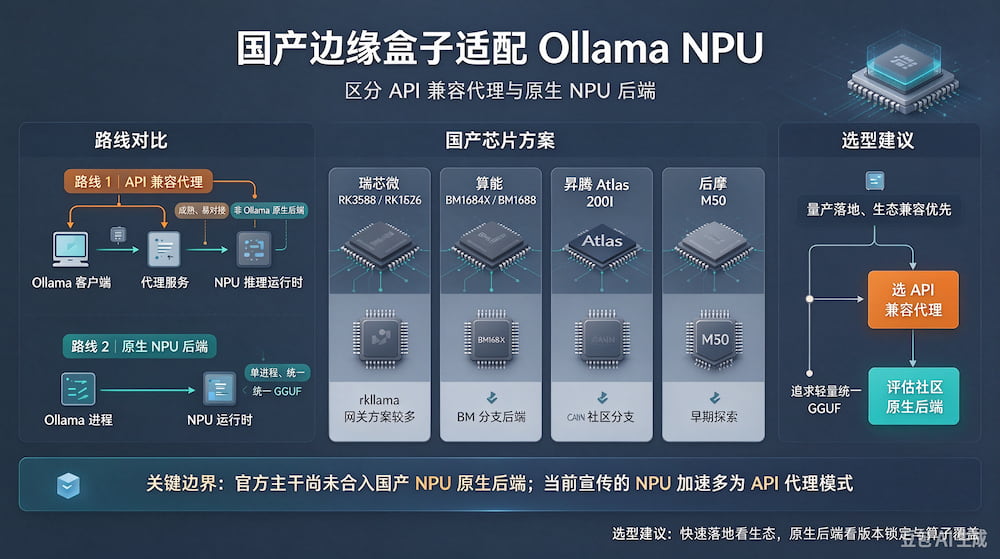
Ollama 上游官方主干目前还没有合入国产 NPU 原生后端;现在市面"适配 Ollama NPU 加速"分两类路线——兼容 API 代理
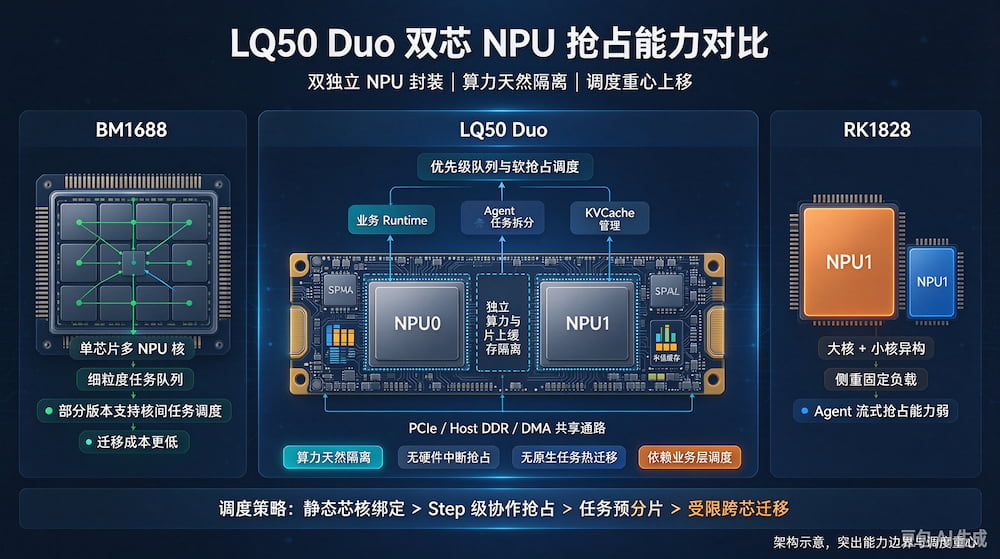
背景:LQ50 Duo 为双芯异构 NPU(两颗 LQ50),M.2 2280 形态,典型场景包括多 Agent 本地推理、多视觉 Agent + LLM Ag
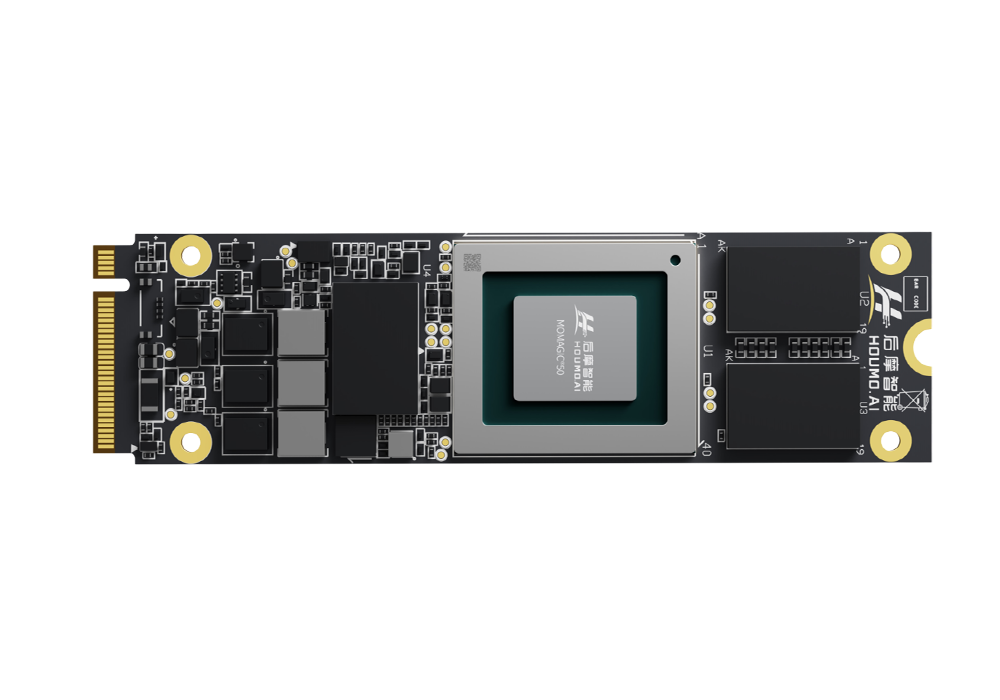
力擎LQ50 Duo是后摩智能双M50存算一体M.2算力卡,HM-Link是M50自研私有片间直连接口,用来解决同卡两颗M50、多卡级联时的张量通信瓶颈,绕开P
测试基准:OK3588-C 主控 + 4RK1828 M.2 算力卡,PCIe链路,RKNN3 SDK,流水线并行切分模型,量化方案:W4A16/G32,lm_
区别于传统Bifurcation(通道拆分)被动扩展,PCIe Switch背板靠交换芯片做独立IO扇出,不依赖主板BIOS通道拆分能力,单一路PCIe上行,扩
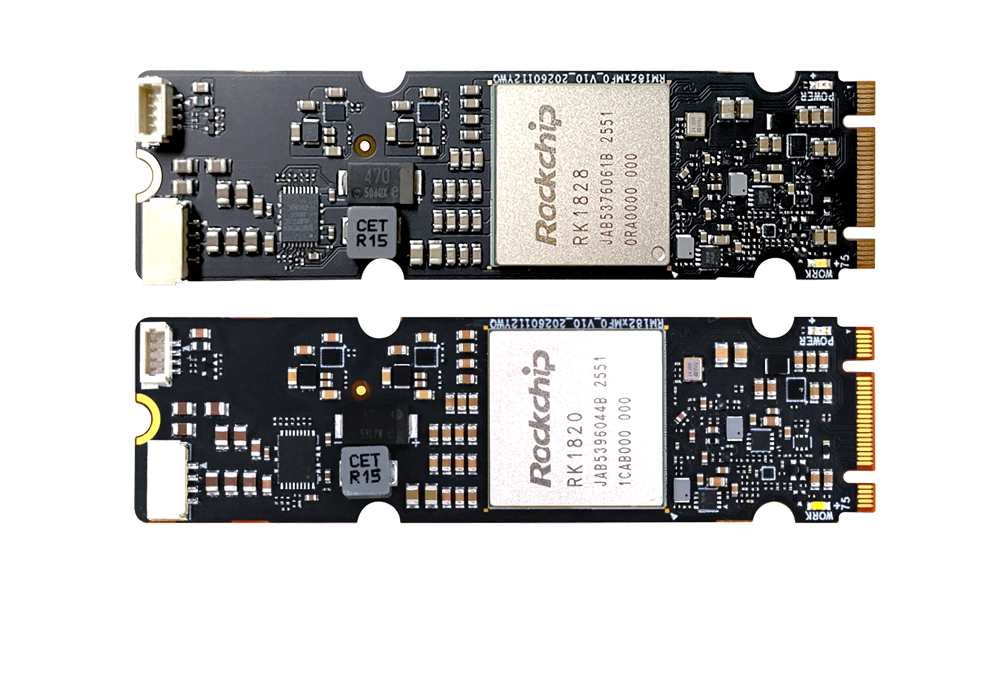
RK1828 抢成本型批量项目,LQ50 抢重模型 / Agent 长上下文项目。核心不是谁强谁弱,而是成本结构、内存池、推理瓶颈、客户诉求完全不一样。RK18
测试目标:量化 PCIe Gen4 x4 / x2 / x1、PCIe Gen3 x4 四种通道配置,对 3 款 M.2 AI 加速卡的 LLM 推理、多模态
核心背景:本地 Agent Function Call(工具调用)分为两部分:LLM推理(生成思考、判断、输出function call JSON)+ 主控侧工
*








 试用申请
 产品咨询
 在线客服
 回到顶部