端侧 AI 部署长期被困在算力不足、成本高企、内存带宽瓶颈、部署复杂四大难题中,传统方案要么依赖云端(高延迟、高成本、数据泄露风险),要么靠高端 GPU(价格昂
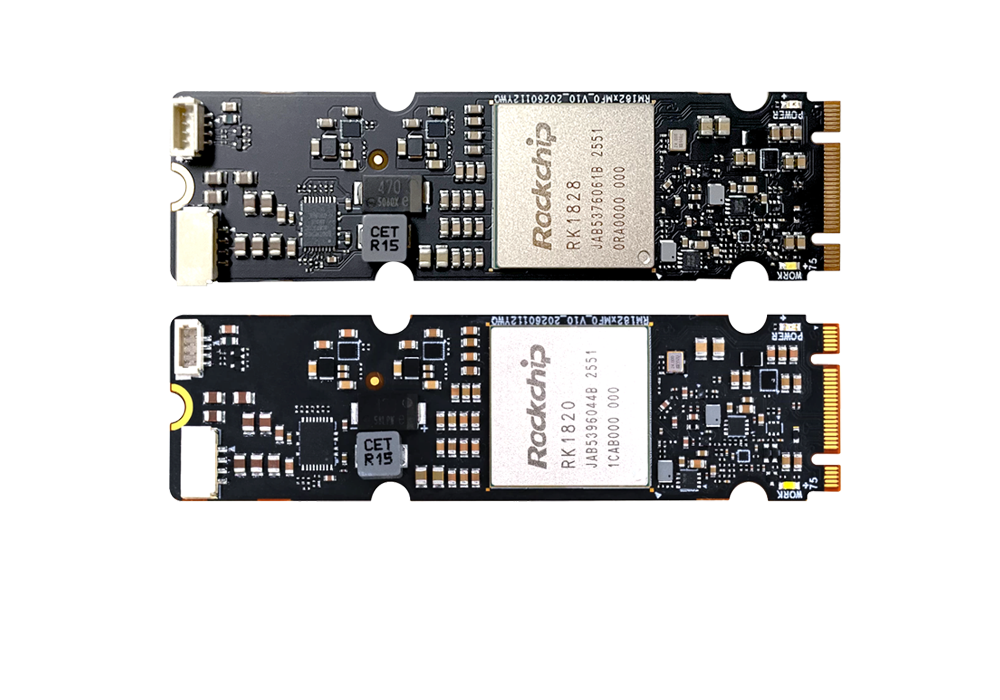
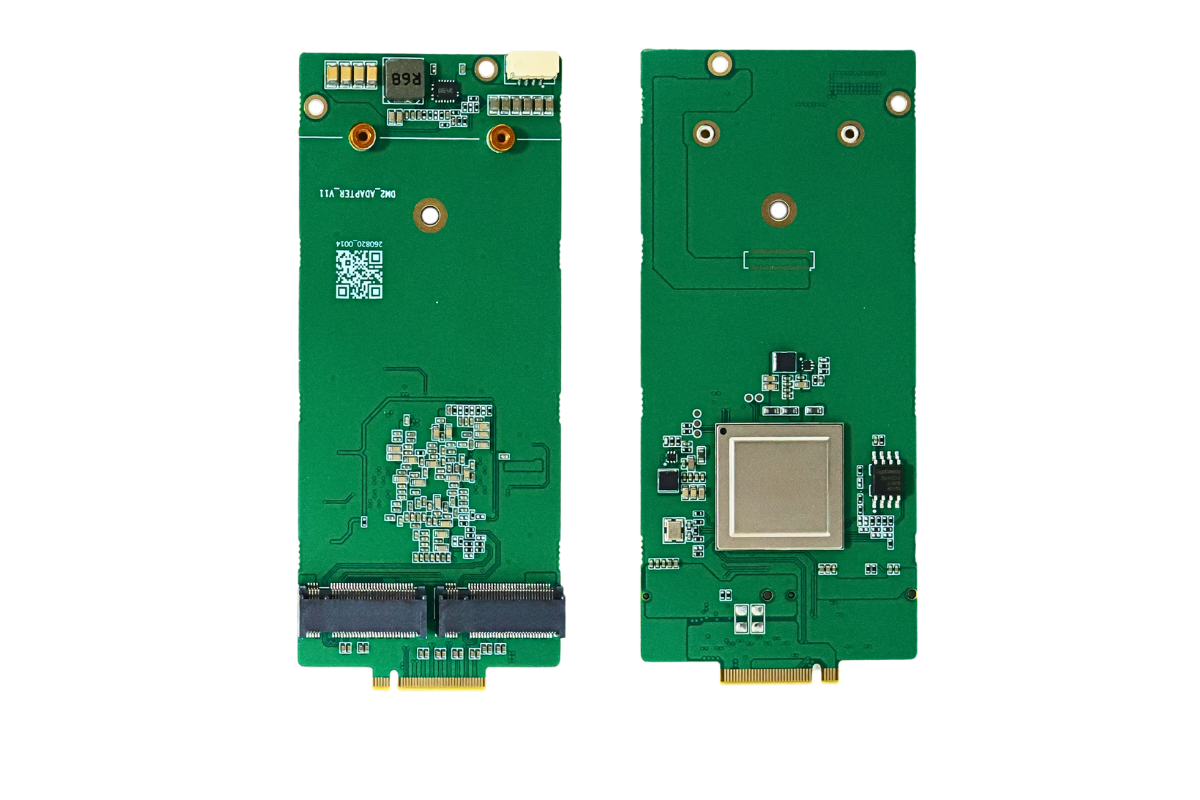
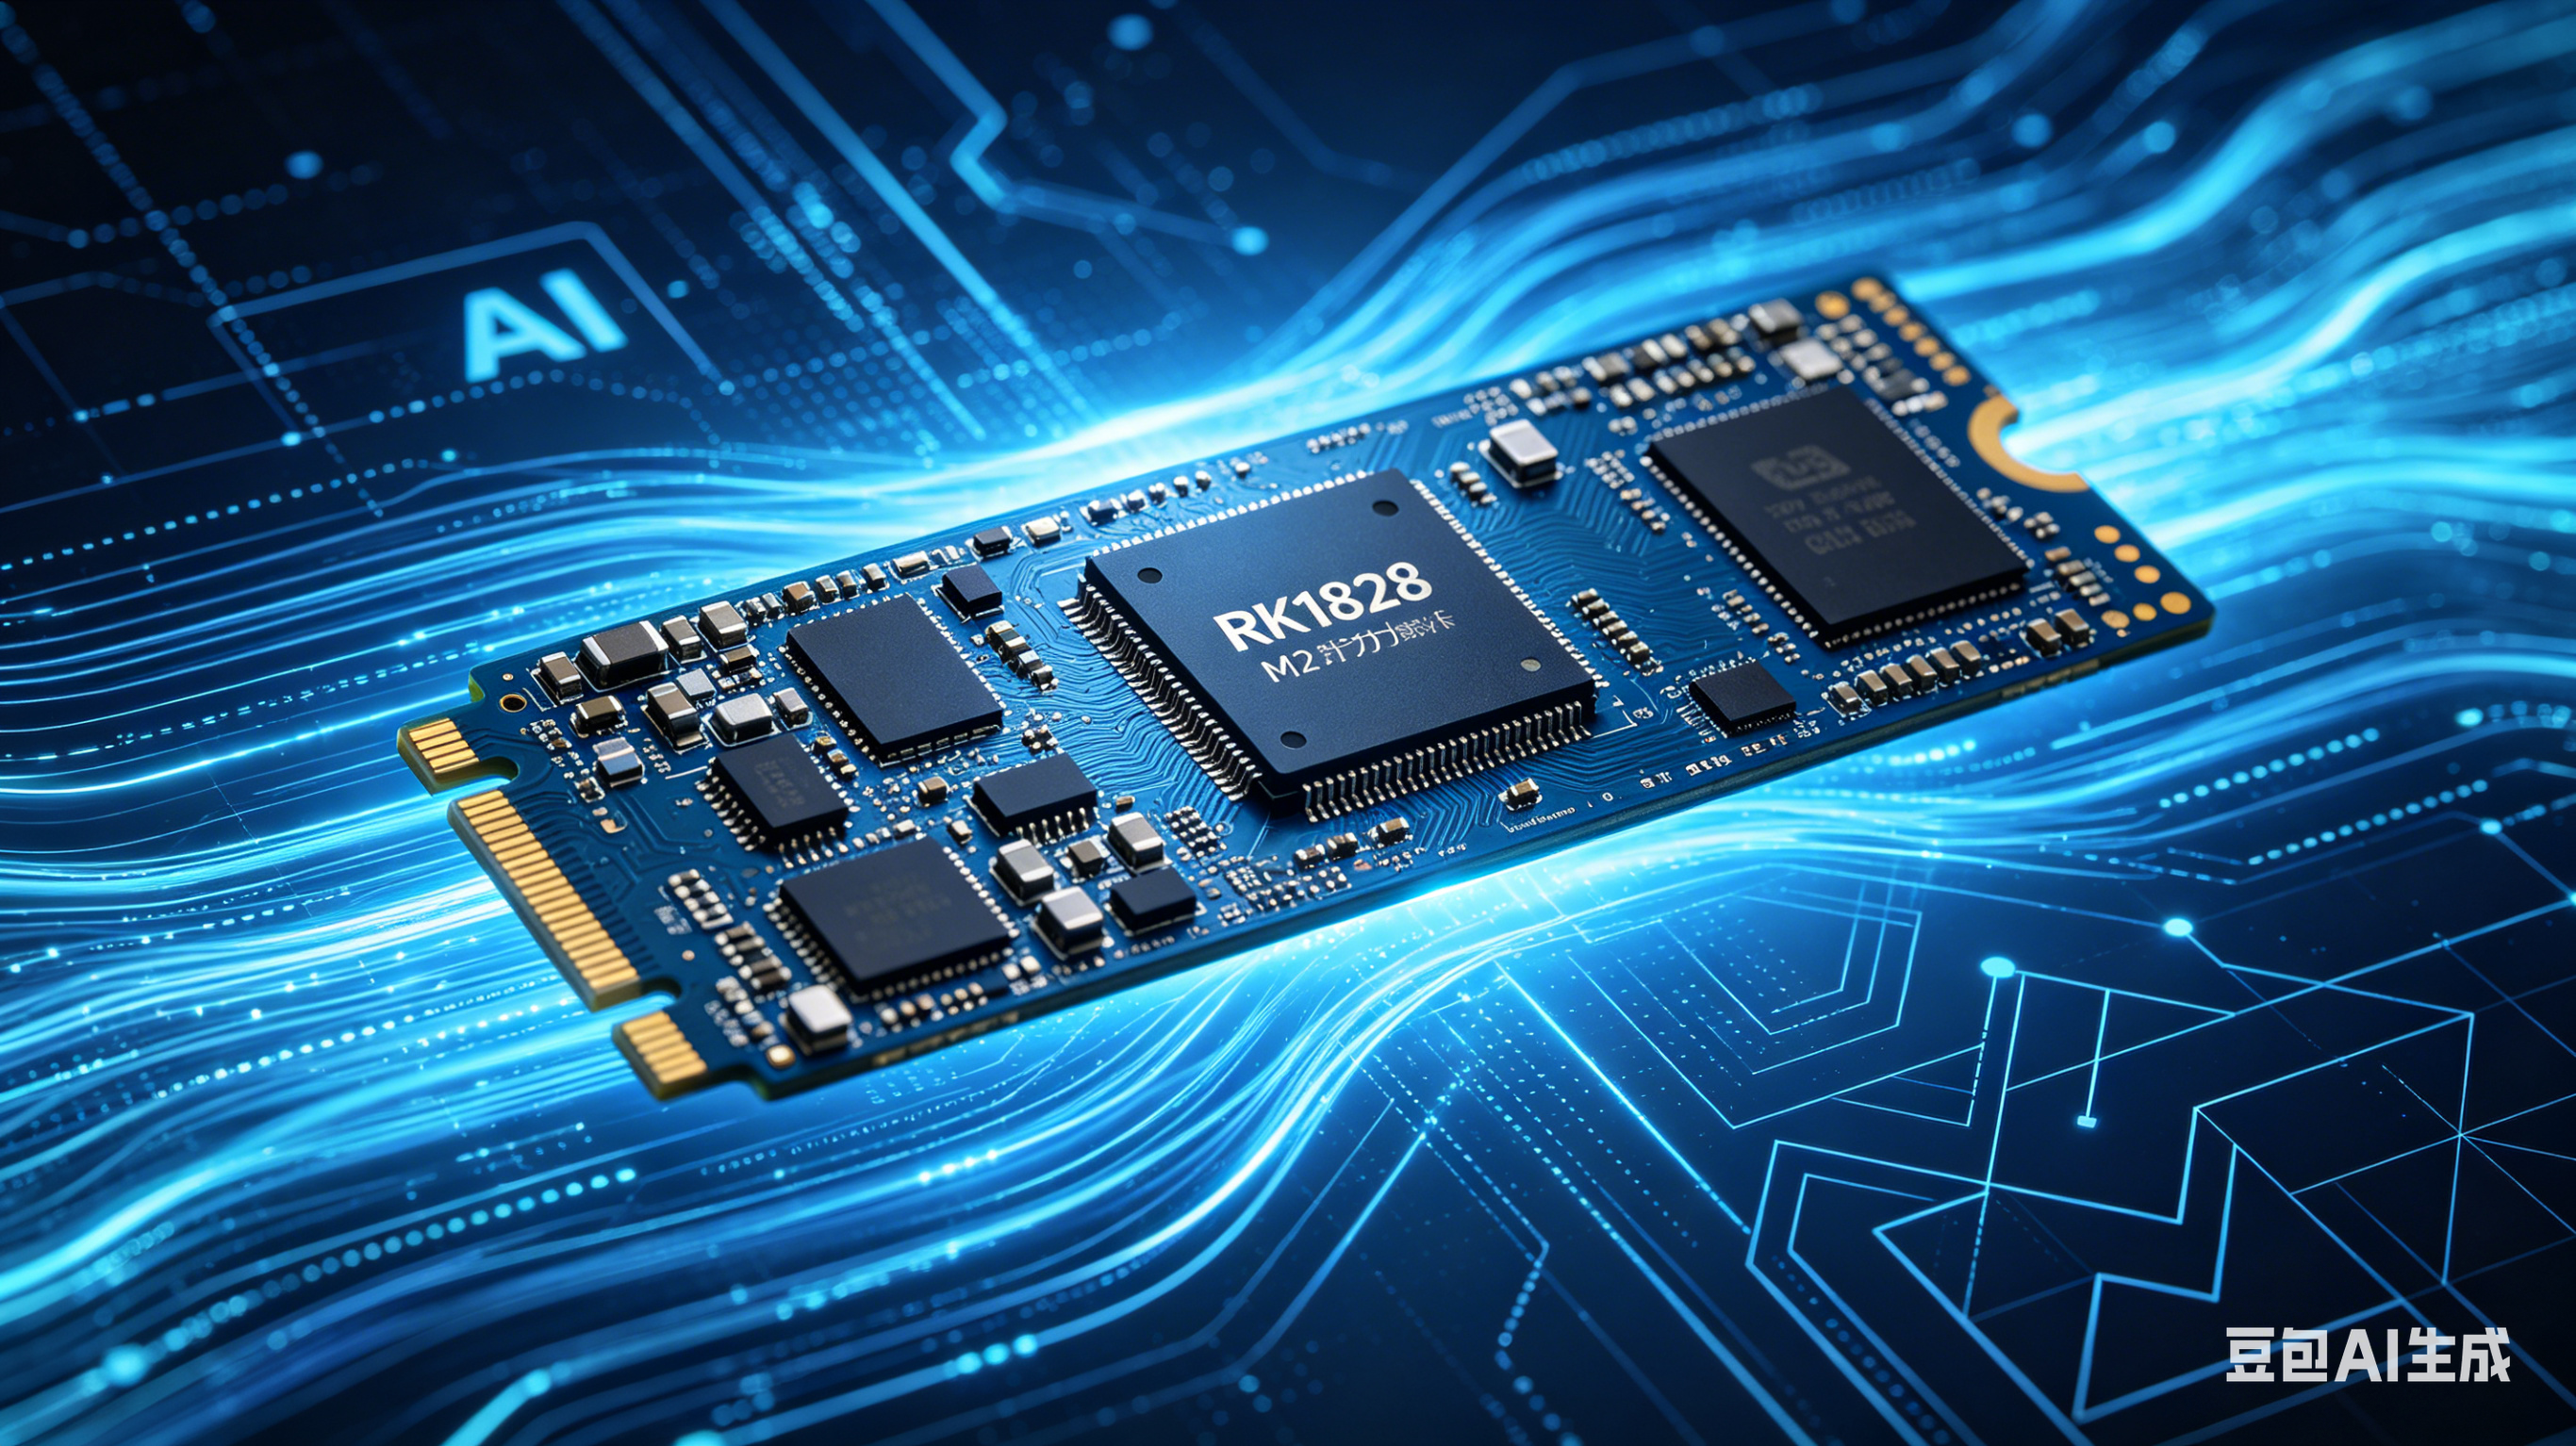
瑞芯微 RK1828 M.2 算力卡是 2025 年推出的国产边缘 AI 协处理器,以M.2 接口、20TOPS 算力、5GB 片上高带宽内存为核心,专为端侧
RK1828 M.2 是瑞芯微专为端侧 7B 大模型打造的 AI 加速卡,凭借3D 堆叠高带宽内存、NPU 专构与超低功耗,在与国际 / 国产竞品的对比中,拿下
一、先搞懂核心差异:普通板载 DRAM vs RK1828 3D 堆叠 DRAM常规 M.2 算力卡都是平面贴片 LPDDR/DDR,芯片分开放、走线长;RK1
RK1828 是瑞芯微面向 AIoT 2.0 推出的高性能 AI 协处理器,核心价值是以20TOPS 算力、5GB 3D 堆叠高带宽内存、RISC-V 多核架构
这是国产端侧 AI 的重要里程碑:瑞芯微 RK1828 作为专用大模型协处理器,首次在端侧把5GB 高带宽 DRAM 与 NPU 3D 堆叠,理论带宽1TB/s
*








 试用申请
 产品咨询
 在线客服
 回到顶部