
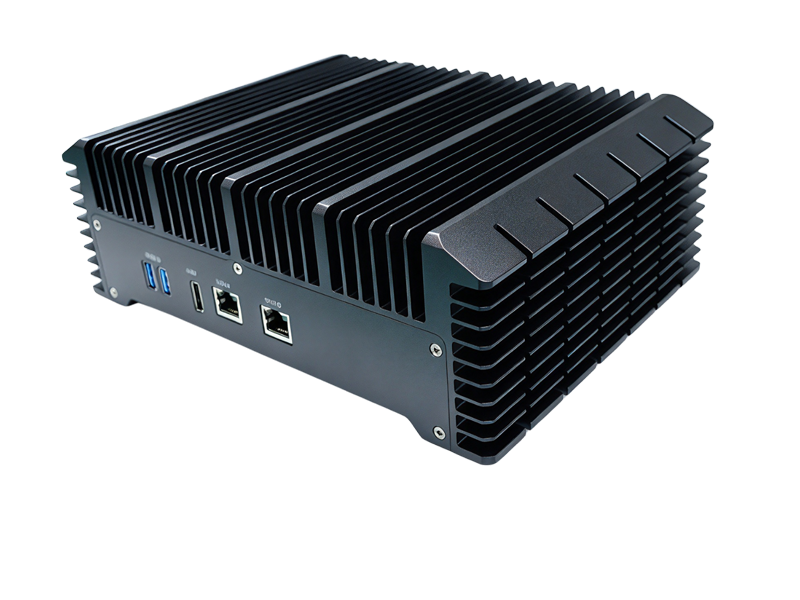
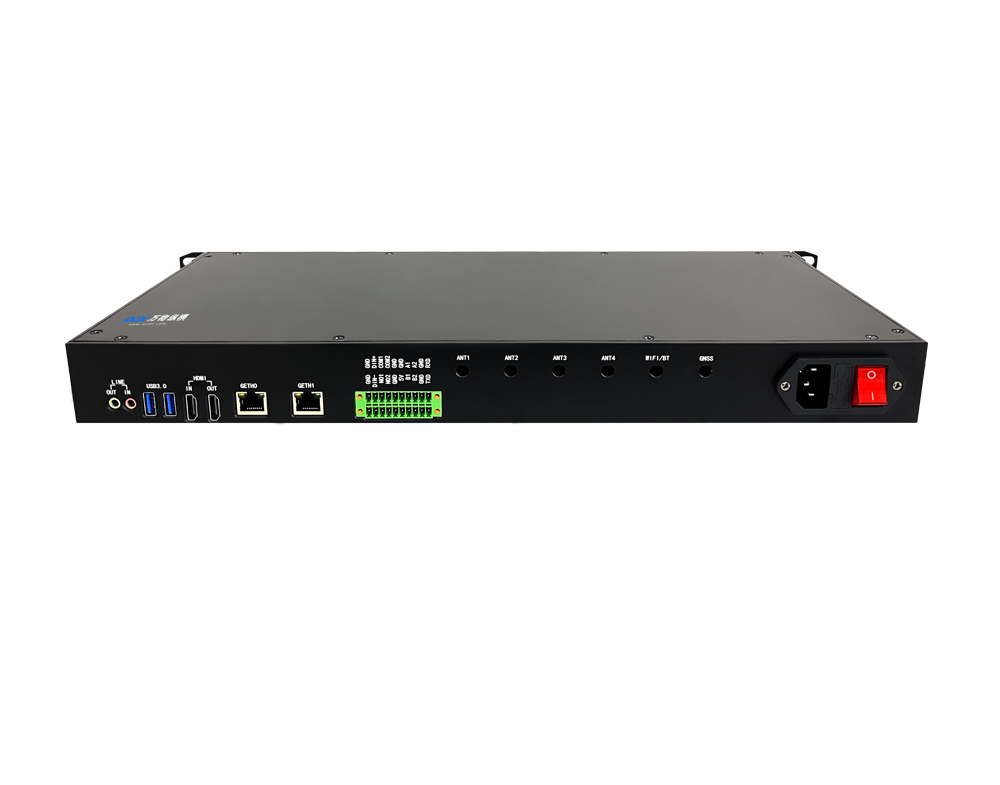


随着国产AI芯片在边缘计算领域的快速渗透,算能BM1688凭借16TOPS INT8算力、高集成度与亲民成本,成为边缘智能盒子的主流选型之一。但从BM1684/BM1684X迁移至BM1688的过程中,开发者往往会遇到SDK体系差异、内存架构变更、多媒体接口不兼容、双核调度等一系列“隐形坑”。本文基于实际项目落地经验,完整梳理BM1688 SDK适配全流程的踩坑点与解决方案。
1. 认知前置:BM1688 与前代芯片的核心差异
在动手开发前,必须先理清BM1688的架构特点,避免带着BM1684X的思维惯性直接写代码。
1.1 硬件架构核心区别
维度 | BM1684X | BM1688 | 开发影响 |
TPU核心 | 单核 | 双核(可拆分调度) | 支持 --num_core 2 编译双核模型 |
内存Heap | 3个heap(0/1/2) | 2个heap(0/1) | heap_id=2的代码全部失效 |
视频子系统 | VPU+VPP分离 | VPSS统一子系统 | 多媒体接口全部变更 |
CPU | 四核A53 | 八核A53 @1.6GHz | 并发能力更强,但需注意绑核 |
SDK体系 | SOPHON SDK v2/v3 | 独立SDK分支(CV186AH同源) | 不能复用BM1684X的SDK包 |
1.1 SDK 版本对应关系
重点提醒:BM1688/CV186AH的SOPHONSDK与BM1684/BM1684X不是同一套,必须单独从官网获取对应版本,切勿混用头文件和库文件。SDK版本与TPU-MLIR版本强绑定,建议使用配套docker环境,避免版本不兼容导致模型编译失败。
2. 环境搭建:从0到1跑通基础环境
2.1 开发环境搭建(x86 宿主机)
模型编译与交叉编译都需要在x86 Ubuntu主机上完成,推荐配置:
系统:Ubuntu 20.04/22.04
内存:32GB以上(编译大模型时内存不足会直接OOM)
Docker:必须安装,TPU-MLIR官方推荐使用docker环境
模型编译环境搭建
# 拉取官方编译镜像
docker pull sophgo/tpuc_dev:latest
# 启动容器,映射工作目录
docker run --privileged --name bm1688_dev -v $PWD:/workspace -it sophgo/tpuc_dev:latest
# 容器内安装tpu_mlir(建议用清华源加速)
pip install tpu_mlir[all] -i https://pypi.tuna.tsinghua.edu.cn/simple
踩坑记录1:pip install tpu_mlir 失败或版本不匹配
原因:docker镜像内pip源网络不畅,或tpu_mlir版本与SDK不匹配
解决:使用国内镜像源;严格按照SDK文档指定的版本安装,不要盲目升级
1.2 交叉编译环境配置
SoC模式下的应用程序必须使用ARM64交叉编译器编译:
# 解压SDK包后设置环境变量
source /path/to/sophon-sdk/scripts/envsetup_soc.sh
# 确认交叉编译工具链
which aarch64-linux-gnu-gcc
踩坑记录2:编译时找不到 libsophon 头文件
原因:环境变量未正确source,或CMakeLists中未指定SDK路径
解决:编译前必须执行envsetup_soc.sh;CMake中通过CMAKE_FIND_ROOT_PATH指定SDK根目录
1.2 设备端运行环境
BM1688边缘盒子通常采用eMMC或SD卡启动,刷机包位于SDK的sophon-img/sdcard.tgz。系统启动后,运行库默认安装在 /opt/sophon/ 目录下。
必备环境变量(SoC模式)
# 配置sophon-opencv的Python路径
export PYTHONPATH=$PYTHONPATH:/opt/sophon/sophon-opencv_xxx/opencv-python
踩坑记录3:导入cv2提示找不到numpy
原因:SoC系统默认未安装numpy,或numpy版本与opencv不兼容
解决:手动安装指定版本numpy;优先使用SDK提供的sophon-opencv而非apt安装的原生opencv
2. 模型转换:TPU-MLIR 编译与量化全流程
模型转换是整个适配流程中问题最集中的环节,直接决定推理精度与性能。
2.1 标准转换流程
原始模型(ONNX/PyTorch) → MLIR中间表示 → FP32 bmodel → 校准量化 → INT8 bmodel
关键命令示例(INT8对称量化+双核)
# 1. 模型转MLIR
model_transform.py \
--model_name yolov5s \
--model_def yolov5s.onnx \
--input_shapes [[1,3,640,640]] \
--mlir yolov5s.mlir
# 2. 生成校准表
run_calibration yolov5s.mlir \
--dataset ./calib_data \
--input_num 100 \
--chip bm1688 \
-o yolov5s_cali_table
# 3. 编译为INT8双核模型
model_deploy.py \
--mlir yolov5s.mlir \
--quantize INT8 \
--calibration_table yolov5s_cali_table \
--processor bm1688 \
--num_core 2 \
--test_input test_input.npz \
--test_reference ref_output.npz \
--tolerance 0.85,0.45 \
--model yolov5s_bm1688_int8_2core.bmodel
1.2 模型转换高频踩坑
坑点1:--chip 参数写错导致模型无法加载
现象:模型编译成功,但板子上加载时报 chip mismatch
原因:BM1688必须指定 --processor bm1688,不能沿用 bm1684x
注意:CV186AH使用 --processor cv186x,二者不可混用
坑点2:量化后精度骤降
排查步骤:
1. 先验证FP32 bmodel精度是否正常,排除模型转换本身的问题
2. 增加校准图片数量(建议不少于200张,且覆盖真实场景)
3. 更换校准算法:默认KLD,可尝试 --cali_method use_mse
4. 对敏感层使用混合精度,将关键层保留为FP16
坑点3:算子不支持报错
现象:编译时提示 op not supported
解决路径一:优先替换算子,比如把SiLU换成ReLU+Sigmoid组合
解决路径二:使用TFLite层分解,部分复杂算子可拆分为基础算子组合
解决路径三:极端情况用BMLang自定义算子开发
坑点4:双核模型性能不升反降
原因:小模型双核调度开销大于收益;输入batch过小
建议:单路推理优先单核;多路并发或大batch时再开启双核;注意 --num_core 2 是单模型拆分到两核,而非同时跑两个模型
2. API 迁移:从 BM1684X 到 BM1688 的代码改造
如果你的项目基于BM1684X开发,迁移到BM1688时需要重点修改以下几类接口。
2.1 内存Heap 编号修改(最高频坑)
这是90%迁移项目都会踩到的第一坑。BM1688只有两个heap,而BM1684X有三个。所有指定 heap_id=2 或 heap_mask=1<<2 的代码在BM1688上都会分配失败。
需要修改的典型接口
// BM1684X 写法(BM1688上会失败)
bm_malloc_device_byte_heap(handle, &mem, 2, size);
bm_image_alloc_dev_mem(image, 2);
bm_image_alloc_dev_mem_heap_mask(image, 1 << 2);
// BM1688 正确写法
bm_malloc_device_byte_heap(handle, &mem, 1, size);
bm_image_alloc_dev_mem(image, 1);
bm_image_alloc_dev_mem_heap_mask(image, 1 << 1);
踩坑提醒:很多封装代码把heap_id写死为2作为“大内存堆”,在BM1688上必须全局搜索替换。建议封装成宏定义,便于跨芯片兼容。
1.3 暂不支持的 BMCV 接口
BM1688的BMCV库相比BM1684X有部分接口尚未实现,直接编译会报未定义符号:
bmcv_base64_enc() / bmcv_base64_dec()
bmcv_nms() / bmcv_nms_ext()
bmcv_faiss_indexflatIP()
FFT相关的一整套接口
应对方案:
NMS、Base64等轻量操作放到CPU端执行
必须硬件加速的操作,评估是否用多个基础算子组合实现
1.4 数据类型与内存布局变更
BM1688不再推荐使用4N数据类型,统一使用1N格式。如果旧代码大量使用4N布局,需要逐步改造为1N,否则会出现性能下降或对齐错误。
2. 多媒体处理:VPSS 子系统适配要点
BM1688将视频解码与图像处理统一整合为VPSS子系统,取代了BM1684X的VPU+VPP分立架构,这是多媒体开发中改动最大的部分。
2.1 视频解码注意事项
解码能力:16路1080p30 H.264解码,与BM1684X持平
接口变化:解码API前缀从 bm_vpu_ 变更为VPSS体系接口
输入格式:支持RTSP、文件、裸流等多种输入源
踩坑:缩放比例超限报错
vpp not support: scaling ratio greater than 32
原因:硬件限制单次缩放不能超过32倍
解决:分多次缩放,或调整crop区域与输出尺寸的比例关系
1.3 图像预处理加速
BMCV硬件加速的resize、crop、颜色空间转换是性能关键,但有严格的尺寸对齐要求。
最佳实践:
图像宽高按16对齐,避免内部重复padding
批量处理时使用 bmcv_image_vpp_convert 批量接口,减少调用开销
尽量使用NV12格式直通推理,减少RGB格式转换
1.4 内存一致性管理
SoC模式下设备内存与系统内存物理上是同一块,但存在Cache一致性问题:
调用BMCV硬件接口处理后,需要 downloadMat 同步Cache
CPU修改了Mat数据后,需要 uploadMat 同步到设备视图
高频场景建议手动管理同步,避免自动同步带来的冗余开销
2. 内存管理:ION 内存分配与泄漏排查
边缘盒子内存资源紧张(通常4GB/8GB),内存管理不善很容易跑几小时就OOM重启。
2.1 内存分区概览
BM1688的物理内存分为三大区域:
1. 系统内存:Linux内核管理,普通malloc使用
2. ION预留内存:分为NPU heap、VPSS heap等,专供硬件加速模块使用
3. 固件保留内存:用户不可分配
查看各分区使用情况
# 系统内存
free -h
# NPU/TPU 内存
cat /sys/kernel/debug/ion/bm_npu_heap_dump/summary | head -2
# VPSS 内存
cat /sys/kernel/debug/ion/bm_vpp_heap_dump/summary | head -2
1.3 常见内存泄漏场景
场景1:bmodel加载后未释放
每次 bmrt_load_bmodel 都要对应 bmrt_unload_bmodel
动态切换模型时尤其容易遗漏
场景2:bm_image创建后未销毁
bm_image_create 必须配对 bm_image_destroy
中途出错return时容易跳过敏清理代码
场景3:设备内存申请未释放
bm_malloc_device_byte 对应 bm_free_device
建议使用RAII智能指针封装,自动管理生命周期
1.4 调优建议
启动时预分配所有需要的设备内存,运行中避免频繁申请释放
多路视频场景复用图像buffer,采用环形缓冲队列
预留20%以上的ION内存余量,防止峰值分配失败
2. 性能优化:充分发挥八核+双核TPU能力
2.1 CPU 绑核与调度优化
BM1688有8个A53核心,合理绑核能显著提升稳定性:
将解码线程、推理线程、业务线程分别绑定到不同CPU核
实时性要求高的线程绑定到单独核,并设置调度优先级
避免所有线程挤在0号核上导致抢占严重
示例:设置线程亲和性
cpu_set_t cpuset;
CPU_ZERO(&cpuset);
CPU_SET(2, &cpuset); // 绑定到CPU2
pthread_setaffinity_np(pthread_self(), sizeof(cpu_set_t), &cpuset);
1.4 推理流水线优化
单路视频分析的标准三段式流水线:
解码 → 预处理(BMCV) → TPU推理 → 后处理(CPU)
优化手段:
多线程流水线并行,每段一个线程,用队列传递数据
预处理尽量全部走BMCV硬件加速,减少CPU占用
后处理中的NMS、坐标换算等,与下一路推理并行执行
1.5 多路并发最佳实践
16路1080p是BM1688的标称能力,但实际落地需要精打细算:
模型统一编译为INT8,优先保证算力密度
输入分辨率能降则降,检测场景1080p抽帧到720p往往精度损失可接受
并非路数越多越好,找到帧率、路数、精度的平衡点
2. 部署调试:现场排障实用手册
2.1 必开调试开关
推理IO数据调试
export BMRT_SAVE_IO_TENSORS=1
开启后每次推理会生成输入输出二进制文件,可用于对比PC端与板端推理结果差异,定位精度问题。
日志级别调整
export BMRT_LOG_LEVEL=4 # 0-6,数字越大越详细
1.5 常见报错速查
报错信息 | 常见原因 | 解决方向 |
bm_malloc failed | heap_id错误或内存不足 | 检查heap_id是否为1;查看ION剩余空间 |
chip mismatch | 模型编译目标芯片不对 | 重新编译指定 --processor bm1688 |
op not supported | 模型含不支持算子 | 替换算子或降级处理 |
scaling ratio > 32 | VPP缩放超硬件限制 | 分级缩放或调整尺寸 |
推理结果全0/全乱 | 量化精度崩了 | 增加校准数据,换校准算法,关键层混精 |
1.6 稳定性压测要点
连续72小时满负荷跑,观察内存是否缓慢上涨
反复启停推理流程,验证资源释放完整性
高温环境下测试,关注TPU降频对帧率的影响
异常断流、网络抖动场景下的恢复能力
2. 总结与避坑建议
2.1 迁移适配 checklist
SDK版本确认,BM1688专用SDK,不与BM1684X混用
全局搜索 heap_id=2 / heap_mask=4,全部改为1
模型编译参数 --processor bm1688
检查是否使用了BM1688不支持的BMCV接口
VPSS多媒体接口替换原有VPU/VPP代码
bm_image与设备内存配对释放,排查泄漏
多路并发下的内存余量测算
CPU绑核与线程优先级配置
2.2 给开发者的建议
1. 先跑通样例再改自己的代码:SDK自带的sophon-demo是最佳参照物,先确认demo在板子上跑通,排除硬件和环境问题
2. FP32验证先行:量化前务必确认FP32模型精度正常,否则量化出了问题根本不知道源头在哪
3. 善用官方文档:BM1688官方文档站有完整的兼容性说明,迁移前通读一遍能少走很多弯路
4. 关注社区更新:算能SDK迭代较快,新版本可能已经修复了你踩的坑,定期关注Release Note
国产边缘芯片的开发体验虽然还在追赶国际大厂,但BM1688凭借完整的工具链和活跃的社区支持,已经具备大规模落地的条件。理解硬件特性、吃透SDK边界、做好内存与性能管理,就能平稳完成从方案到产品的跨越。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部