


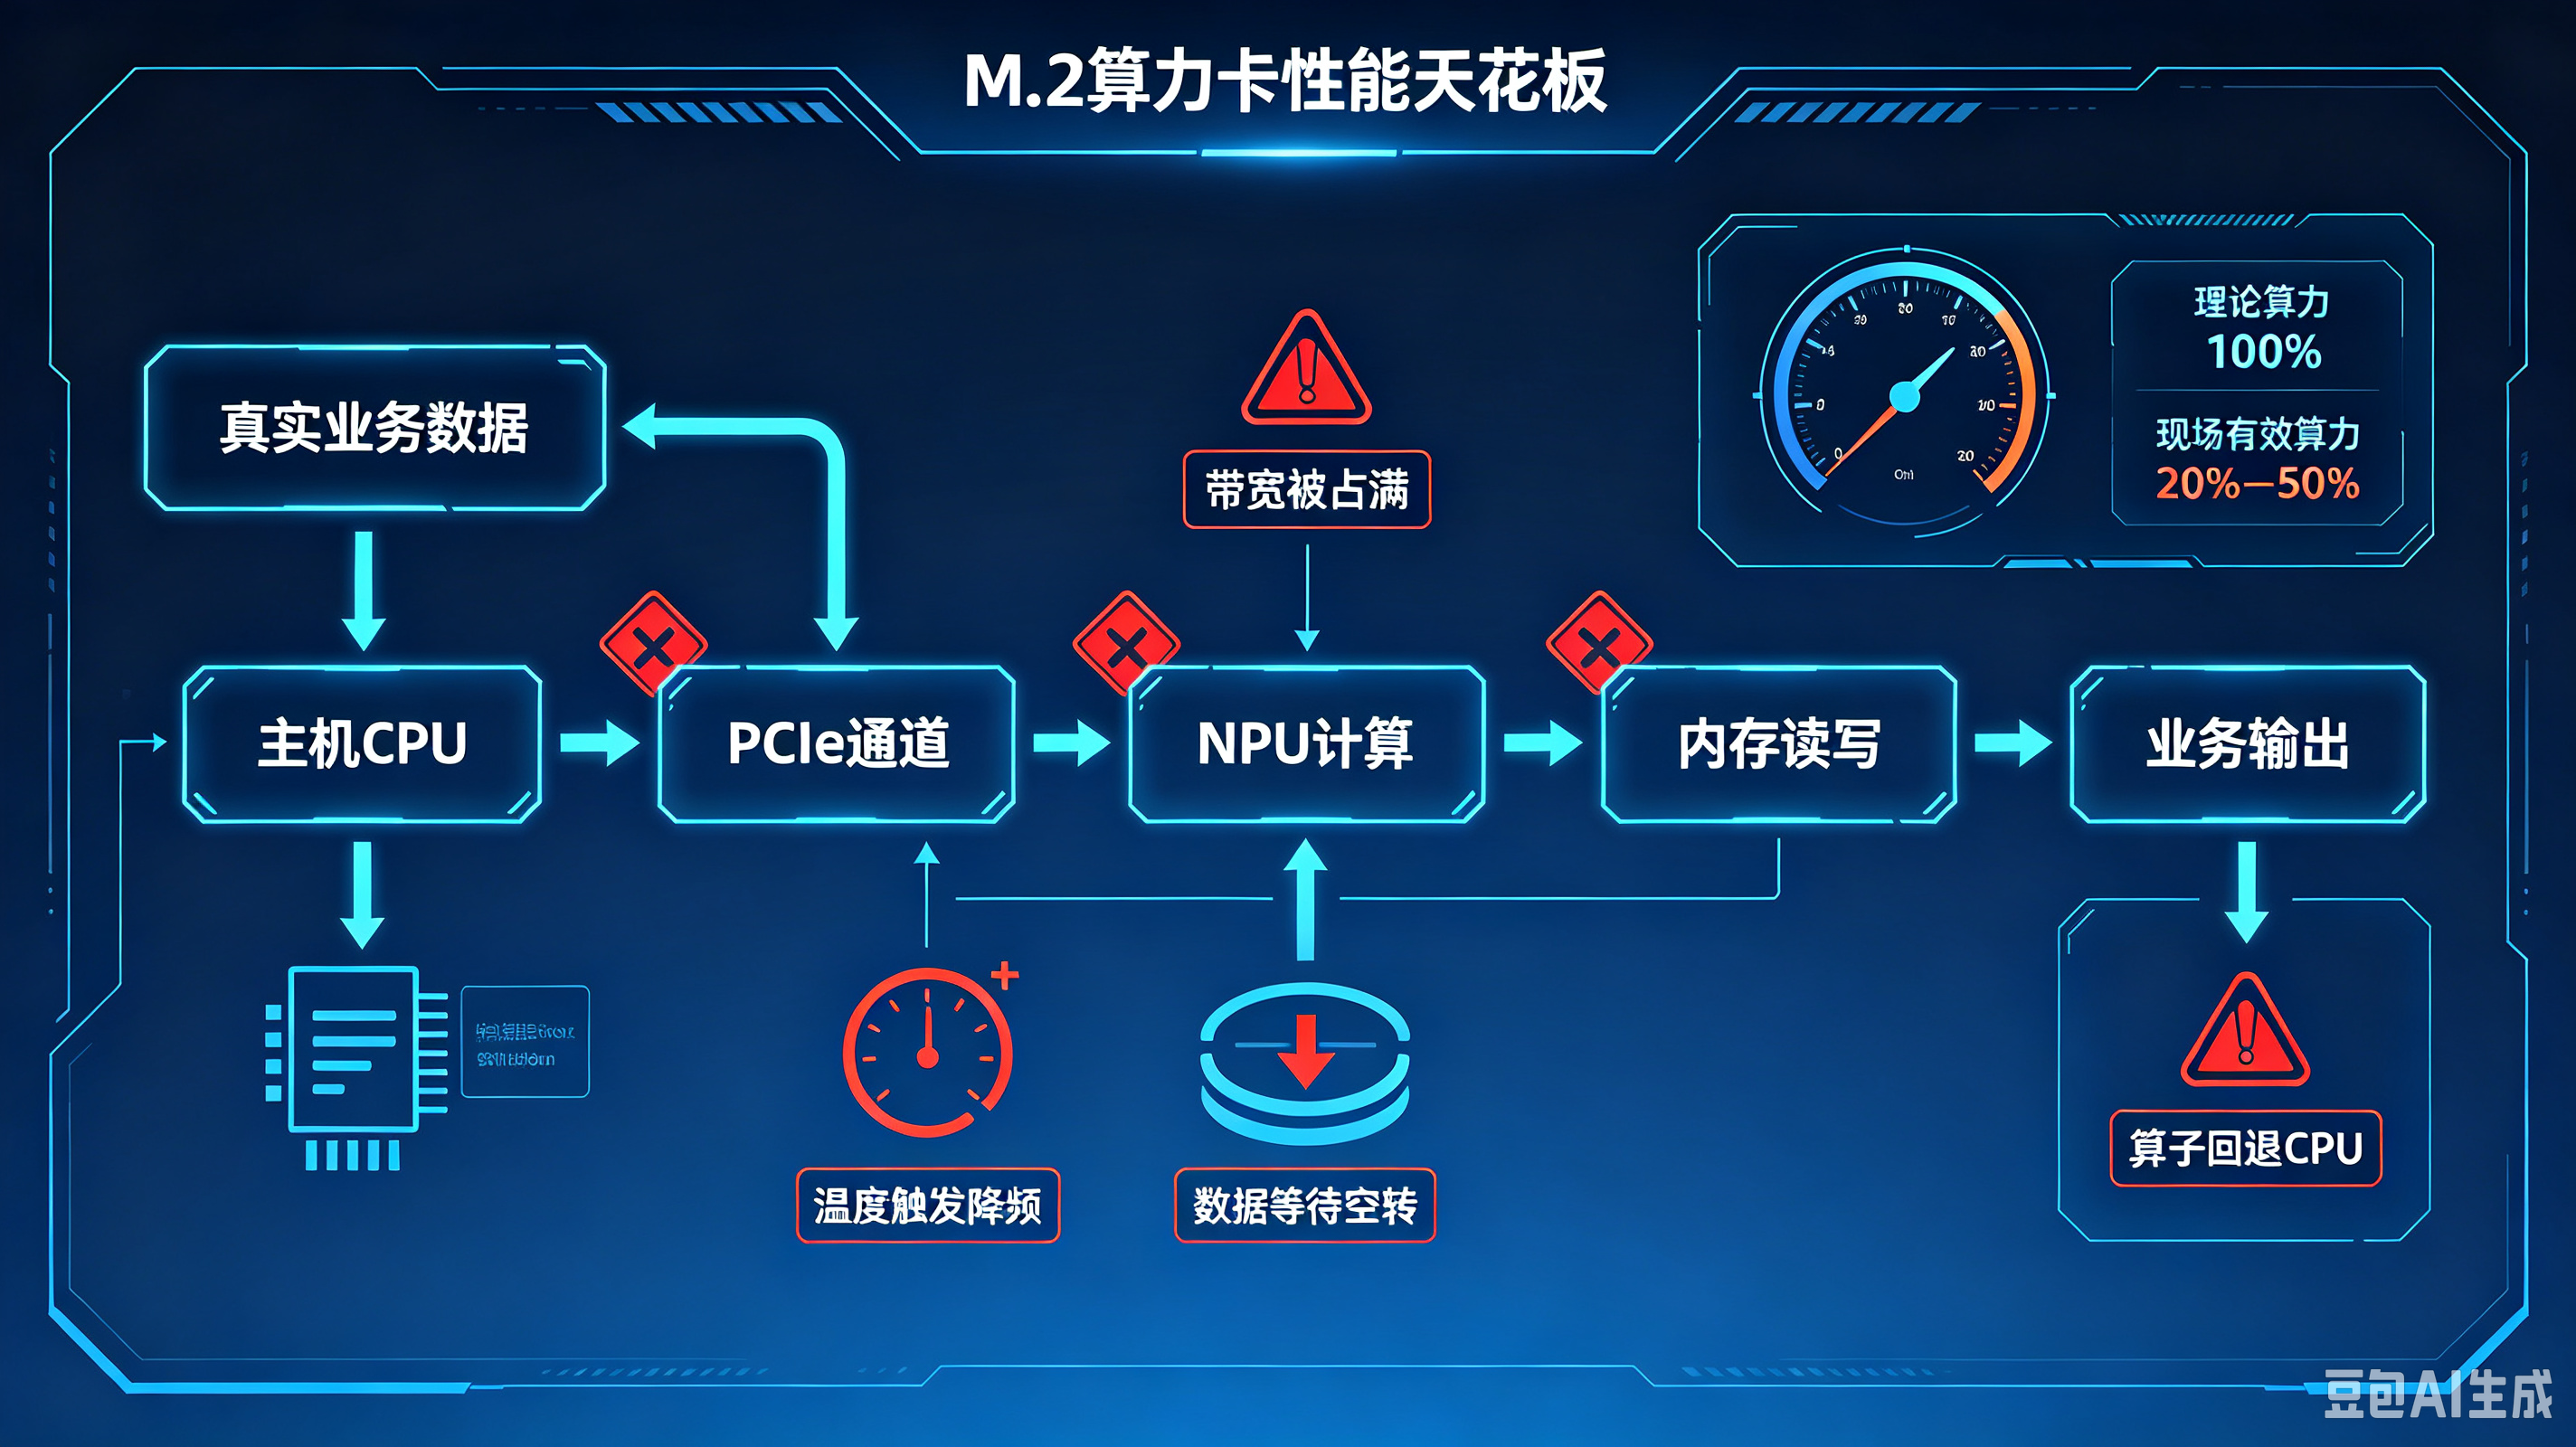
现象:手册 INT8 TOPS 很漂亮,实验室跑简单 demo 尚可;上项目真实业务(多路视频、大模型、多模型串联)吞吐暴跌、延迟抖动大、长时间负载掉速,有效算力往往只有标称的 20‑50%。
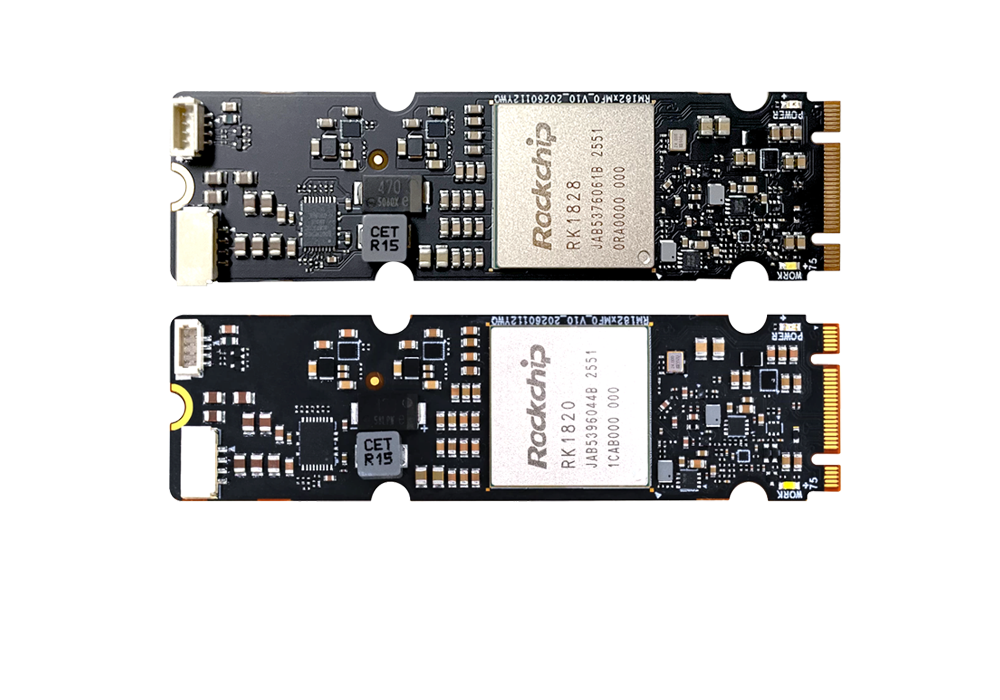
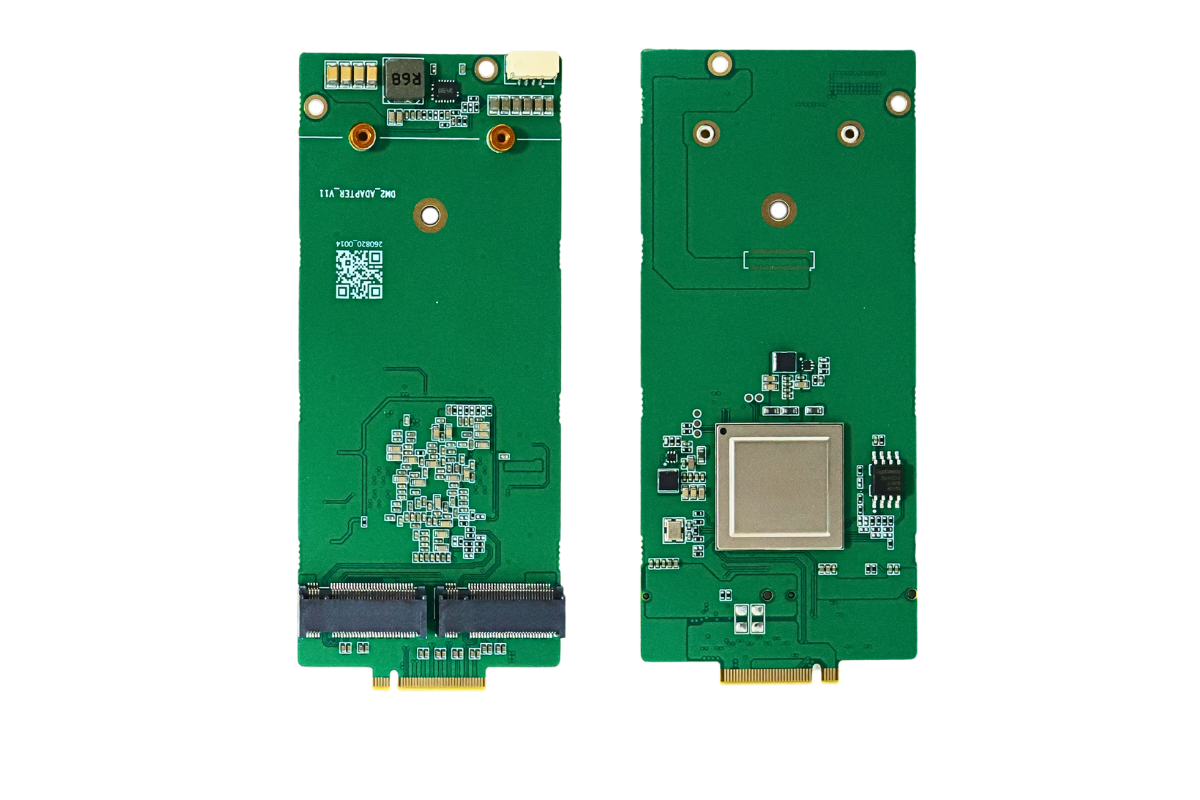
典型代表:BM1684X、RK1828 M.2 模组等边缘 M.2 算力卡,不是芯片 NPU 本身不行,是 M.2 形态 + 宿主平台 + 软件栈 + 现场工况共同制造性能天花板。
一、硬件形态先天坑(M.2 物理约束,最容易被忽略)
1. PCIe 带宽瓶颈:算力喂不饱
M.2 算力卡普遍 PCIe3.0 x2/x4,少数 x1;很多工控机 / ARM 底板实际跑成PCIe x2 甚至 x1,带宽直接腰斩。
芯片内部 NPU + 片上 DDR 带宽很高,但图片、视频帧、模型中间张量需要反复跨 PCIe 在主机↔算力卡搬运;多路视频、大模型 KV Cache 回传时,PCIe 成为堵点,NPU 大量时间在等待数据,算力空转。
坑点:实验室单帧小模型看不出,一旦多路并发、大分辨率、Transformer 模型,性能断崖下跌。
2. M.2 散热与功耗墙,持续负载强制降频
M.2 2242/2280 空间极小,只能贴薄散热片,工业设备大多无风扇密闭机箱。
芯片标称峰值算力是短时瞬间峰值;持续高负载结温快速上升,固件自动降频保护。例如 RK1828 M.2 版本官方默认锁 NPU 主频,低于 SODIMM 版本,直接砍掉一部分纸面算力。
现场现象:前几分钟性能尚可,跑 10‑30 分钟后 FPS 减半、延迟飙升;温度降下来又恢复,抖动非常明显。
很多选型只看 TDP,忽略持续稳态功耗、散热条件、机箱环境温度。
3. M.2 供电短板
M.2 金手指 3.3V 供电能力有限,峰值瞬间功耗上不去;部分工控底板 M.2 插槽供电余量不足,大负载下自动限流,芯片跑不满主频。
二、芯片与内存子系统:TOPS 是理想条件
1. 纸面 TOPS 定义条件极其苛刻:只有纯稠密矩阵卷积、100% 计算占比、所有数据全部放在片上 SRAM,才能摸到峰值 TOPS。
真实业务包含 NMS、Softmax、LayerNorm、Reshape、切片、多分支,大量非卷积算子,NPU 硬件利用率天然打折扣,国产 NPU 普遍实际利用率 25‑50% 区间。
2. 板载 DDR/LPDDR 带宽、延迟
M.2 模组受成本、BOM 限制,内存控制器、布线、颗粒选型妥协;大模型、多路视频场景下,内存带宽而不是 NPU 算力成为瓶颈,NPU 算完要等内存读写,算力空等。
通俗比喻:NPU 是干活工人,TOPS 是工人手速;PCIe 是外部进料传送带,板载内存是车间内部物料周转。工人再快,进料慢、车间搬运慢,整体产出上不去。
三、软件栈与模型编译,项目翻车重灾区
1. 算子不全、算子效率低
Demo 用厂商 model zoo 里已经深度调优好的模型,跑分好看;换成自己业务模型,出现大量不支持算子,回退 CPU 执行,性能直接崩盘。
部分算子硬件支持,但编译器生成的指令调度差,算子执行效率低,达不到硬件理论速度。
Transformer、新的激活函数、自定义层,适配缺口尤其大。
2. 量化损失带来隐性性能下降
INT8 是宣传 TOPS 的基础。
自己做 PTQ 量化不到位,精度掉了,为保证业务效果,被迫切分辨率、降并发;看起来是性能不行,根源是量化质量差。
部分模型不适合 INT8,只能跑 FP16,FP16 算力远低于 INT8 纸面 TOPS,很多客户选型时忽略这点。
3. Runtime 内存开销、CPU 占用
M.2 协处理器模式,图像预处理、解码、后处理、NMS 很多工作落在宿主 CPU;多路并发时 CPU 占满,形成新瓶颈。
实验室单路跑看不出压力,上多路业务暴露。
4. SDK 版本坑
不同 SDK 版本性能差异巨大;老版本编译器 bug、调度缺陷,同样硬件,升级 SDK 吞吐可以提升 30% 以上,也可能降级。
四、宿主平台适配坑(很多人只看算力卡,忽略主机)
1. ARM 底板(RK3588 等)接 M.2 算力卡:PCIe 链路质量、时钟、复位、驱动适配参差不齐;有些底板 PCIe 信号完整性差,跑不满 Gen3 速率,甚至丢包。
2. x86 工控机:BIOS 里 M.2 插槽被配置成 SATA 模式、PCIe 降速、省电节能策略,导致算力卡跑不满性能。
3. 多卡 M.2:多个 M.2 插槽共享 PCIe root port,带宽共享,插多卡后每张卡带宽被瓜分。
五、实验室 vs 现场环境的巨大差异
条件 | 实验室测试 | 真实项目现场 |
负载 | 单路、短时间跑 demo | 7×24h、多路并发、多模型串联 |
温度 | 空调室温开放机箱 | 密闭机柜、车间 40 55℃高温 |
输入数据 | 标准干净数据集 | 实际摄像头码流、抖动、噪声 |
宿主配置 | 高配开发底板 | 量产工控机,供电 / PCIe 保守 |
很多项目:开发板调通跑分很漂亮,拿到量产整机现场直接性能腰斩。
六、落地避坑实操清单(项目选型 & 测试必做)
1. 不要以手册 TOPS 作为选型依据,做业务场景实测
用真实业务模型、真实分辨率、真实并发路数,长时间压力测试 2‑4 小时,看稳态 FPS、延迟抖动,不要看前几分钟峰值。
2. 核查 PCIe 实际链路速率
lspci -vv确认 M.2 算力卡当前实际运行 Gen 版本、lane 数量,确认不是 x1 降速。
3. 现场监测温度、主频
持续负载下看芯片结温、NPU 实际运行频率,确认是否出现 thermal throttling 降频。M.2 散热条件差,优先选带加厚散热片,必要时机箱辅助导热。
4. 模型编译阶段核查算子
编译日志看有没有算子 fallback 到 CPU;统计硬件算子占比,占比越低,实际性能越差。
5. 区分:INT8 峰值 TOPS vs FP16 实际算力
如果业务模型不能 INT8 量化,直接按 FP16 算力评估,不要看 INT8 宣传数字。
6. 整机闭环测试,不要只在开发板测试
尽量使用量产整机外壳、电源、机箱温度做压力测试,开发板开放环境的性能没有参考价值。
7. 关注 SDK 版本,锁定稳定版本,不要随意升级。
总结
M.2 国产算力卡纸面算力高但现场拉胯,绝大多数不是芯片 NPU 算得慢,而是 PCIe 带宽、M.2 散热降频、内存子系统、算子编译、宿主平台、现场高温长负载共同造成的系统级问题。TOPS 只是理想实验室峰值,项目评估必须做整机稳态业务压测。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部