


一、核心认知:为什么理论 TOPS 和工程实际差距巨大
INT8‑TOPS 是芯片 NPU 阵列满频满负载的理论上限,现实中会遇到五层损耗:
1. PCIe 带宽瓶颈:M.2 Key‑M 大多为 PCIe3.0 x4,裸带宽约 3.9GB/s,模型权重、推理中间张量反复搬运,带宽吃满后 NPU 空闲空转,算力利用率直接腰斩。
2. 片上显存约束:小显存卡,大模型必须频繁 swap 主机内存,token 生成、多视频流场景延迟暴涨。
3. 算子完备度:非标准算子、大模型 K‑V Cache、MoE 专家层缺少硬件加速,只能 CPU 回退,吞吐暴跌。
4. 功耗‑温度墙降频:M.2 狭小空间散热受限,持续高负载触发温控降频,峰值算力只存在短时间 benchmark。
5. 多卡通信开销:M.2 没有专用高速互联,多卡级联完全依赖 PCIe,卡间数据拷贝损耗大,线性加速比很难超过 0.6‑0.7。
行业实测经验:国产 M.2 算力卡,视觉检测场景有效算力一般为理论峰值55%‑75%;跑 7B 大语言模型,有效算力通常只有理论35%‑55%。
二、三款主流 M.2 国产算力卡硬件 & 纸面参数对比
项目 | |||
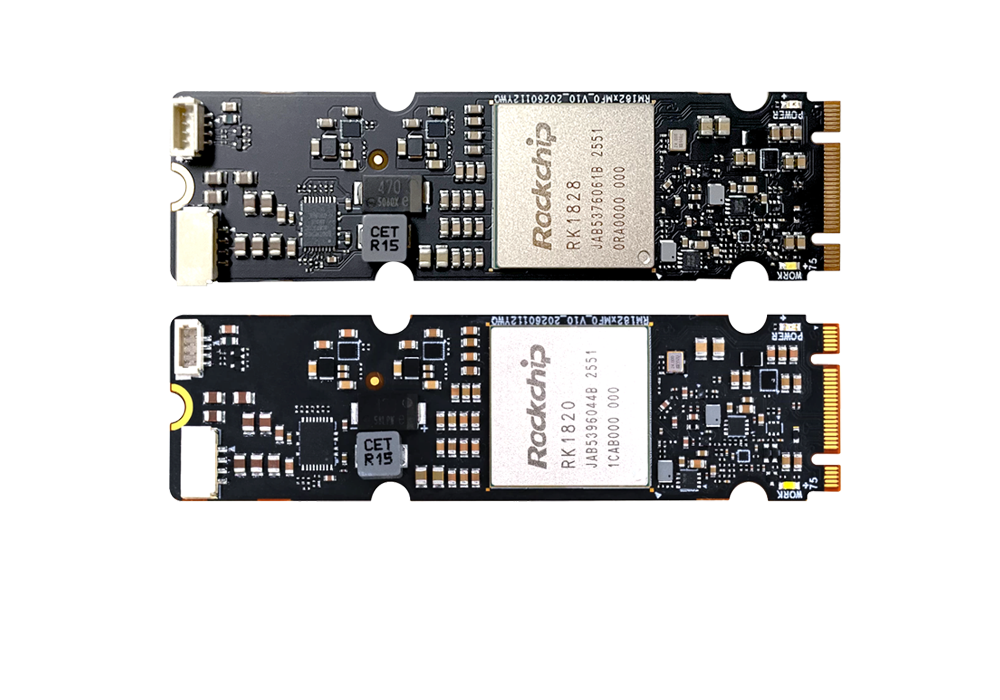
芯片 | BM1684X | LQ50 双 NPU | RK1828 AI 协处理器 |
INT8 理论算力 | 32TOPS | 2×13TOPS=26TOPS | 20TOPS |
板载显存 | 16GB LPDDR4 | 16GB | 5GB 3D 堆叠 DRAM |
视频编解码 | 32 路 1080P 解码,8 路 4K,支持 8K | 中等多路解码,侧重推理计算 | 无硬编解码,复用主控 SoC 编解码单元 |
接口形态 | M.2 2280 Key M PCIe3.0 x4 | M.2 2280 Key M PCIe3.0 x4 | M.2 2280 Key M PCIe3.0 x4 |
典型功耗 | 17W | 12 15W | <5W(峰值 8W) |
SDK | SOPHON SDK | LQ SDK | RKNN3 SDK |
核心定位 | 多路视频视觉推理,工业边缘盒子 | 视觉 + 端侧大模型混合负载 | 协处理器,搭配 RK3588 系列主控扩展算力 |
三、工程落地真实能力拆解
1、算能 BM1684X M.2
纸面:32TOPS INT8,16GB 显存,强编解码能力
✅ 落地优势
1. 视频编解码硬件单元完整,多路视频分析是强项;实测单卡稳定跑 20‑24 路 1080P YOLOv8 检测,是智慧工地、明厨亮灶、光伏巡检首选。
2. SDK 成熟度高,YOLO、ResNet 等视觉模型算子覆盖完善,行业算法厂商适配最多,工具链文档齐全。
3. 16GB 大显存,可同时加载多套算法模型,多实例并发能力强。
工程短板
1. M.2 散热空间有限,持续跑满 32 路视频,温度触墙降频,实际有效算力落到 20‑23TOPS 区间。
2. 大语言模型不是原生强项,K‑V Cache 优化一般,跑 7B 模型 token 吞吐不如专门大模型协处理器;多卡级联完全走 PCIe,多张卡堆叠加速比衰减明显。
3. 功耗 17W,普通 M.2 插槽供电紧张,很多工控主板需要额外外接供电,否则容易不稳定重启。
最佳场景:多路视频 AI 分析、安防边缘盒子、工业视觉检测;不优先用于纯大语言模型离线推理。
2、力擎 LQ50 Duo M.2(双 NPU 架构)
纸面:双 NPU 合计 26TOPS INT8,16GB 共享显存
✅ 落地优势
1. 双 NPU 异构,可拆分负载:一路跑视觉检测,一路跑 LLM/VLM 多模态,兼顾视频流与本地大模型。
2. 16GB 大显存,7B 模型可以完整载入显存,避免 swap 内存,token 输出表现优于 BM1684X。
3. 功耗控制均衡 12‑15W,相比 BM1684X 对 M.2 供电压力更小。
工程短板
1. 视频硬编解码能力弱,多路码流解码依赖主板主控 CPU/SoC,跑 30 路以上视频场景性能不如 BM1684X。
2. SDK 生态规模小于算能,小众模型、开源新模型需要较多手动算子适配。
3. Duo 双芯调度存在开销,负载不均衡时,其中一颗 NPU 跑满,另一颗闲置,算力利用率下降。
最佳场景:视觉 + 大模型混合边缘设备,机器人边缘盒、本地多模态分析,中等路数视频 + 离线 LLM 推理。
3、瑞芯微 RK1828 M.2 协处理器
纸面:20TOPS INT8,5GB 3D 堆叠高带宽 DRAM,功耗 < 5W
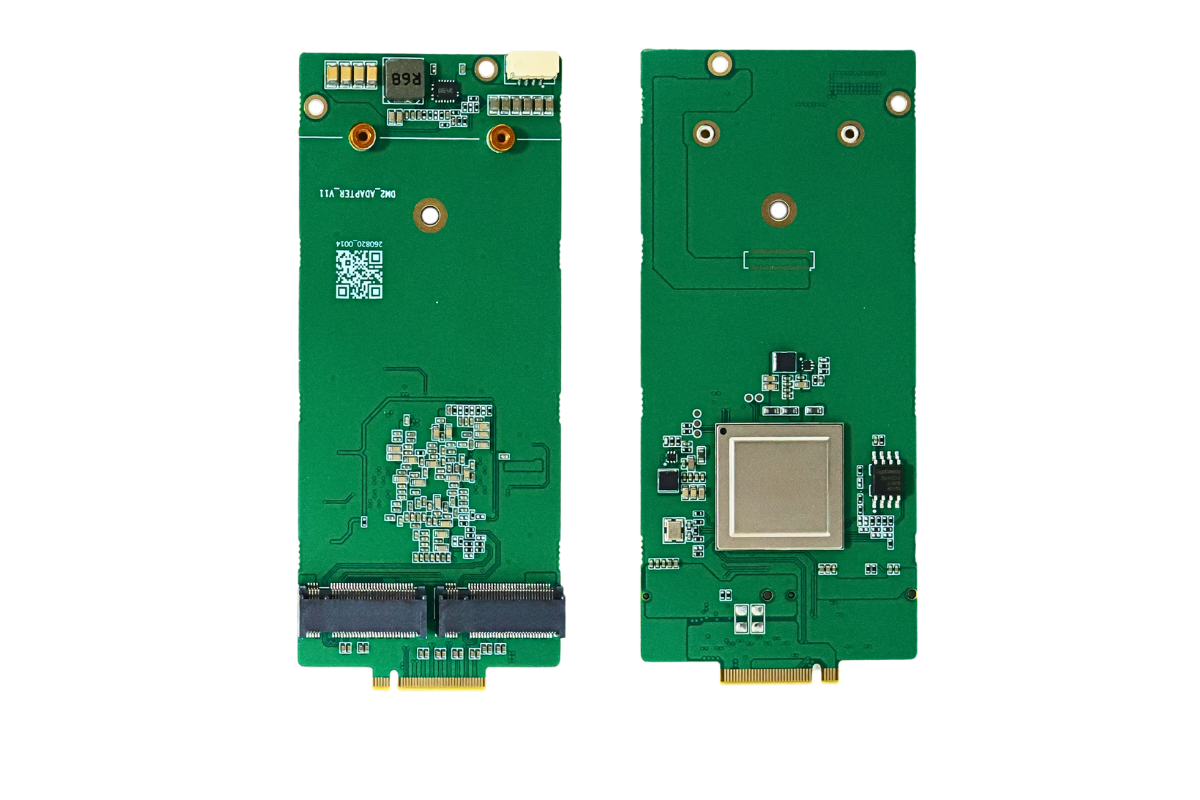
重点:RK1828 是纯 AI 协处理器,没有 CPU、没有视频编解码,必须搭配 RK3588/RK3576 等瑞芯微主控使用,不能独立在 X86 主板直接工作。
✅ 落地优势
1. 3D 堆叠内存,显存带宽很高,专门针对 LLM 优化;单卡稳定跑 Qwen‑7B,双 RK1828 卡可跑 13B 模型,token 吞吐表现亮眼。
2. 功耗极低,5W 级别,M.2 插槽原生供电即可,散热压力小,工业宽温环境稳定性好。
3. 和 RK3588 生态打通,RKNN3 工具链,模型转换便捷;主板可以插 2 张 M.2,实现算力弹性扩展。
工程短板
1. 不能独立使用,必须绑定瑞芯微主控,X86 服务器、普通 X86 工控机无法直接部署,选型约束极强。
2. 没有硬解码,所有视频流解码全部由 RK3588 主控承担,当视频路数 > 12 路,主控解码资源吃满,整体系统瓶颈转移到 SoC。
3. 5GB 显存偏小,多模型并发、多模态大模型场景容易爆显存。
最佳场景:RK3588 平台升级,机器人、本地离线大模型、低功耗工业设备;不适合 X86 平台多路视频大规模分析。
四、三大卡工程关键痛点汇总
1. 供电与散热(M.2 形态通用大坑)
BM1684X 功耗 17W,很多普通 M.2 插槽供电能力不足,必须外接供电;狭小 M.2 空间,无主动散热,持续高负载全部会降频,散热设计直接决定实际算力上限,而不是芯片 TOPS。
2. 多卡级联真实表现
三款卡均无专用高速互联,全部依赖 PCIe。
BM1684X:2 卡加速比约 0.65‑0.7,4 卡下降到 0.5‑0.55;
LQ50 Duo:双卡加速比 0.6‑0.68;
RK1828:双卡在 RK3588 平台加速比 0.6‑0.75,超过两张卡收益衰减严重。
M.2 算力卡不适合 4 卡以上大规模集群,定位是边缘单机 1‑2 张卡扩展。
3. 选型判断口诀
多路视频优先:BM1684X M.2;
视频 + 本地大模型混合负载:LQ50 Duo;
已经在用 RK3588 平台,要扩展本地 LLM:RK1828 M.2;
X86 工控机不要选 RK1828,无法独立工作。
五、落地调优建议(缩小理论‑实际算力鸿沟)
1. BIOS 打开 Resizable BAR,充分释放 PCIe 带宽,减少张量传输开销。
2. 视觉任务尽量 INT8 量化,大模型优先 SmoothQuant,平衡精度与吞吐。
3. M.2 算力卡不要迷信满负载跑理论 TOPS,做业务压力测试,连续 24 小时拷机,观察温度降频后的稳态性能,以稳态性能作为项目设计指标,不要拿短时间 benchmark 结果做方案。
4. 多卡场景尽量避免大模型张量频繁跨卡拷贝,优先单卡把模型塞进显存,迫不得已再拆分多卡。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部