
 商城
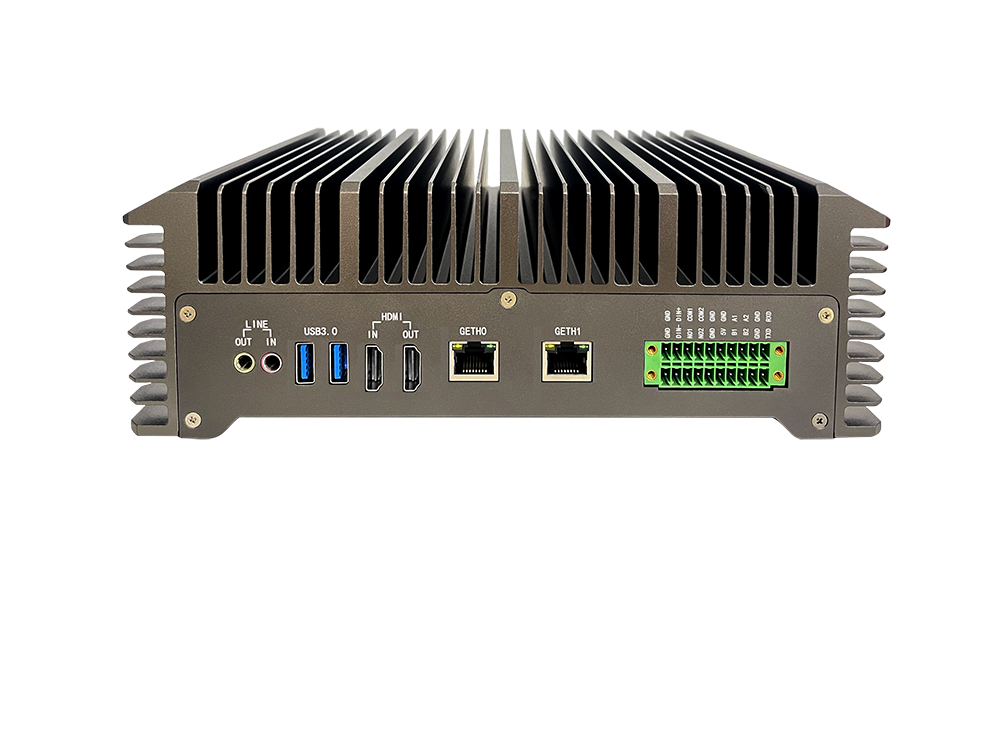
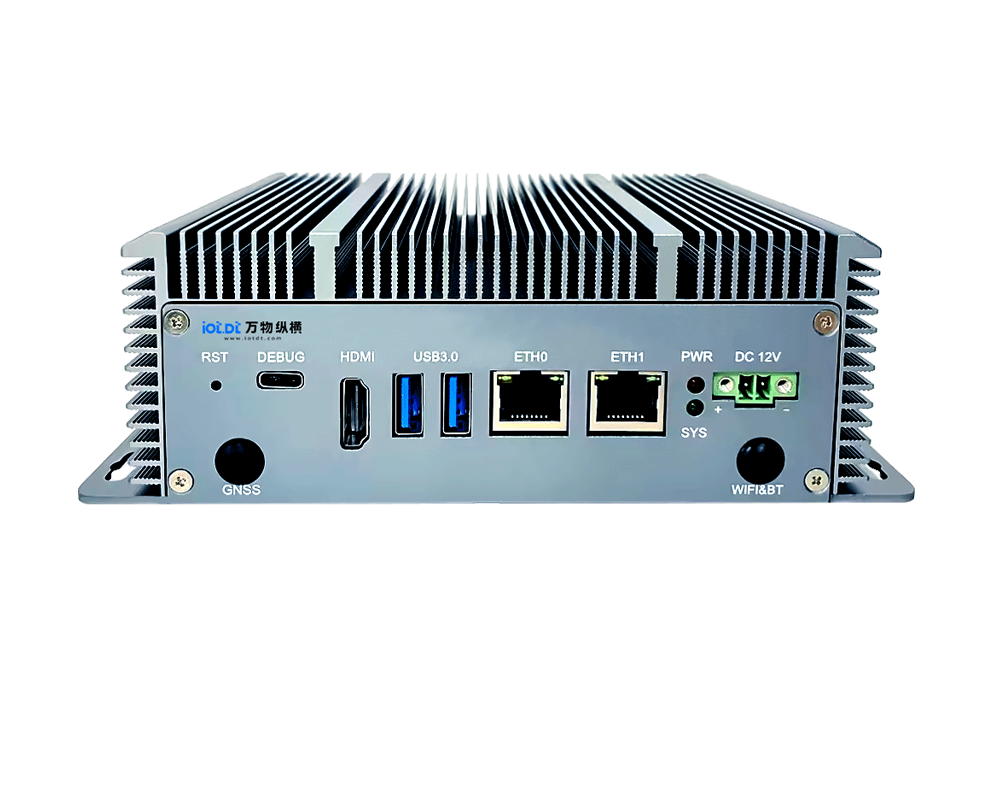
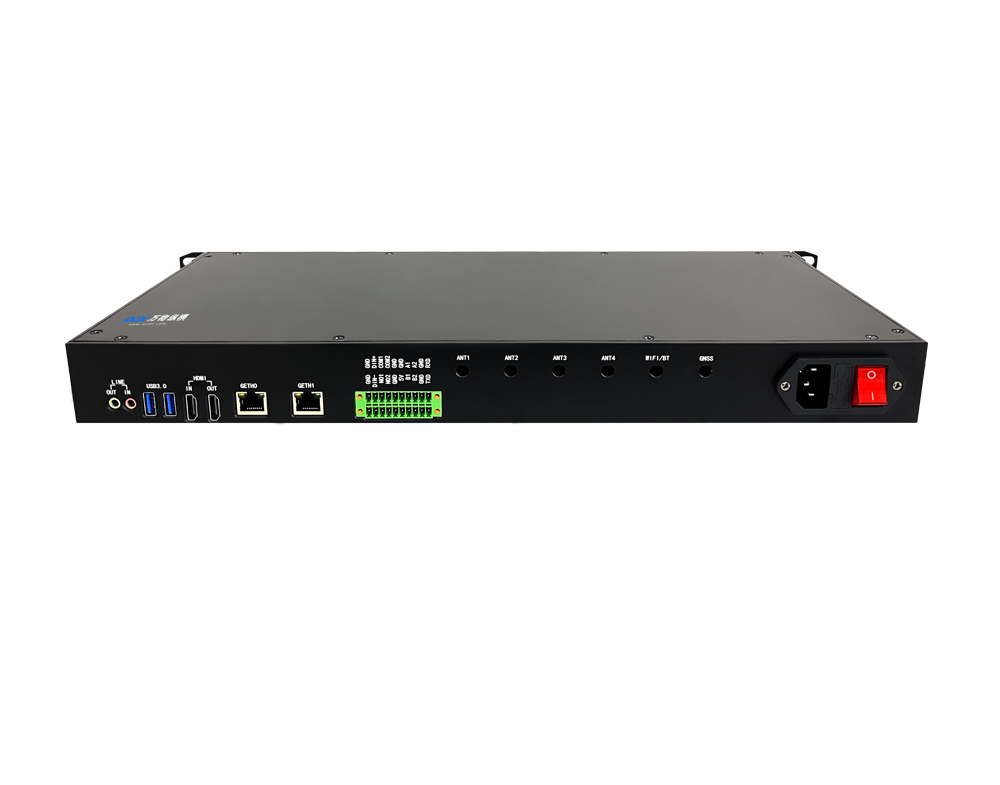
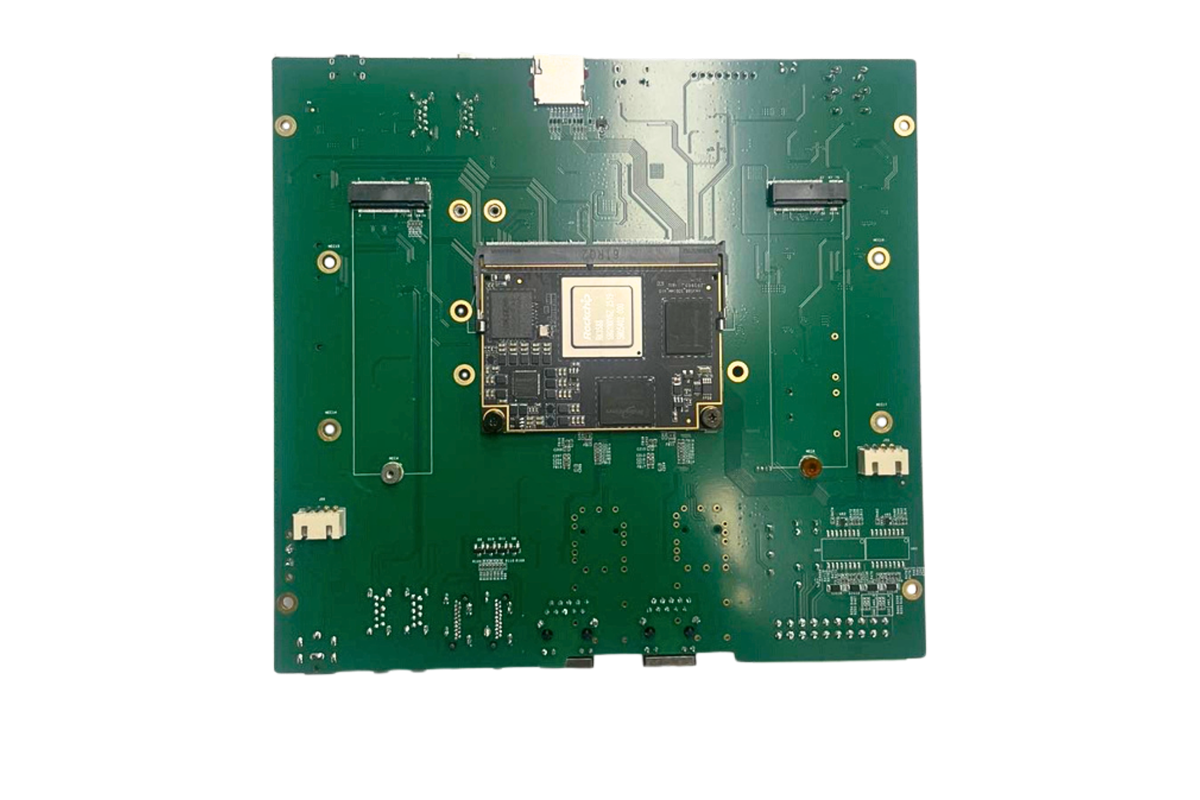
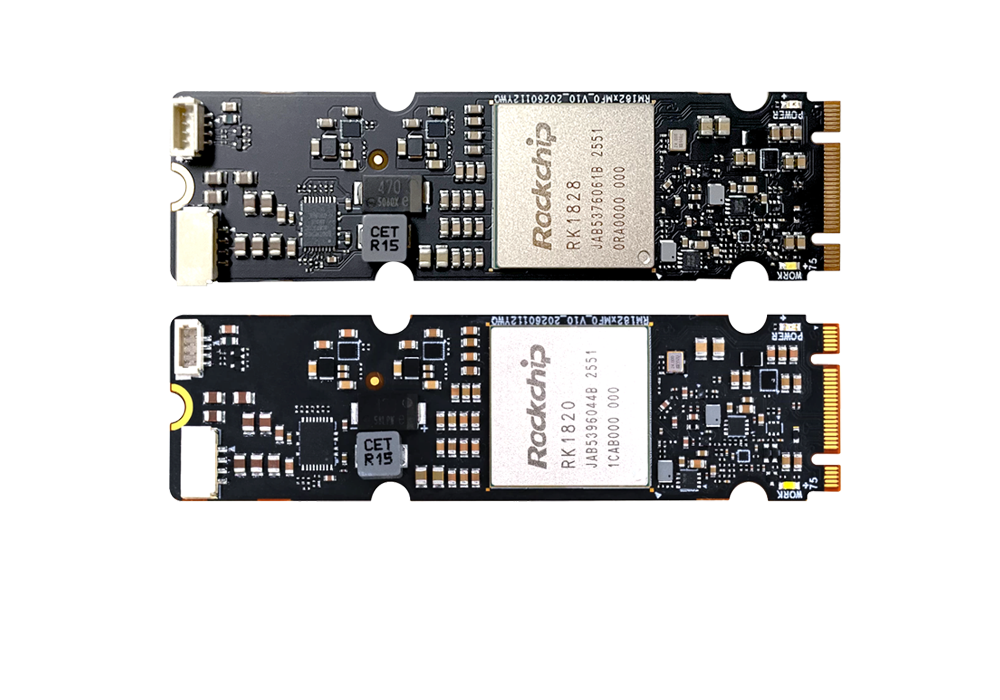
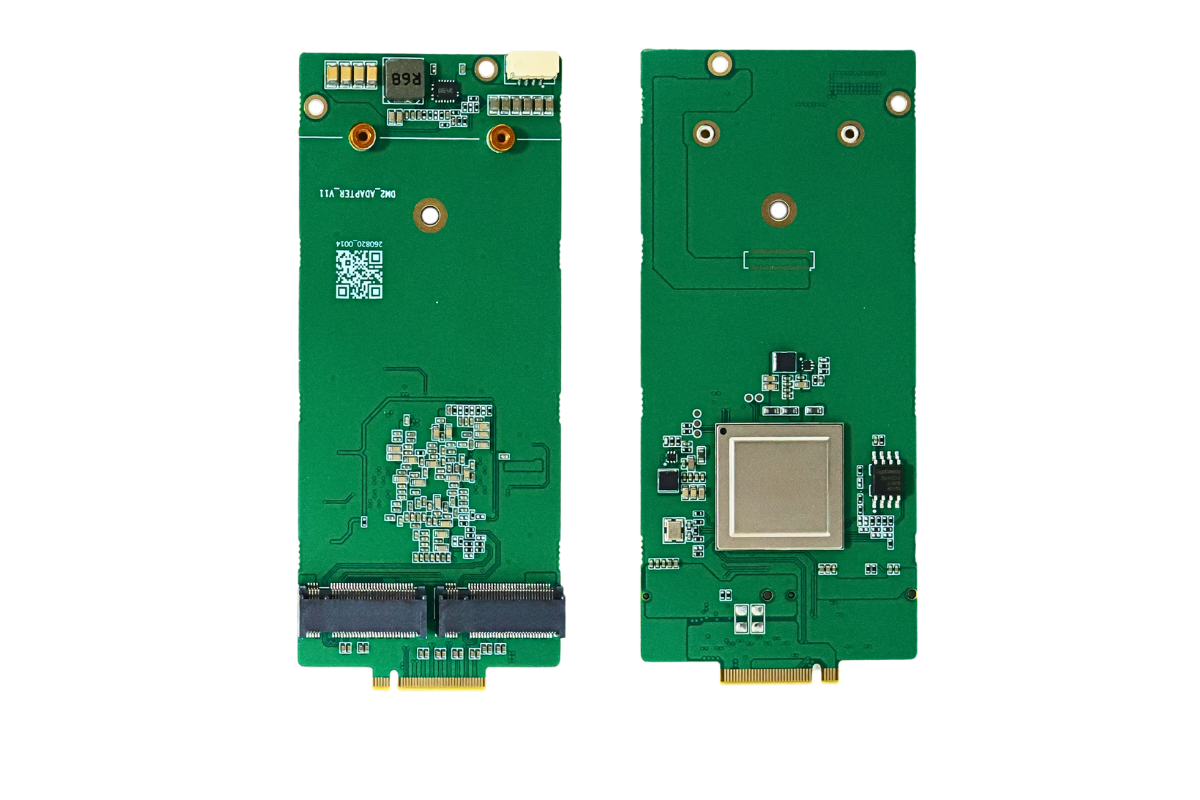


后摩智能力擎 LQ50 Duo双芯 M.2 算力卡配套边缘整机盒子现已完成内测验证,依托自研 C-to-C 芯片互联与大道软件栈调度优化,双 M50 存算一体芯片实现高效协同,并行推理吞吐相比单芯 LQ50 提升接近一倍,同时兼顾端边设备紧凑体积与功耗控制,适合私有化本地大模型部署场景。
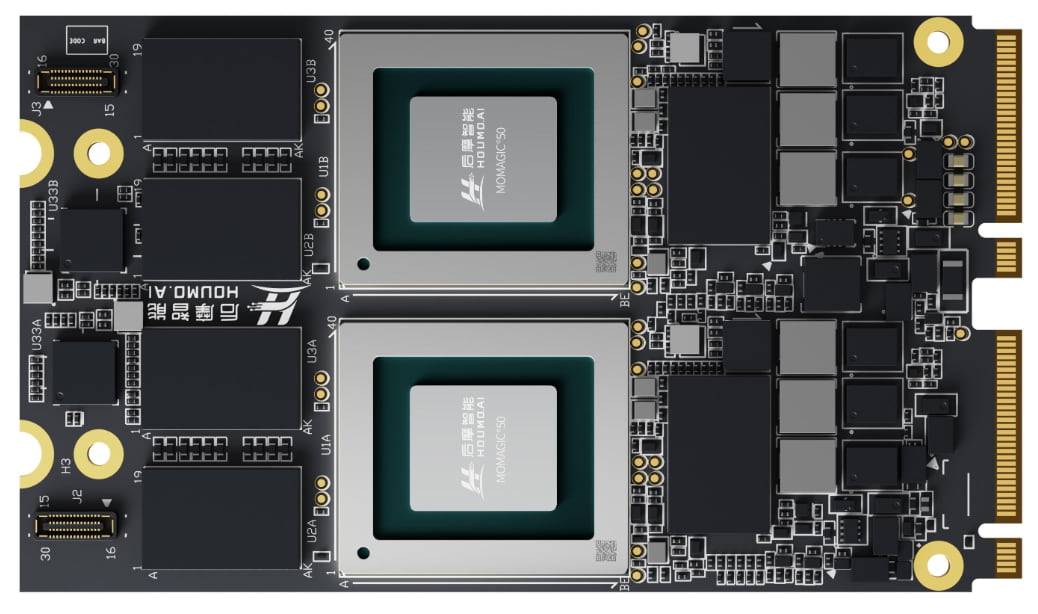
核心硬件规格(LQ50 Duo)
芯片:双颗漫界 M50 存算一体芯片
算力:320 TOPS INT8 / 200 TFLOPS bFP16(单芯 160TOPS)
显存:板载最高48GB LPDDR5/LPDDR5X,总带宽 307.2GB/s
形态:Dual M.2 2280 规格,PCIe4.0 ×4 接口
单卡典型功耗:两颗芯片合计可控在低功耗区间,支持整机被动 / 轻散热方案
内测关键亮点
1. 双芯调度优化
后摩大道软件平台做了模型分片、负载均衡、显存协同管理,不是简单算力叠加,LLM、VLM 多模态任务可将模型权重拆分到两颗 M50 并行计算,token 吞吐接近线性提升,满足多并发对话、多路视觉分析需求,可稳定跑 14B~32B 参数大模型本地推理。
2. 整机盒子工程落地
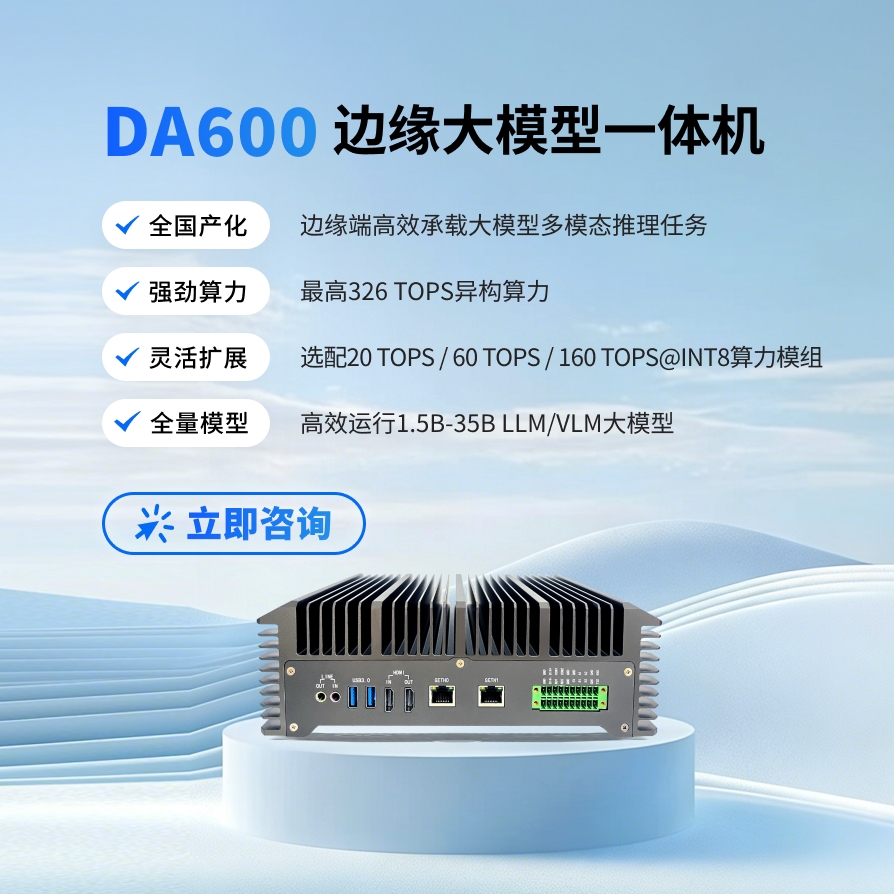
整机盒子为紧凑型边缘一体机形态,内置 LQ50 Duo 算力模组,主控 + 双芯存算一体异构架构,无需独立大显卡,适合机柜、工业箱、本地私有化机房部署;支持 Linux/Windows,开箱可部署 Qwen、Llama、多模态 VLM 等主流模型。
3. 场景适配
行业私有化大模型、本地 AI Agent
智慧工地、明厨亮灶多路视频 + 大模型分析
小型 AI 工作站、AI PC 高性能扩展
离线智能交互、数据不出内网场景
对比单芯 LQ50 收益
推理吞吐:↑近 100%
总显存容量翻倍,可承载更大参数模型或更多并发请求
内存带宽翻倍,大幅缓解大模型 KV 缓存带宽瓶颈
整机体积远小于传统 GPU 整机,功耗更低,无高噪音风扇方案可选
商业化价值
LQ50 Duo 整机盒子补齐了M.2 存算一体算力卡的交钥匙整机方案,客户不用自行做硬件底板、驱动适配、双芯调度开发,直接采购整机即可落地端边大模型,降低国产存算一体 AI 项目的集成门槛。
请用手机扫码查看分享内容
 下一篇:信创边缘计算新进展|RK3588/BM1684X 算力盒子完成银河麒麟 V10 深度适配
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)


 试用申请
 产品咨询
 在线客服
 回到顶部