
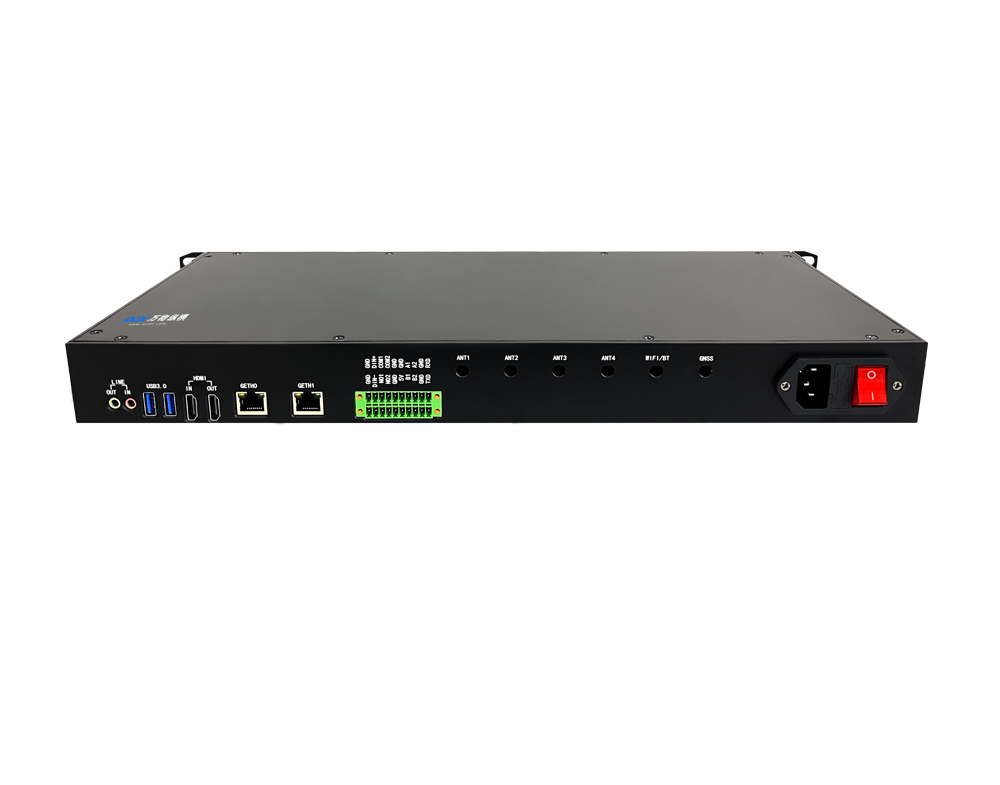
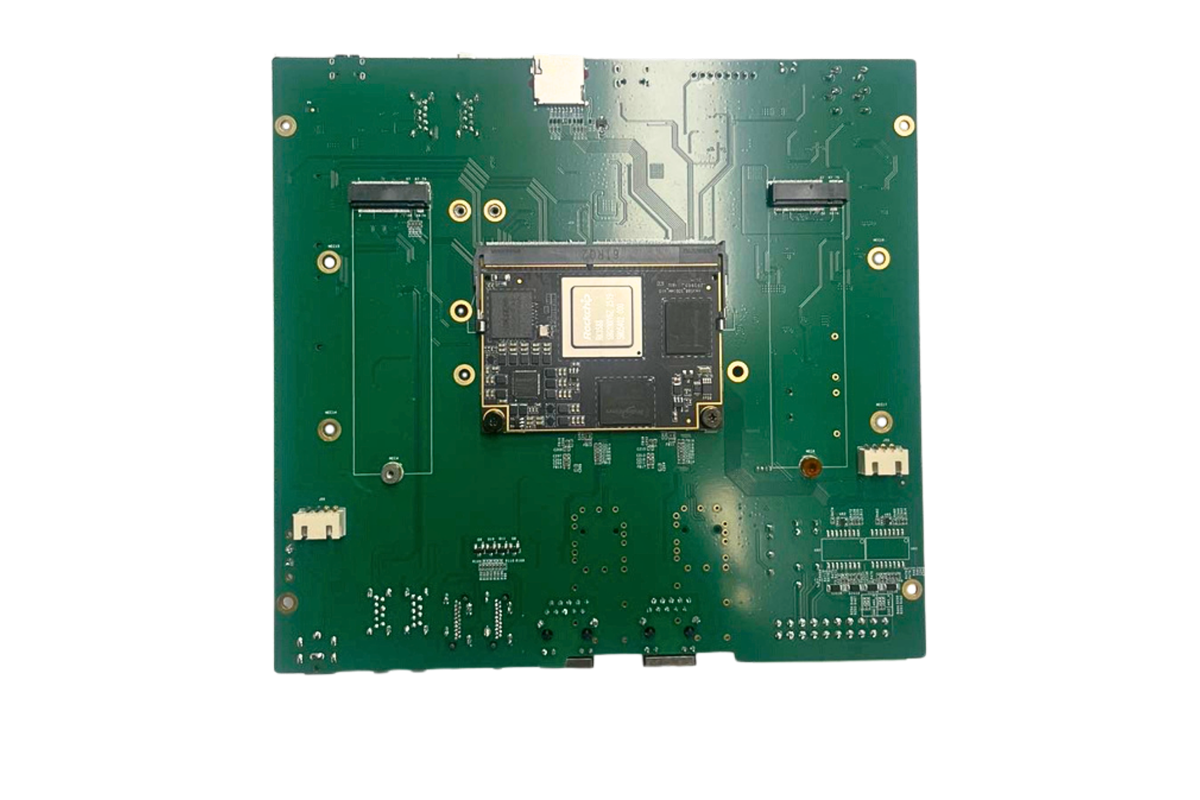
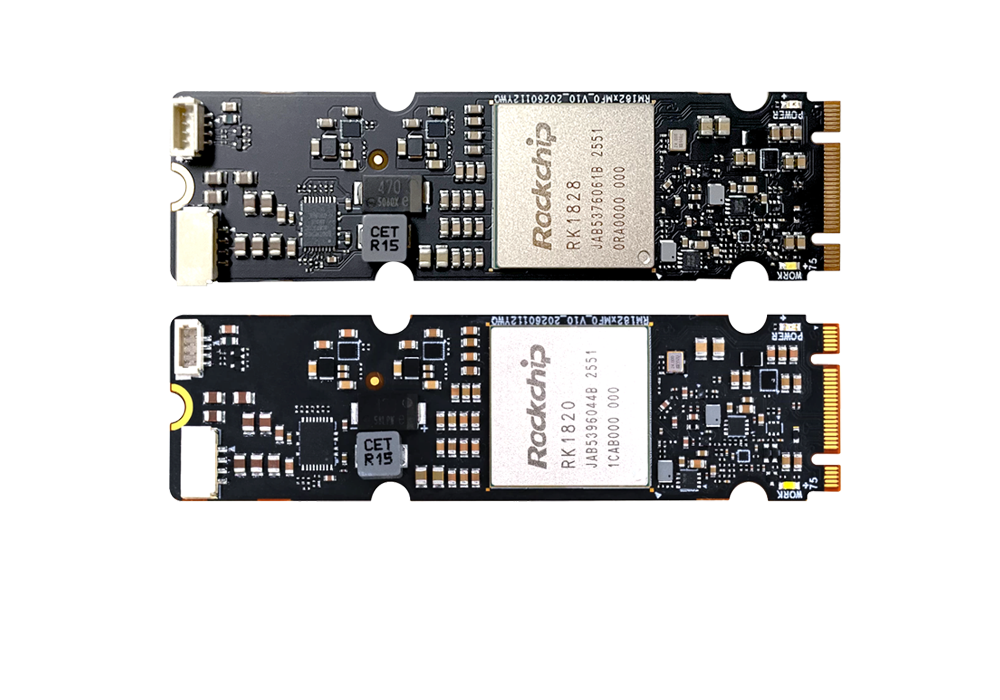


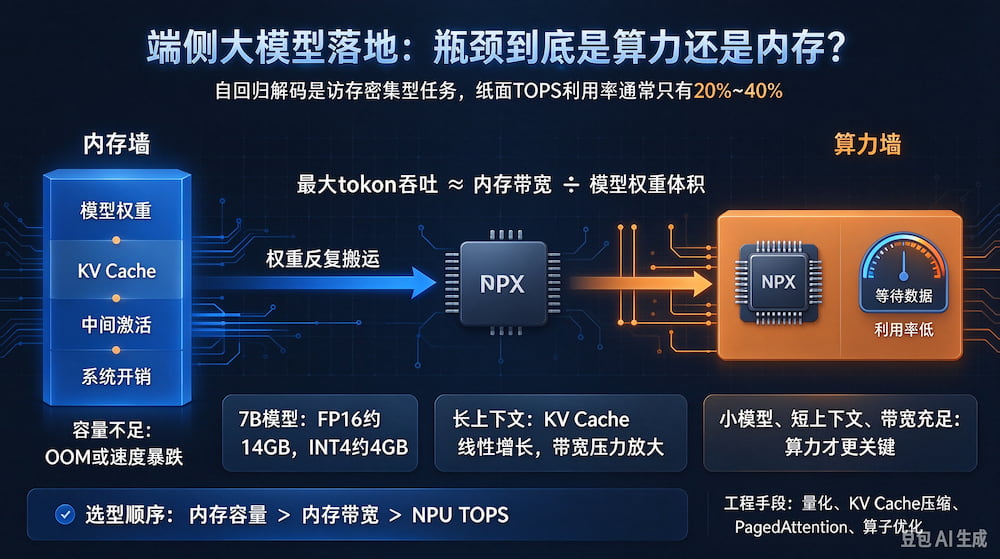
能不能跑起来:内存容量是第一道门槛;跑起来有多快:内存带宽是核心瓶颈;算力(TOPS)往往是最后才会摸到的上限。绝大多数算力盒子部署大模型,都是内存墙 > 算力墙。
Transformer 自回归解码(逐 Token 生成)属于访存密集型任务,不是计算密集型:每输出一个 token,都要反复读取模型权重,算力芯片大部分时间在空等数据搬运,纸面 TOPS 利用率经常只有 20%~40%。
1. 内存容量:决定 “能不能加载模型”(准入门槛)
内存容量 = 模型权重 + KV Cache + 中间激活张量 + 系统开销
7B 模型:FP16 约 14GB 权重;INT4 量化后约 4GB 权重。但长上下文下 KV Cache 会线性上涨,4K 上下文 KV Cache 还要额外占用数 GB,加上系统开销,算力盒子通常需要≥16GB 内存才能稳定跑 7B 模型。
内存不够:直接 OOM,模型根本无法启动;就算用 mmap / 磁盘交换勉强加载,速度会暴跌到不可用。
选型顺序:先看内存容量,决定能上多大参数模型;再看内存带宽,决定 token 生成速度;最后才看 NPU 算力 TOPS。
2. 内存带宽:决定 “推理速度上限”(运行瓶颈)
算力盒子的常见痛点:芯片 TOPS 标得很高,但 LPDDR 带宽很低。
公式简化:最大 token 吞吐 ≈ 内存带宽 / 模型权重体积
举个例子:7B INT4 权重 4GB,如果内存带宽只有 20GB/s,理论上限也就 5 token/s;哪怕 NPU 纸面算力再高,也无法突破这个上限,NPU 一直在等内存把权重送过来。
短上下文场景:带宽压力相对小;
长上下文场景:KV Cache 持续膨胀,带宽压力会急剧放大,带宽瓶颈会更加突出。
3. NPU 算力:什么时候才会变成瓶颈?
只有满足下面条件,算力才会成为瓶颈:
1. 模型很小(1B 以内);
2. 上下文很短;
3. 内存带宽充足,数据可以持续喂给 NPU;
4. Prefill(预填充输入 prompt)阶段(Prefill 是计算密集,算力更容易吃满)。
解码阶段(逐字输出)几乎永远是内存带宽受限。
4. 算力盒子落地里容易踩的坑
1. 只看宣传 TOPS,忽略内存规格:很多国产 NPU 盒子 TOPS 很高,但只配 4GB/8GB 低带宽 LPDDR,7B 模型根本跑不动或者速度极慢;
2. 低估 KV Cache 开销:很多人只算模型权重,忽略对话变长后 KV Cache 吃掉大量内存,多并发场景会直接爆内存;
3. 算力与内存带宽不匹配:NPU 算力过剩,但内存带宽跟不上,算力利用率极低;
4. 额外隐性约束:功耗、散热、算子支持度。就算内存和算力都够,如果算子不支持,会回落 CPU 推理,直接卡死速度。
5. 选型判断表
场景 | 核心瓶颈 | 优先硬件指标 |
7B 及以上大模型,多轮对话、长上下文 | 内存容量 + 内存带宽 | 内存容量 > 带宽 > TOPS |
1B 以内小模型,短 prompt,简单问答 | NPU 算力 | TOPS,其次带宽 |
Prefill 输入大量文本 | 算力 + 带宽 | TOPS、片上 SRAM、内存带宽 |
6. 工程缓解手段
量化:INT4/INT8,压缩权重体积,降低访存压力;
KV Cache 压缩、PagedAttention 分页 KV 缓存;
模型分块推理,权重 offload 到存储(代价:速度下降);
算子优化、片上 SRAM 复用,减少外部 DRAM 反复搬运。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部