
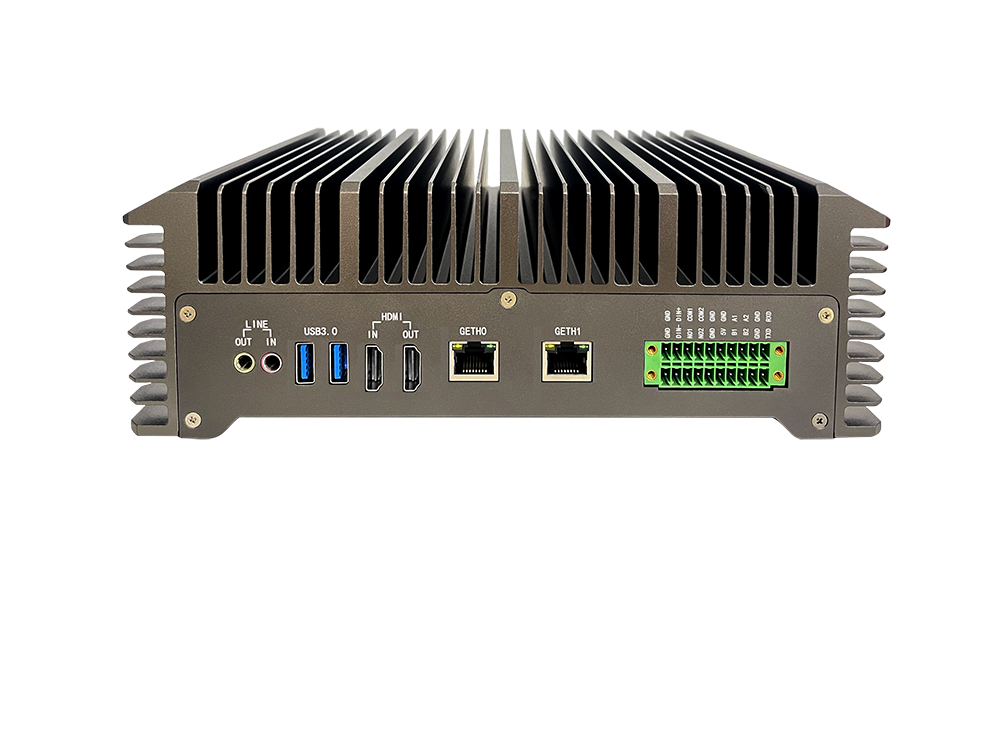
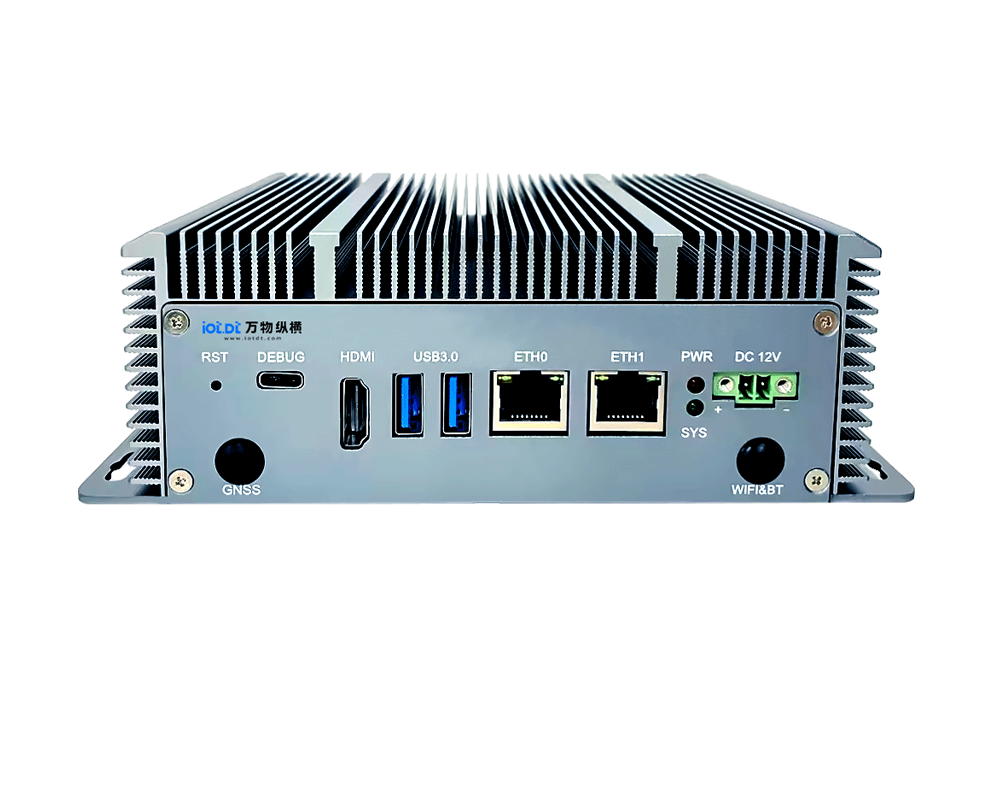
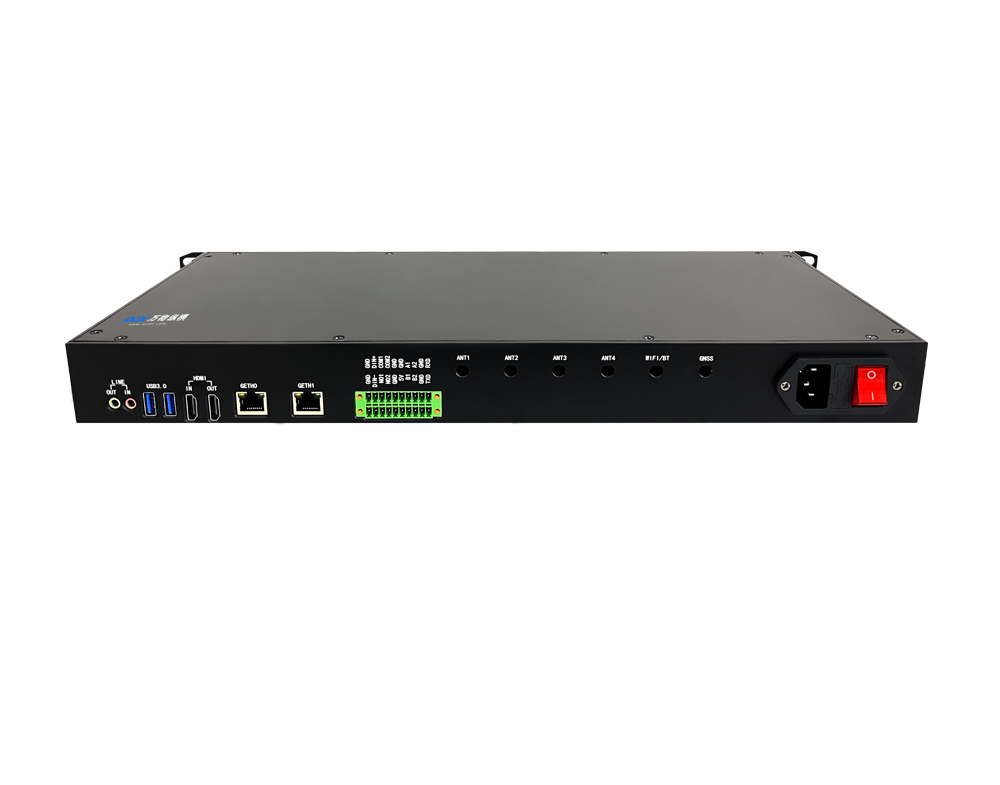
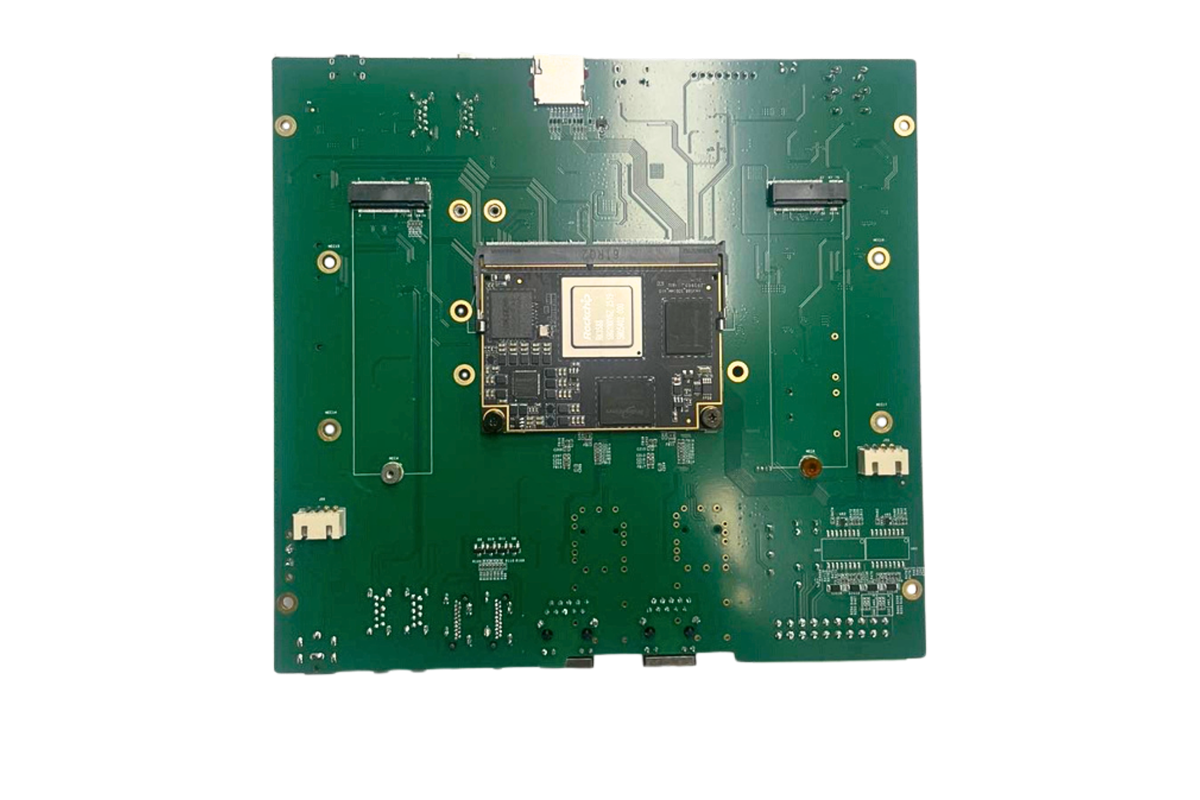
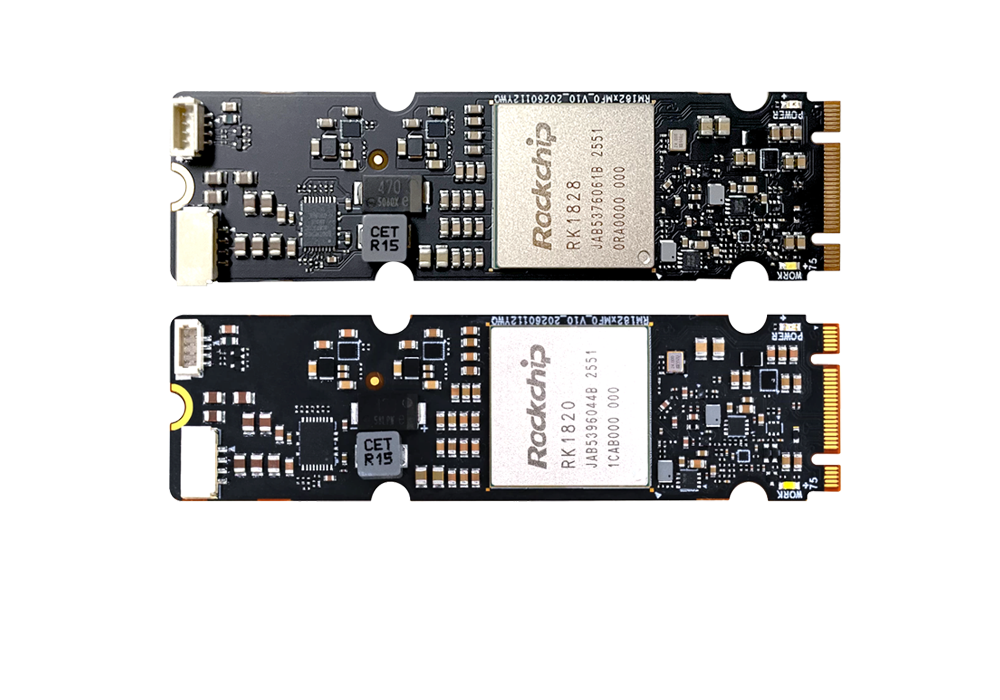


测算前提:同等 AI 推理算力基准(20TOPS INT8,跑 7B/8B 本地大模型、多模态 VLM,边缘 AI 盒子 / 工控整机场景,批量采购 BOM,不含软件、结构、装配、税费)
对比对象:方案 A:RK 主控主板 + RK1828 M.2 2280 算力卡;方案 B:同算力等级独立标准 PCIe 全高算力卡方案
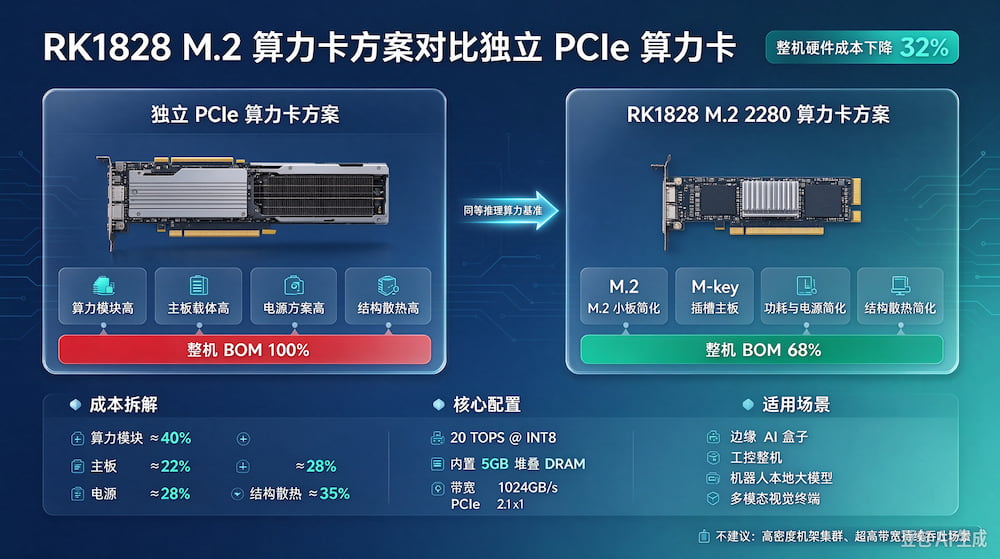
一、核心 BOM 成本拆解(成本下降 32% 来源)
成本项 | 独立 PCIe 算力卡方案 | RK1828 M.2 算力卡方案 | 成本节约说明 |
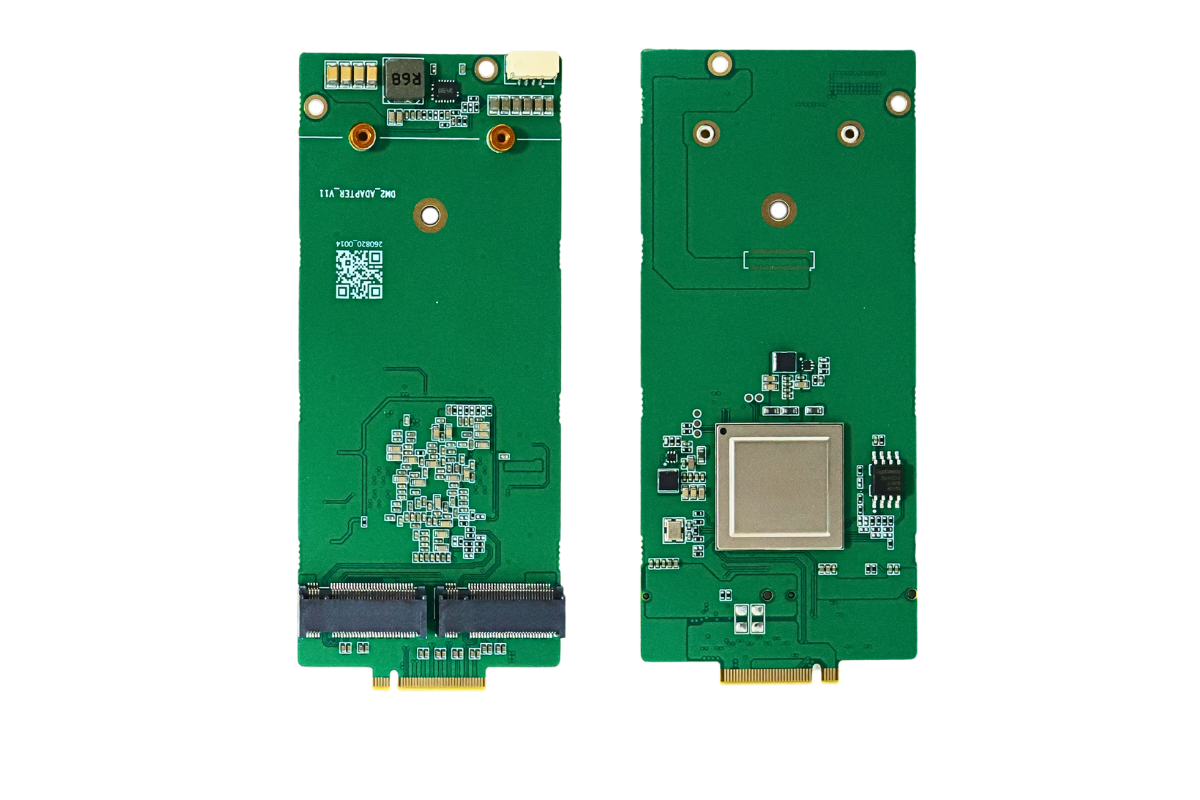
算力模块本身 | 高:完整 PCIe 金手指、电源管理、屏蔽罩、PCB 面积大、外接供电电路、散热片 | 低:M.2 2280 小板,无标准 PCIe 大 PCB、简化电源,RK1828 内置 5GB 3D 堆叠 DRAM,不用外挂颗粒 | 单项降幅≈40%,M.2 形态省去 PCIe 卡壳料、屏蔽件、大散热器 |
主板载体 | 需要带标准 PCIe 插槽主板,主板 PCB 更大、PCIe 信号 / 电源电路、ESD 防护成本高 | 仅需主板预留 M.2 M-key 插槽,PCB 精简,PCIe 2.1×1 链路,电路简单 | 主板 BOM 下降约 22%,ARM 主控主板原生支持,无需 x86 平台 |
电源方案 | 独立 PCIe 卡功耗更高,需要更大 DC-DC、更大电源适配器 | RK1828 功耗低,M.2 供电为主,辅助供电线路简化,电源规格降低 | 电源 BOM 下降约 28% |
结构 & 散热 | PCIe 卡需要机箱 PCIe 挡板、大散热、风道设计;机箱空间要求高 | M.2 卡体积小,小型铝散热片即可,机箱尺寸缩小,结构件简化 | 结构散热 BOM 下降约 35% |
整机合计 BOM | 基准 100% | 68% | 整机硬件 BOM 下降 32% |
二、性能边界(集成商重点关注点)
✅ 持平能力:20TOPS@INT8,内置 5GB HBM 堆叠内存,带宽 1024GB/s,不占用主控系统内存;Qwen、DeepSeek、通义千问 7B/8B 本地推理,多路视频 + LLM 多模态并发,RKNN3 工具链完整,支持多卡级联扩展算力
✅ 接口:M.2 M-key,PCIe2.1 x1,可直接搭配 RK3588/RK3576 等 ARM 主控主板,无需 x86 主机,非常适合边缘盒子、智慧工地、明厨亮灶、机器人本地大模型场景
约束项
1. PCIe 带宽只有 PCIe2.1 x1,超高吞吐连续数据场景弱于标准 PCIe×4/×16 算力卡;纯大模型推理、多路视觉分析场景无瓶颈
2. M.2 散热上限有限,高负载长时间持续满载场景,需要做壳体散热优化;独立 PCIe 卡自带更大散热冗余
3. 多卡堆叠上限低于标准 PCIe 背板方案,适合 1~3 卡中小算力整机,不适合高密度机架集群
三、集成商选型价值总结
1. 成本收益:同等推理算力下整机硬件 BOM 直接降低 32%,对批量边缘 AI 盒子、AI 网关、本地大模型一体机项目,毛利率显著提升;小体积方案也降低整机物流成本
2. 集成优势:M.2 插卡式,模块化,主板设计复用性强;同一款主板可按需选配 0/1/2 片 RK1828,灵活梯度算力,SKU 简化
3. 场景适配:优先推荐:边缘 AI 盒子、工控主机、机器人、车载 / 设备端本地大模型、视频 + LLM 多模态;不推荐:高密度机架服务器、超高带宽持续吞吐推理场景
四、总结
边缘 AI 整机集成商 BOM 实测:采用 RK1828 M.2 2280 算力卡方案替代同算力独立 PCIe 算力卡,保持 20TOPS 推理性能、内置 5GB 高带宽显存,整机硬件 BOM 成本下降 32%,非常适合本地 7B/8B 大模型、多模态视觉 AI 终端批量落地。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部