
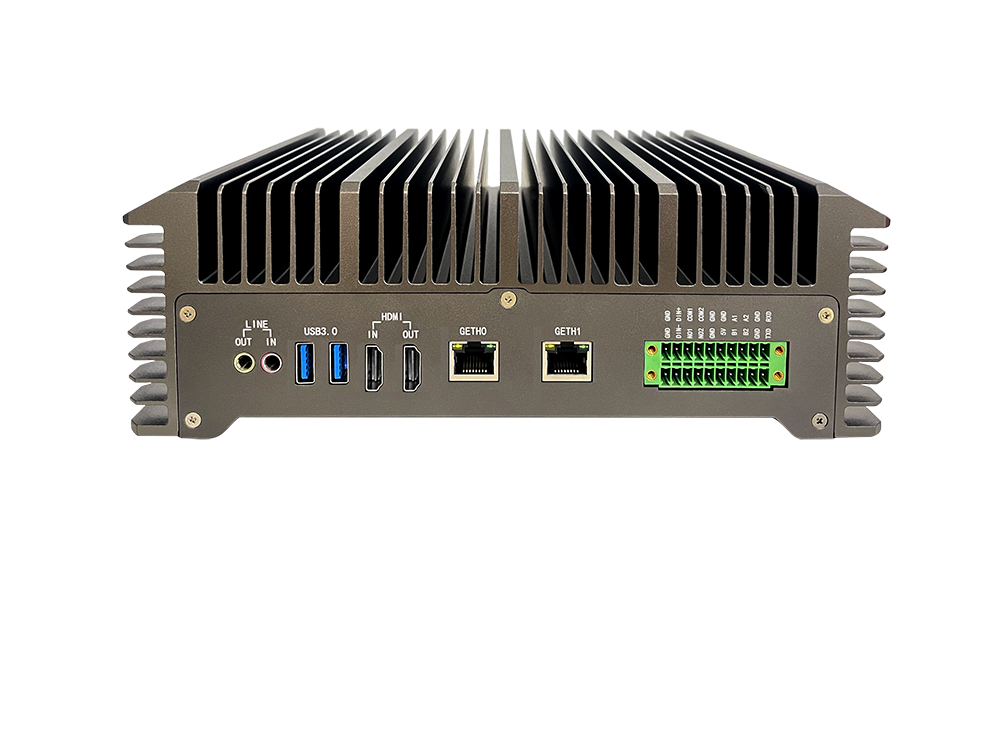
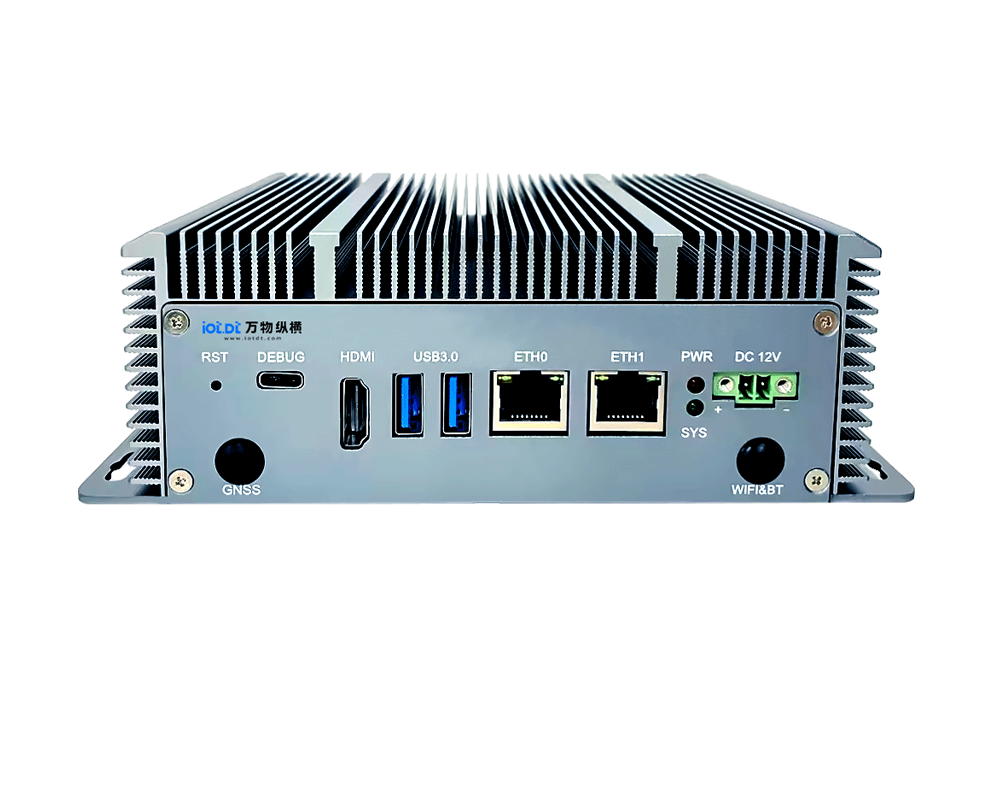
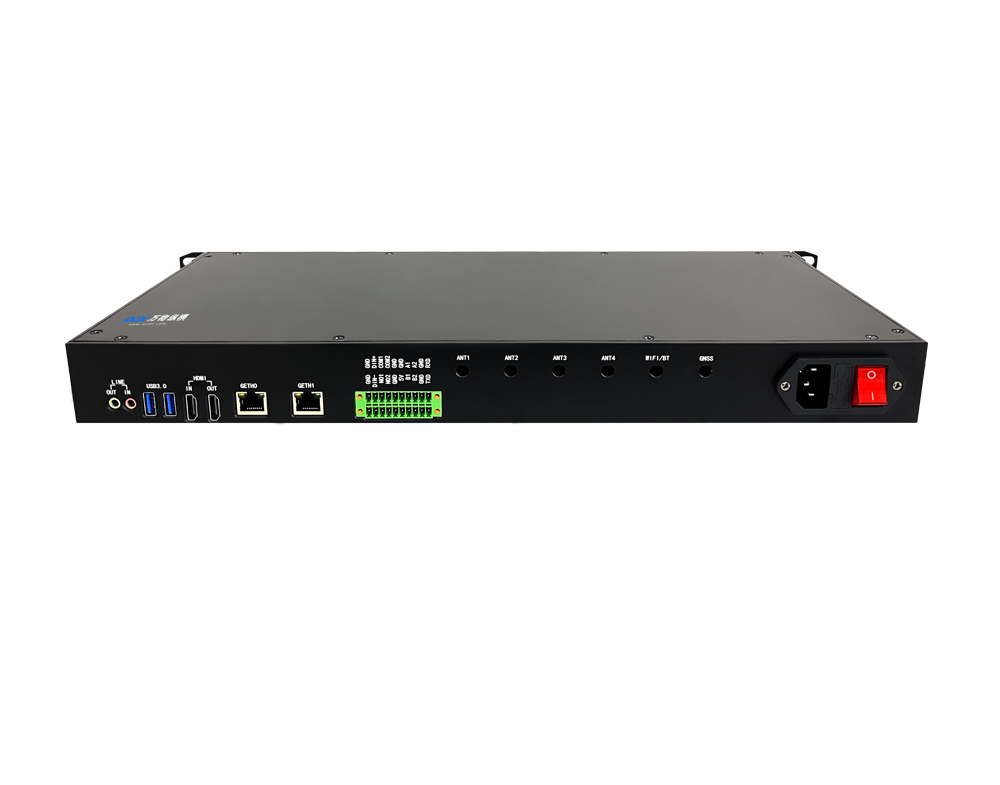
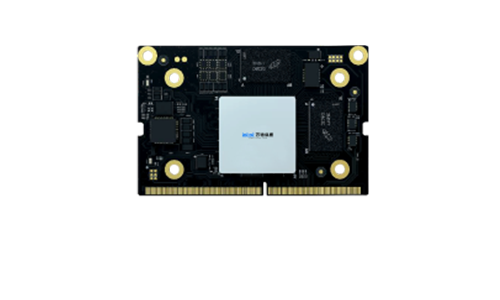
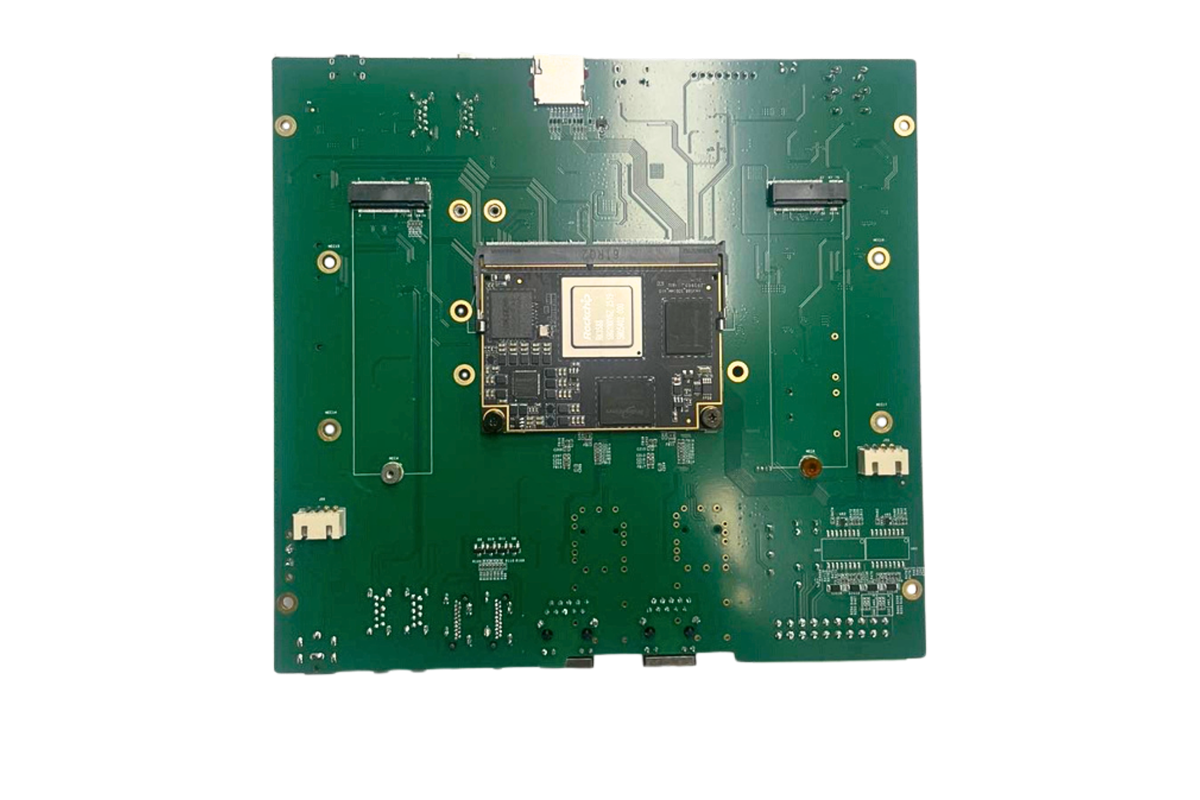
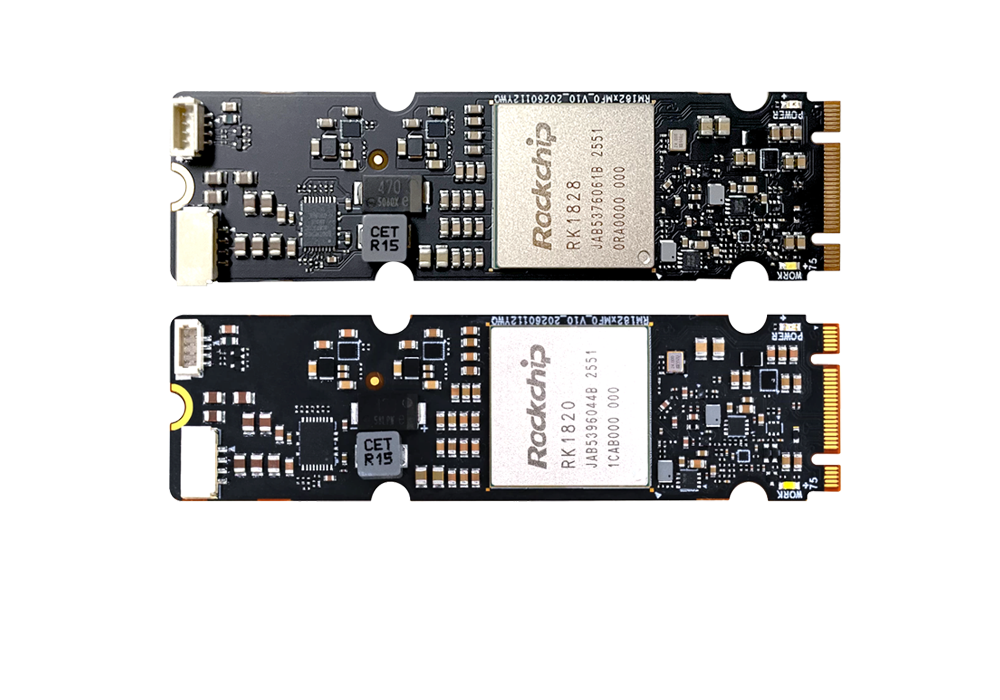
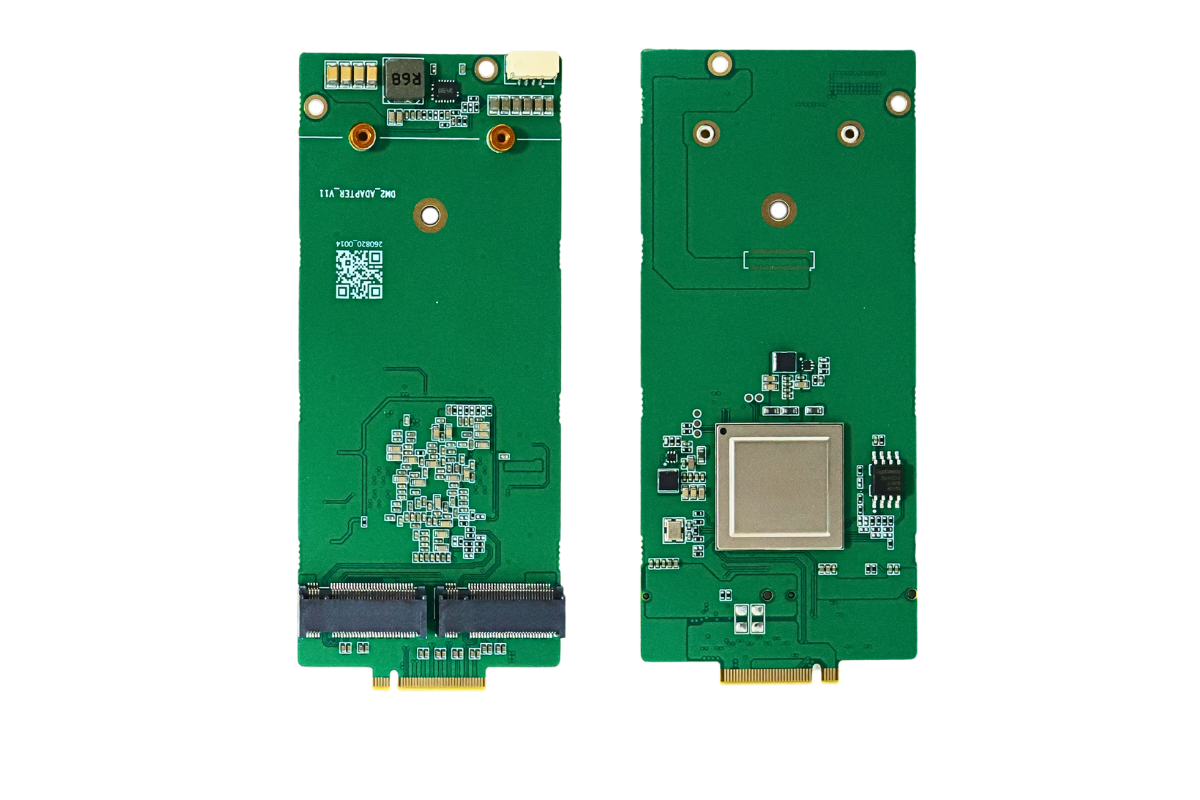


瑞芯微在工博会展出RK3588+RK1828异构协扩展方案:RK3588原生NPU算力 6TOPS(INT8),搭配单颗RK1828 AI协处理器(20TOPS INT8),整套AI盒子合计26TOPS;支持双RK1828级联,算力可达46TOPS。
芯片架构说明
RK3588(主控SoC)
负责系统调度、视频编解码、图像前处理、显示输出、外设控制;自带6TOPS NPU,原有RK3588盒子算力上限就是6TOPS,跑大模型受带宽与算力瓶颈限制。
定位纯AI加速卡,不跑操作系统,3D堆叠内置5GB片上高带宽DRAM,专门解决大模型推理的显存带宽瓶颈;NPU算力20TOPS INT8,支持INT4/INT8/FP16/BF16混合精度,通过PCIe 3.0高速接口和RK3588对接,任务卸载式协同计算。
方案技术亮点
存量硬件升级:现有RK3588盒子无需更换主控,增加RK1828算力模块即可大幅提升AI算力,是边缘盒子低成本算力扩容路线;
RKNN3 SDK完整支撑,Linux/Android双系统,兼容OpenAI API,降低大模型开发门槛;支持3B~7B,最高可跑8B参数大模型本地离线推理;
场景演示(工博会):4路视频并发分析、视频内容摘要,响应最快0.5s;Qwen多模态VLM、工业视觉检测、机器人端侧Agent、智能巡检、数字人等演示,适合智慧工地、明厨亮灶、工业质检、安防NVR、服务机器人。
算力组合清单
硬件组合 | 总NPU算力 | 典型场景 |
仅RK3588 | 6TOPS | 常规视觉识别,轻量算法 |
RK3588 + 单RK1828 | 26TOPS | 4路视频分析、7B多模态大模型 |
RK3588 + 双RK1828 | 46TOPS | 8~16路高清工业视觉、多路并发大模型Agent |
对比同类型边缘算力方案
优势:复用成熟 RK3588 主控生态,成本可控;RK1828 自带片上 DRAM,大模型推理不会占用 RK3588 的系统内存,带宽表现优于外置内存方案;支持单 / 双卡灵活选配。
局限:协处理器只做 AI 推理加速,不接管系统;PCIe 链路会带来少量数据交互开销,需要 RKNN3 SDK 做任务分片优化。
行业价值
这套主控+AI协处理器解耦扩展架构,代表国产边缘算力新路线:不再依赖单颗SoC无限堆算力,采用模块化算力叠加,传统工控盒、AI盒子、机器人主板都可以后期外挂算力卡升级,很适合工业、安防行业存量设备智能化改造。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部