


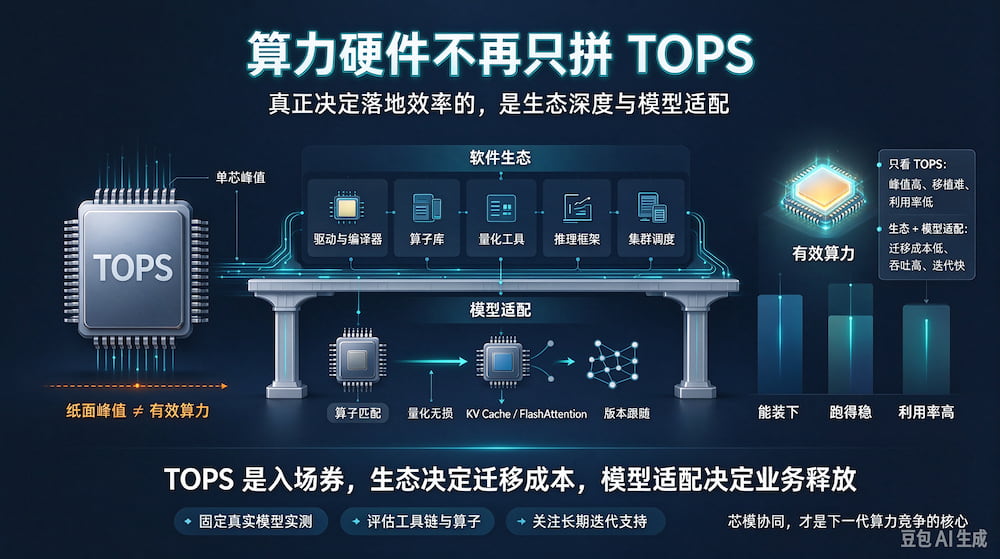
TOPS 只是纸面峰值算力,真正值钱的是"能跑起来、跑得稳、利用率高、迁移成本低"的有效算力,由软件生态与模型适配能力决定。
一、为什么 TOPS 参考价值越来越有限
TOPS 是理论峰值运算量,是理想工况下的上限,现实业务里会被大量因素打折:
1. 内存墙瓶颈:大模型、多模态推理的瓶颈往往不是计算,而是显存带宽、片上缓存、数据搬运。哪怕 TOPS 很高,显存不足,模型根本装不下,算力直接闲置。
2. 算子不匹配:硬件支持的算子和模型用到的算子不一致,编译器无法优化,只能降级、用低效算子模拟,纸面算力折半甚至只剩 20%~30% 可用。
3. 精度限制:很多芯片 TOPS 基于 INT8 统计;跑 BF16/FP16 大模型推理时,实际算力会大幅缩水,厂商宣传口径容易混淆精度。
4. 多芯级联损耗:单芯 TOPS 好看,但多卡/多芯片组网时,互联带宽、同步延迟会吃掉大量性能,集群效率暴跌。
行业现状:不少 AI 服务器纸面算力很高,真实业务算力利用率不足 30%,根源不是硬件,是软件栈、算子、模型适配问题。
二、生态到底包含什么
生态是一套完整的开发与运行体系,不是简单提供 SDK:
底层:驱动、编译器、算子库、量化工具、性能 Profile 调试工具链
框架层:PyTorch、ONNX、vLLM、SGLang、TensorRT 等主流推理框架原生支持程度
迁移层:模型转换难易、代码改动量、是否兼容 OpenAI API,降低 ISV/算法厂商移植成本
社区与伙伴:模型厂商、算法公司、行业 ISV、整机/模组厂商,形成验证闭环
运维层:多芯片调度、集群管理、故障排查、持续版本更新
CUDA 之所以长期难以撼动,核心就是二十年积累的完整生态,而不是单纯硬件 TOPS 更高。国产芯片的核心难点,就是摆脱"一芯一栈"碎片化问题。
三、模型适配:不是"能跑",而是"高效跑"
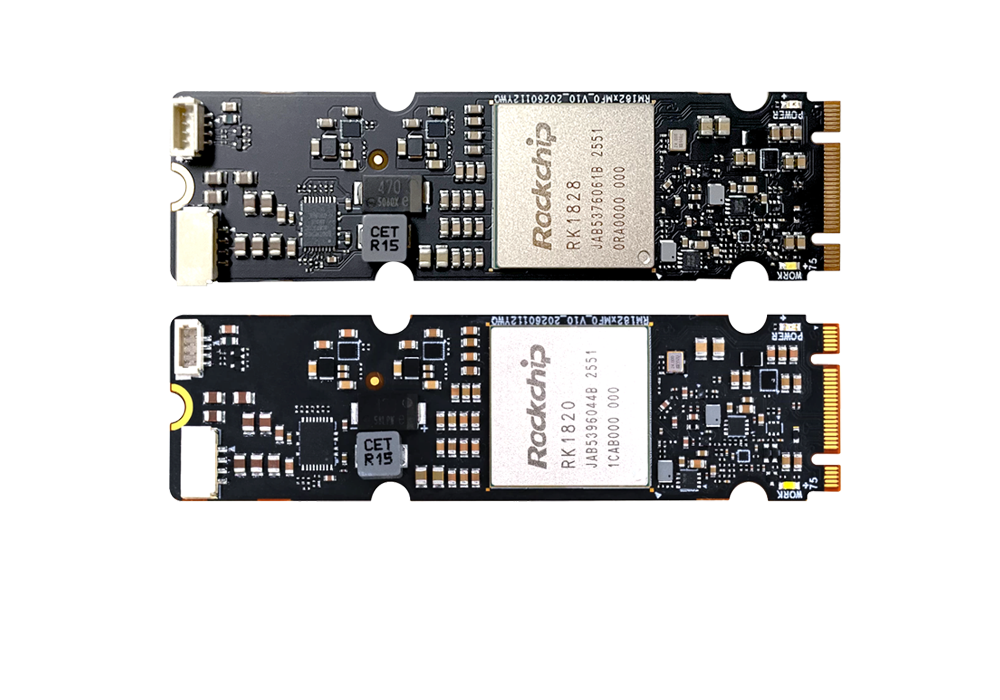
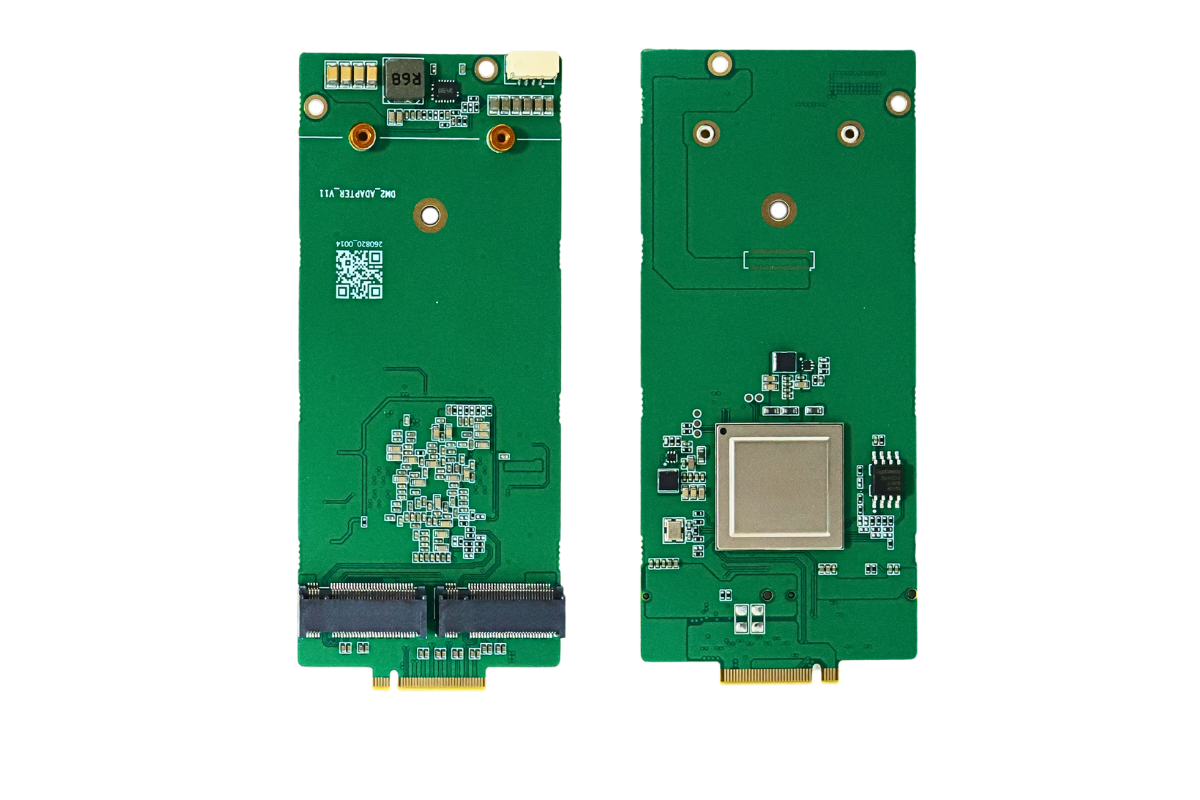
模型适配分几层,边缘/端侧算力(如摩 HM50、RK、算能、力擎 LQ50 这类)尤其看重:
1. 原生算子支持:LLM、VLM 视觉大模型、KV Cache、FlashAttention 等高频算子是否硬件加速,而不是软件模拟。
2. 量化适配:INT4/INT8/FP8 量化无损,支持模型权重分片、KV 缓存优化,直接决定单卡能跑多大模型、token 吞吐。
3. 场景调优:针对视频流、多路检测、Agent 多轮对话、工业/安防等业务做专项优化,固定场景下的时延、QPS、稳定性。
4. 版本跟随能力:大模型迭代很快(Qwen、Llama、DeepSeek 持续更新),芯片平台能不能快速跟上新版本,而不是半年才适配一次。
选型关键:看同一款模型在该硬件上的 token 吞吐、首 token 时延、显存占用,而不是芯片 TOPS 参数。
四、云端 vs 边缘硬件,侧重点差异
云端训练:看重大规模集群互联、统一内存、混合精度、分布式生态;TOPS 仍是门槛,但万卡集群的通信与调度生态才是规模化瓶颈。
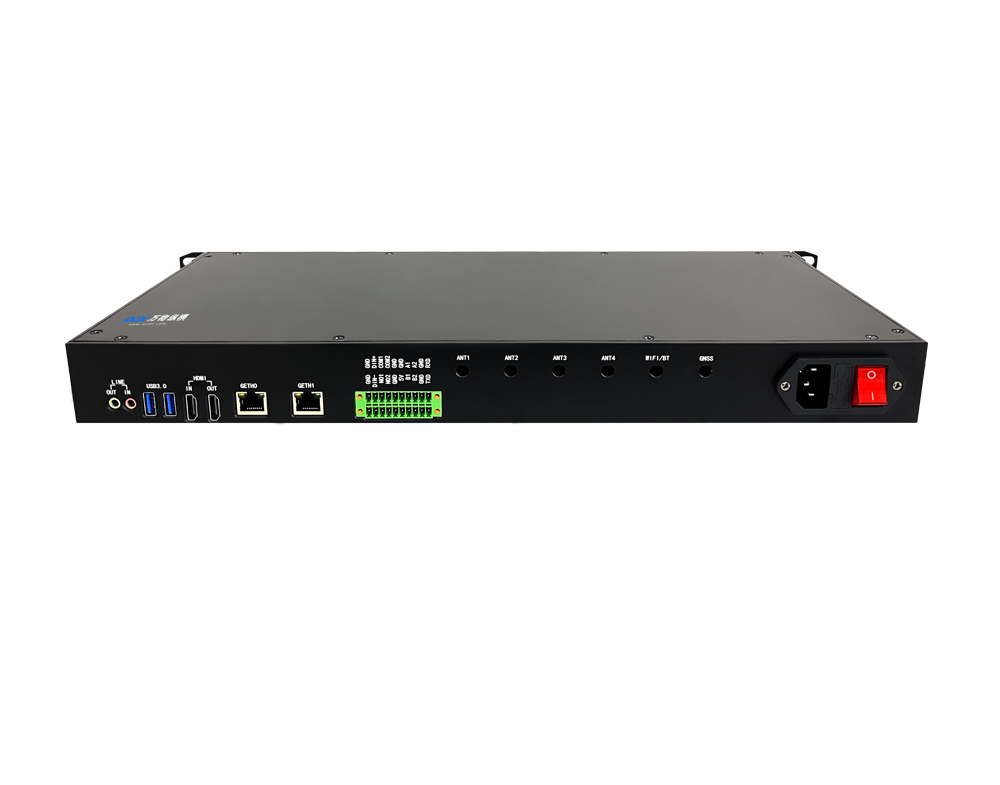
云端推理 / 边缘算力盒子、模组、核心板(摩 HM50 这类):生态与模型适配权重远高于 TOPS。客户买硬件,目标是部署算法、跑行业模型,最怕移植周期长、调优成本高、后续模型升级不兼容。很多边缘芯片 TOPS 很高,但主流 VLM、LLM 适配滞后,项目落地直接卡壳。
五、采购/选型的评估思路(替代单纯看 TOPS)
1. 固定待测模型:拿你业务真实模型(不要 Demo 小模型),实测 QPS、时延、显存占用、功耗。
2. 评估工具链:模型转换流程、量化精度损失、调试工具是否易用,评估人力移植成本。
3. 算子清单:核查 KV Cache、FlashAttention、MoE 路由等关键算子硬件加速支持。
4. 生态伙伴清单:有多少开源大模型、行业算法已经完成官方适配。
5. 长期支持:SDK 迭代节奏、社区活跃度、厂商技术支持响应速度。
六、总结
TOPS 只是入场门槛;生态决定好不好移植,模型适配决定真实业务能释放多少有效算力。未来算力硬件竞争,从硬件参数内卷,转向芯模协同、全栈交付、场景落地的系统性竞争。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部