
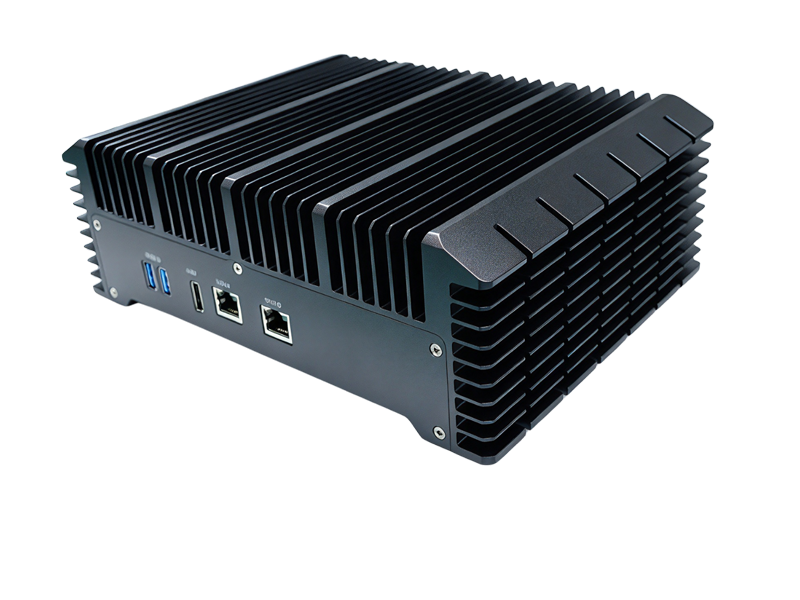
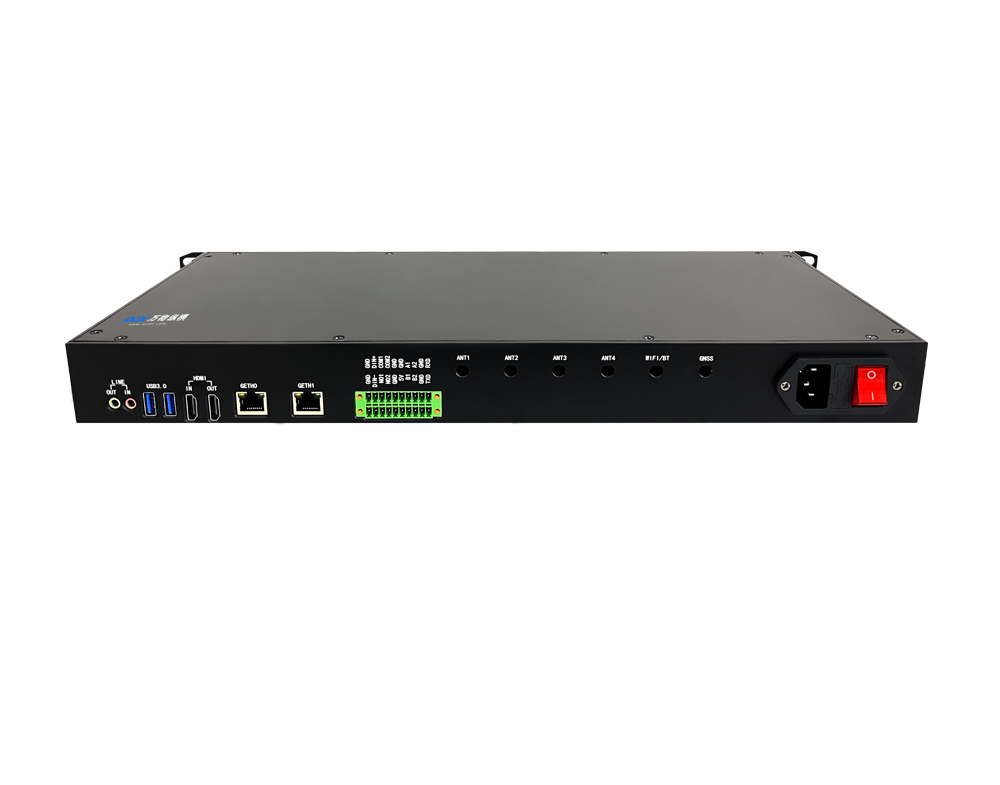
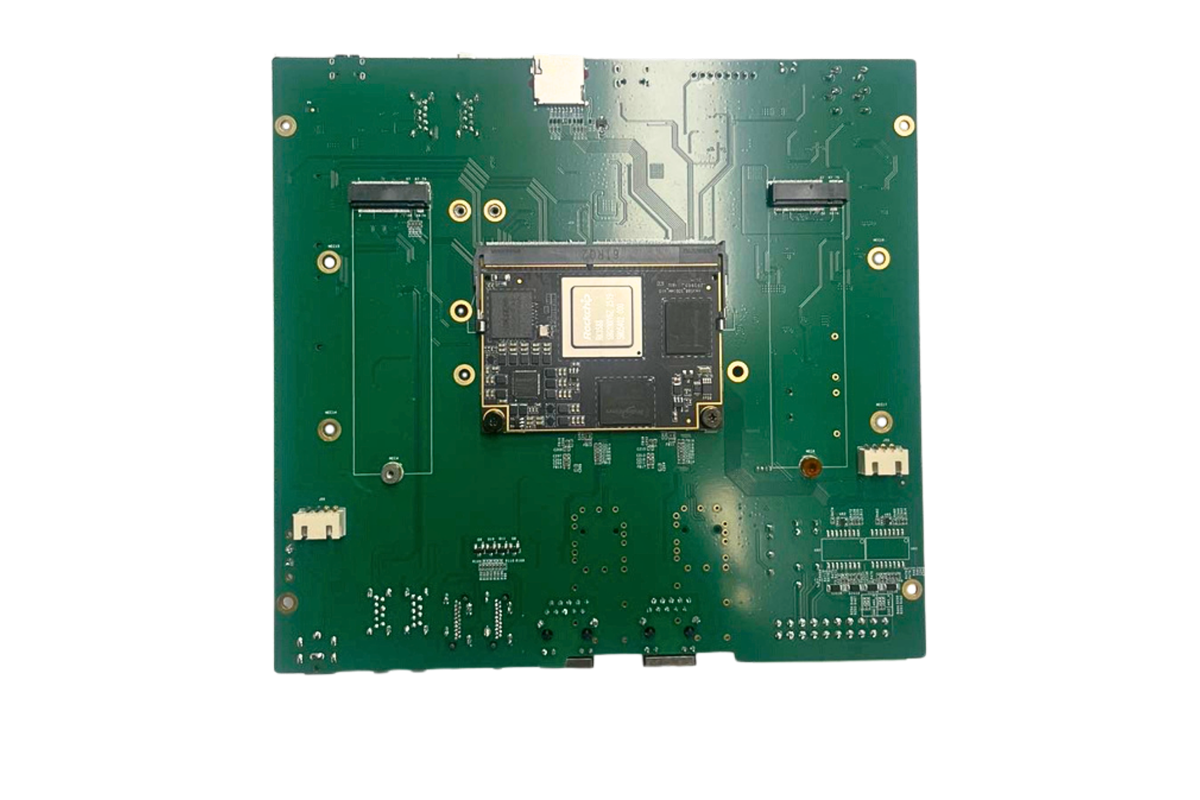
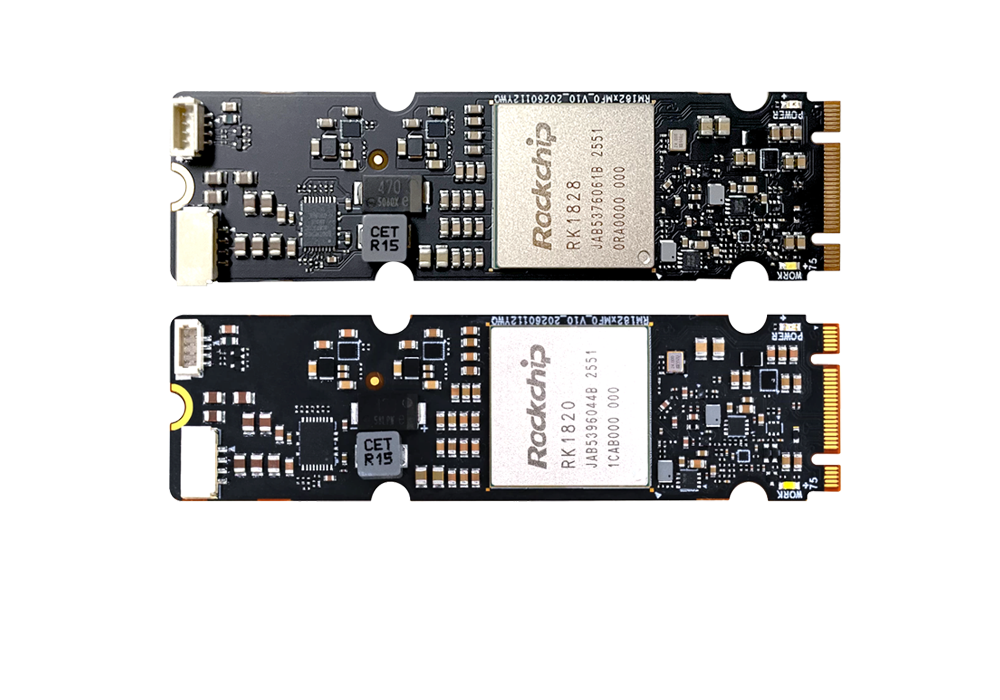
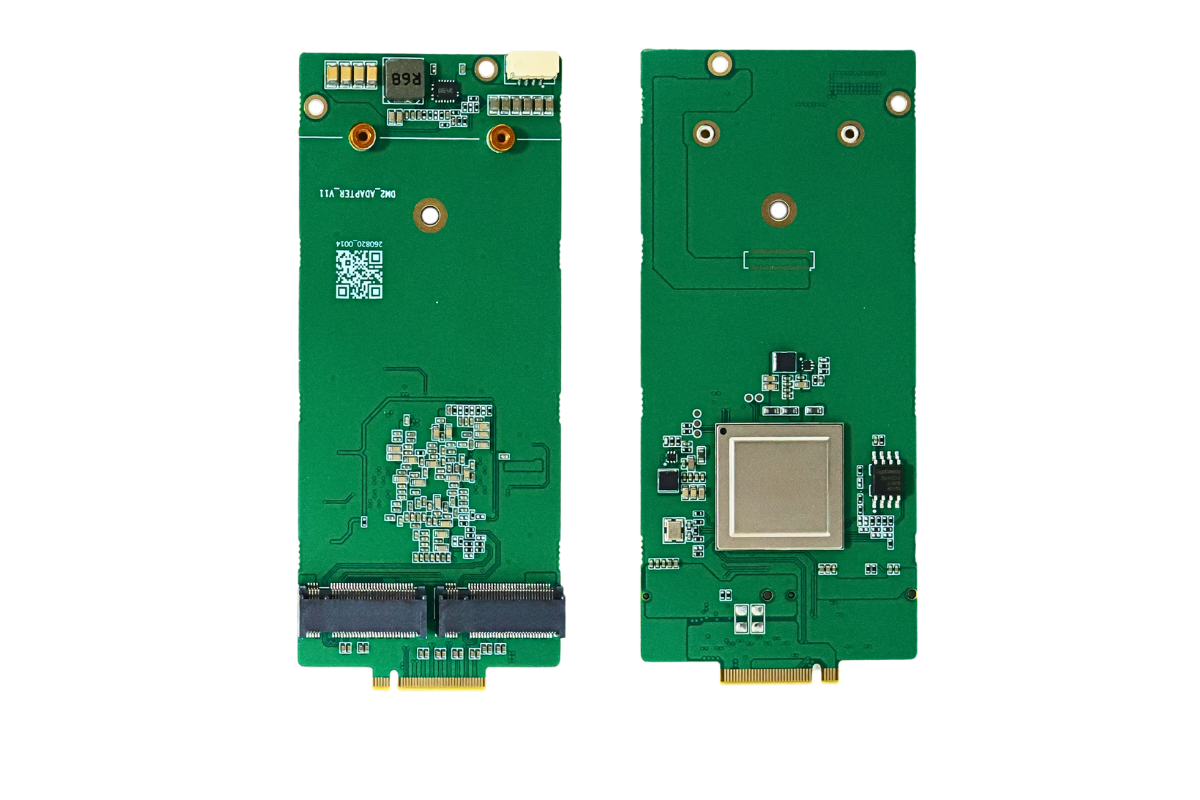


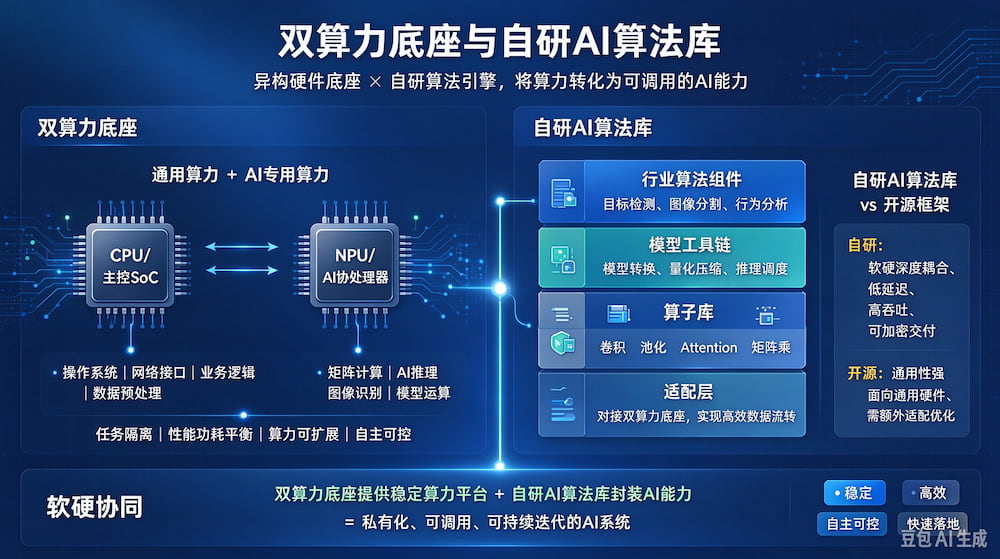
双算力底座是"硬件地基"(通用算力 + AI加速算力分工协同),自研AI算法库是"软件引擎"(基于自研算子与行业算法、深度适配硬件),两者软硬结合,把底层芯片能力转化为上层可直接调用的AI业务能力。
一、什么是双算力底座
双算力底座(也常叫双芯异构算力底座)是一套由硬件 + 底层调度软件构成的基础设施,由两类不同定位的算力单元组合协同工作——不是两颗一模一样的芯片并行,而是分工异构。
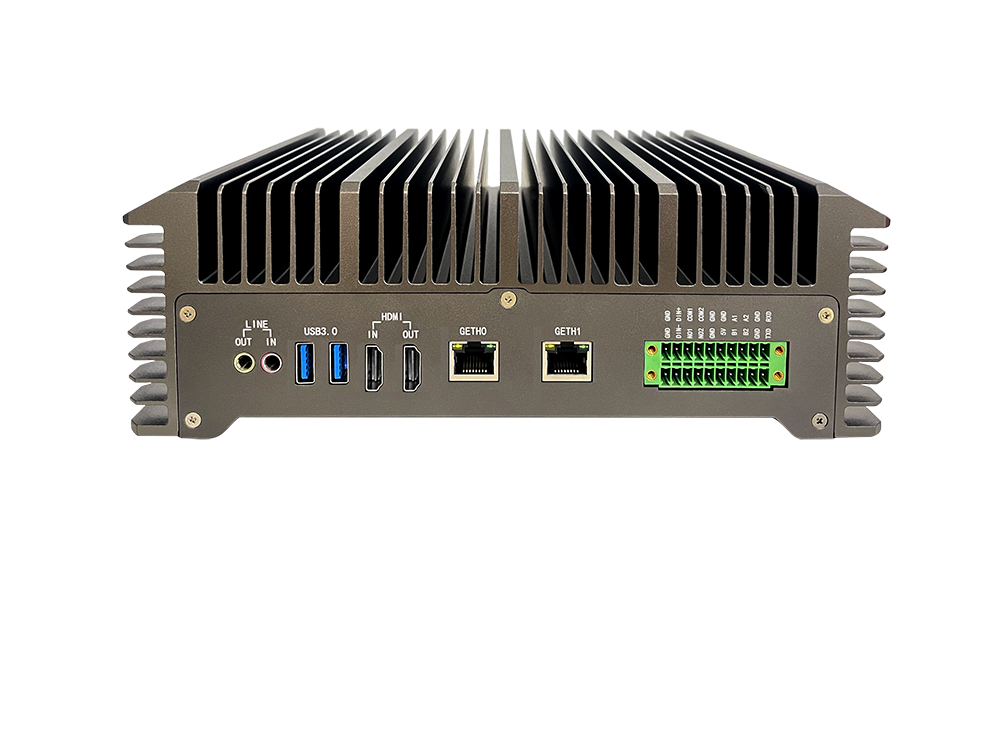
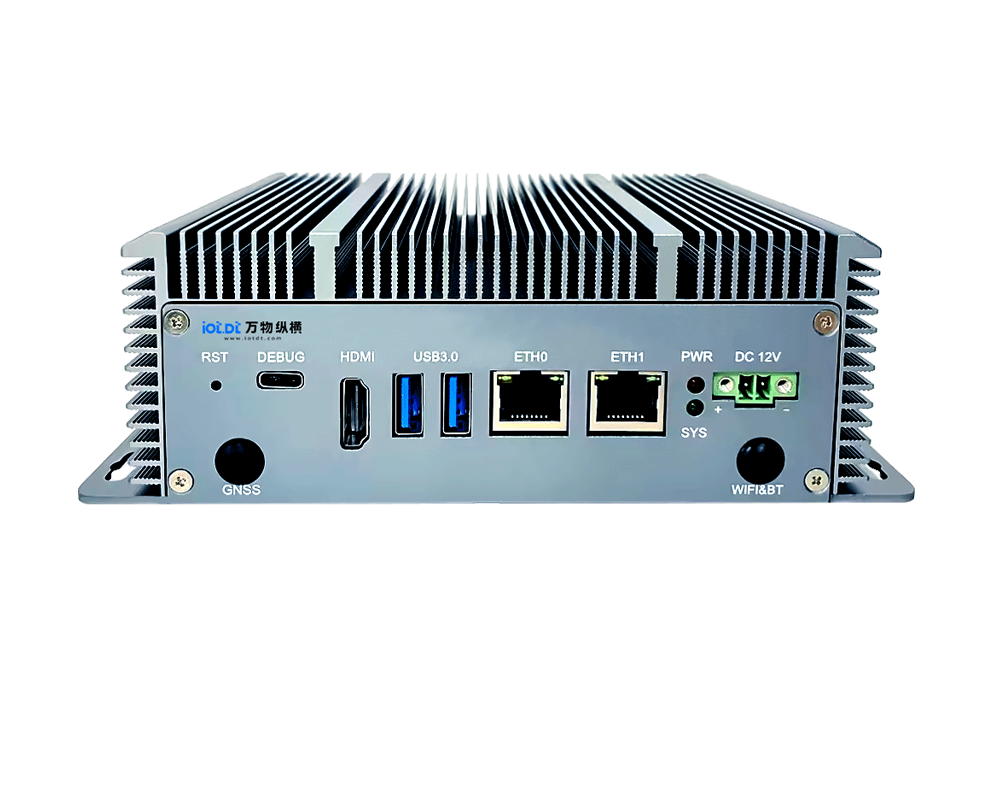
在边缘AI盒子、工控一体机等场景中,最常见的组合是:通用算力(CPU / 主控SoC)+ AI专用算力(NPU / AI协处理器,如 RK1828、BM1684X、LQ50)。
算力类型 | 承担角色 | 典型任务 |
通用算力(主控) | 跑操作系统与业务调度 | 操作系统、网络、外设接口、业务逻辑、数据预处理、任务调度、协议转换 |
AI专用算力(协处理器) | 专门承接AI并行计算 | AI推理、图像识别、多模态大模型运算、并行矩阵计算,释放高TOPS算力 |
核心价值
1. 任务隔离:业务通信和AI推理分开跑,不会因AI负载过高导致系统卡顿、丢帧。
2. 性能 + 功耗平衡:主控负责业务,AI芯片专注推理,边缘场景低功耗、低延迟。
3. 算力可扩展:AI协处理器可模块化选配,升级算力不用更换整个主控板。
4. 国产化 / 信创场景:CPU + 国产NPU双芯,实现自主可控算力底座。
通俗理解:一个管"系统和业务",一个管"AI计算",软硬调度把两者拼成一套完整算力基础设施,就是双算力底座。
二、什么是自研AI算法库
自研AI算法库是厂商自主开发、针对自家硬件底座深度优化的一套封装好的算子、模型组件、工具函数集合。它不是直接用 PyTorch / TensorFlow 原生库,而是底层自研优化包。
库内通常包含四层
底层算子库:卷积、池化、Attention、矩阵乘、量化算子等神经网络基础计算内核,针对自家NPU芯片指令集做手工调优。
领域算法组件:目标检测、图像分割、人脸识别、行为分析、视频结构化等行业预制算法模块。
模型工具链:模型转换、量化压缩、推理调度、前后处理工具、API接口。
适配层:对接双算力底座,实现数据在CPU与AI协处理器之间高效流转。
与开源框架的区别
对比维度 | 自研AI算法库 | 开源框架(PyTorch / ONNX Runtime 等) |
优化方向 | 为自家硬件量身打磨,算子延迟更低、内存占用更小、吞吐更高 | 通用性强,未针对特定国产NPU做极致优化 |
交付与管控 | 可做模型加密、权限管控,适合项目私有化交付 | 开放通用,缺乏私有化管控能力 |
场景适配 | 可针对明厨亮灶、智慧工地、低空安防等场景做专用算法优化 | 需业务方自行二次开发与调优 |
核心价值
1. 软硬深度耦合:充分压榨双算力底座的硬件性能。
2. 业务快速落地:上层应用直接调用封装好的算法API,不用从零写神经网络。
3. 自主可控:底层算子、推理链路自研,不依赖海外闭源算子库。
4. 可定制化:面向特定行业场景做专用算法优化。
通俗理解:一套自己写好、专门适配自家算力硬件的AI工具箱,底层计算内核、行业算法都打包好,上层业务直接调用。
三、极简总结
概念 | 一句话释义(适合写方案 / 宣传) |
双算力底座 | 异构硬件底座:主控通用算力 + AI加速算力,分工协同,提供稳定的底层硬件算力平台。 |
自研AI算法库 | 配套软件引擎:基于自研算子与行业算法,深度适配双算力底座,把硬件算力转化为可调用的AI能力。 |
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部