


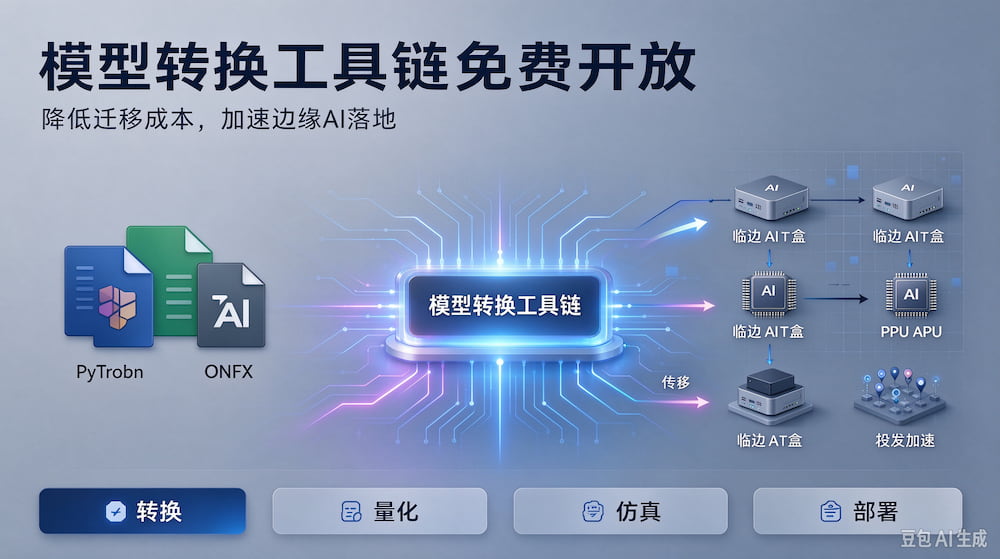
边缘AI盒子硬件同质化加剧,TOPS算力、接口规格越来越接近,软件工具链、模型迁移成本成为争夺开发者与项目订单的核心战场。过去不少芯片/盒子厂商的模型转换、量化编译工具仅限付费客户或签约项目使用;现在国产边缘芯片厂商(瑞芯微、算能、平头哥等)纷纷把核心模型转换工具链免费开放、开放源码/开放CLI、配套模型库,降低客户从PyTorch/ONNX迁移到NPU硬件的门槛。
一、内卷的底层原因
1. 硬件红海,拼软件生态成必选项
RK3588、BM1684X、LQ50、CV系列等边缘算力硬件参数趋同,单纯比拼算力、价格很难拉开差距。工具链好不好用、模型转译成功率、算子支持度,直接决定项目落地周期。安防、明厨亮灶、智慧工地、低空感知这类项目方,选型时优先评估模型迁移成本。
2. 降低开发者迁移成本,抢占存量模型
客户手里大量基于PyTorch、ONNX训练好的CV、VLM、小LLM模型。过去痛点:算子缺失、量化掉精度、转换报错,需要厂商技术支持人工调参,周期长、人力成本高。免费开放完整转换工具链+模型样例,客户可以自助完成模型转换、仿真、性能评估,大幅降低POC成本,更容易把模型跑在自家边缘盒子上。
3. 对抗生态碎片化,争夺行业方案商
集成商、算法公司不会绑定单一硬件。厂商把转换工具免费放出,甚至提供Docker一键环境、在线转换平台、预编译模型仓库,吸引算法厂商基于这套工具开发标准化方案,形成方案生态反哺硬件出货。
二、当前工具链开放的几种模式
1. 免费全功能SDK(最主流)
瑞芯微RKNN-Toolkit2、算能TPU-MLIR等,PC端模型转换、量化、仿真、性能分析工具免费下载使用,支持PyTorch/ONNX/TensorFlow导入,输出硬件专属推理模型;商业部署不收取工具授权费,只卖硬件盒子。
特点:工具本体免费,内核编译器部分闭源,提供完整文档、示例模型、社区支持。
2. 开源编译器路线
nncase、OpenNPU这类,编译器源码开源,允许二次开发、自定义算子。适合深度自研的算法团队,风险是上手门槛更高,厂商技术支持有限。
3. 云端在线转换平台
网页端上传模型,在线完成转换+量化+精度对比,不用本地搭建庞大依赖环境,快速验证可行性,多用于快速POC。
4. 配套免费模型Zoo
同步开放经过调优的检测、分割、VLM、小LLM模型包,附带benchmark时延/内存数据,开箱直接跑在边缘盒子,进一步降低上手门槛。
三、内卷带来的利好
算法/集成商:模型试错成本大幅下降,同一套模型可以快速在多家边缘盒子做横向对比,不用再为工具付费;自助量化、算子调试,减少对原厂FAE依赖。
终端项目:边缘AI项目落地周期缩短,原型验证更快,推动AI视觉、本地多模态在工业、安防快速普及。
国产边缘生态:降低国产NPU生态壁垒,减少对闭源第三方转换工具依赖。
四、隐藏的博弈点(不是完全无代价)
1. 工具免费,服务收费
基础转换工具免费;复杂算子适配、大模型深度调优、项目现场技术支持,依然收取技术服务费。
2. 算子支持差异
虽然工具开放,但各家NPU算子集不一样,复杂模型、新架构VLM依然会出现转换失败、精度损失,工具只是降低门槛,无法消除硬件架构差异。
3. 锁定硬件生态
转换后生成的模型文件(RKNN、bmodel等)是硬件私有格式,只能在对应厂商NPU上运行。客户一旦完成大量模型适配,迁移到别家硬件的成本反而抬高。
4. 版本迭代不稳定
工具链快速迭代,新版本可能出现算子回归,项目落地时要锁定稳定版本。
五、后续趋势预判
1. 模型转换工具从"单纯编译转换"向一站式端到端平台演进:模型导入、自动量化、精度校验、性能压测、容器打包、部署发布一体化。
2. 跨芯片统一中间表示(IR)工具会兴起,解决多硬件适配问题,削弱单一厂商工具链绑定效应。
3. 竞争焦点从"能不能转模型"升级为VLM、小LLM在边缘端的自动适配、KV Cache优化、动态推理,这也是当下边缘盒子竞争新高地。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部