
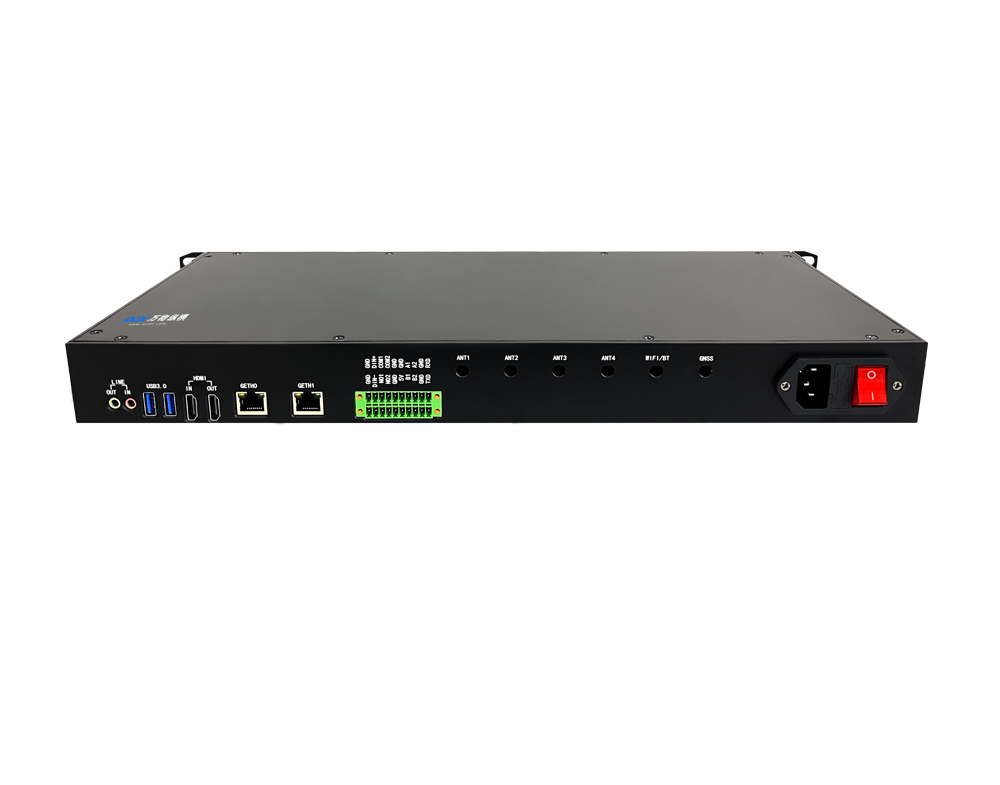
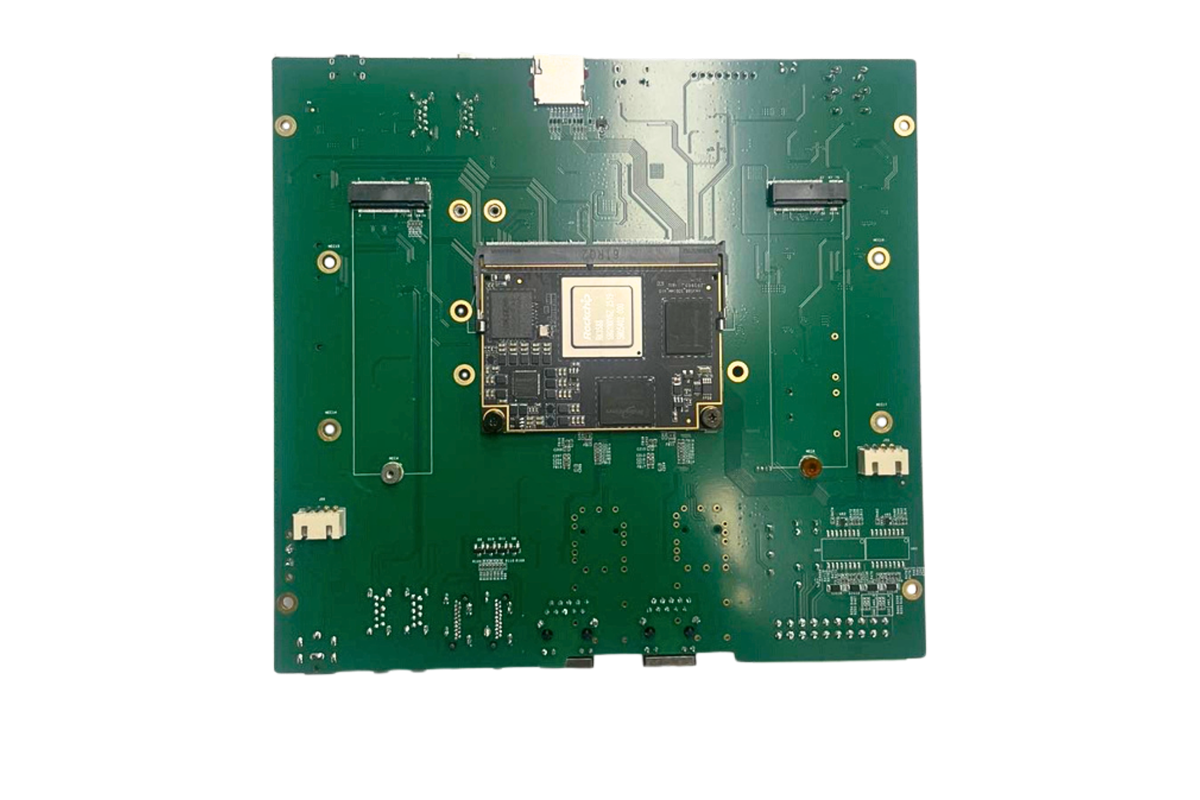
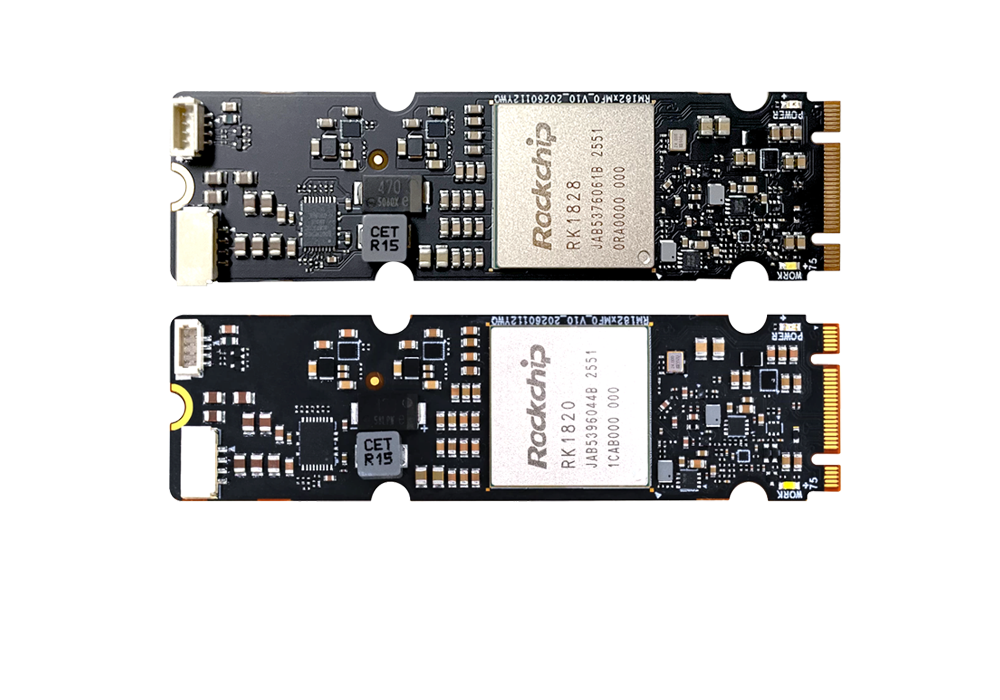


算能升级面向 BM1684X 的 TPU-MLIR 模型编译优化工具链,重点补齐大语言模型、多模态视觉语言模型的编译与自动优化能力,降低在 BM1684X 边缘算力盒子上部署多模态算法的工程门槛,让本地私有化大模型 + 视频分析方案落地更快。
一、核心更新亮点
1. 多模态模型编译能力增强
新版 TPU-MLIR 原生支持 Qwen 系列、MiniCPM-V 等主流 VLM 多模态模型,自动拆分视觉编码器、投影层、LLM Decoder,自动完成算子适配、层融合(Layer-Group)优化;前后处理算子可直接融合进 bmodel,减少 CPU 与 TPU 之间的数据搬运开销,解决多模态模型显存碎片化问题。
2. 一键量化与精度调优
升级自动校准量化工具,支持 BF16/INT8 混合精度编译。对大模型做分层量化,对敏感层保留更高精度,在控制精度损失前提下压缩模型体积,适配 BM1684X 最大 16GB 共享内存,让 7B 级多模态模型可在边缘盒子本地跑通。
3. 简化模型转换链路
原生兼容 PyTorch、ONNX,省去复杂中间转换步骤;支持动态 shape 处理优化,内置大量大模型、多模态模型预定义算子库,减少自定义算子开发工作量,模型转换失败率显著下降。
4. 配套 SDK 与推理封装升级
搭配 AIGC-SDK,提供标准化推理 API,一行脚本即可拉起多模态应用;同时复用 BM1684X 硬件 32 路 1080P 硬解码能力,实现视频流实时采集 + 图像理解 + 大模型文本问答一体化边缘推理,适配明厨亮灶、智慧工地、光伏巡检等场景。
二、硬件底座:BM1684X
INT8 算力:32 TOPS,FP16/BF16:16 TFLOPS;8 核 A53@2.3GHz,最大 16GB LPDDR4X 内存
多媒体:32 路 1080P 硬解码、12 路编码,支持 8K 解码,非常适合视频 + 多模态联合分析
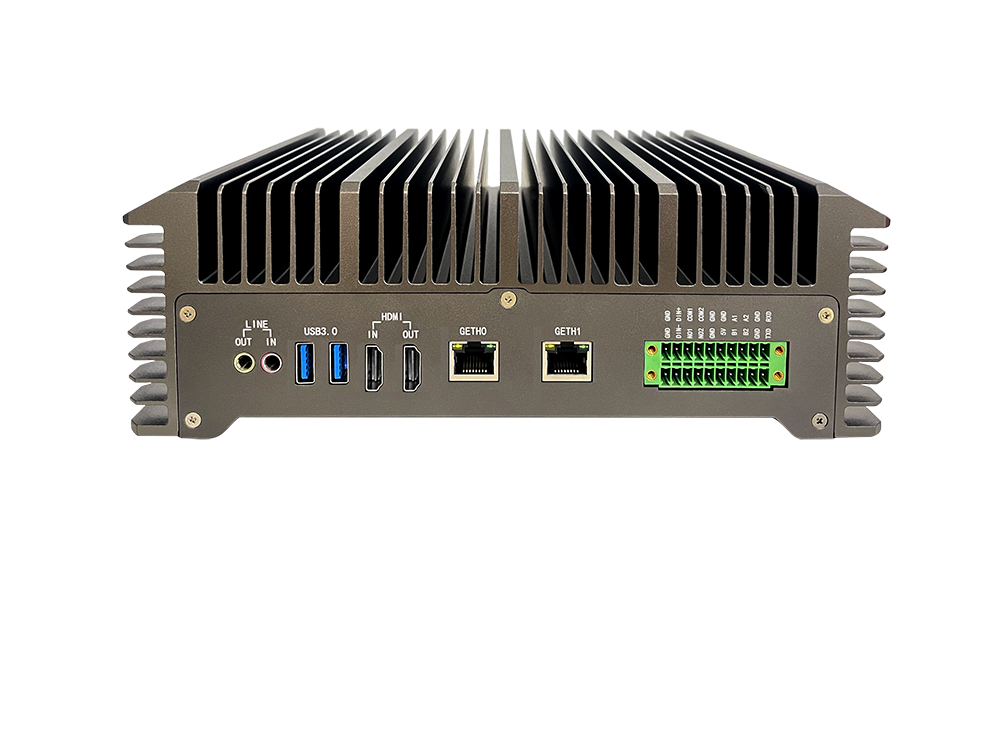
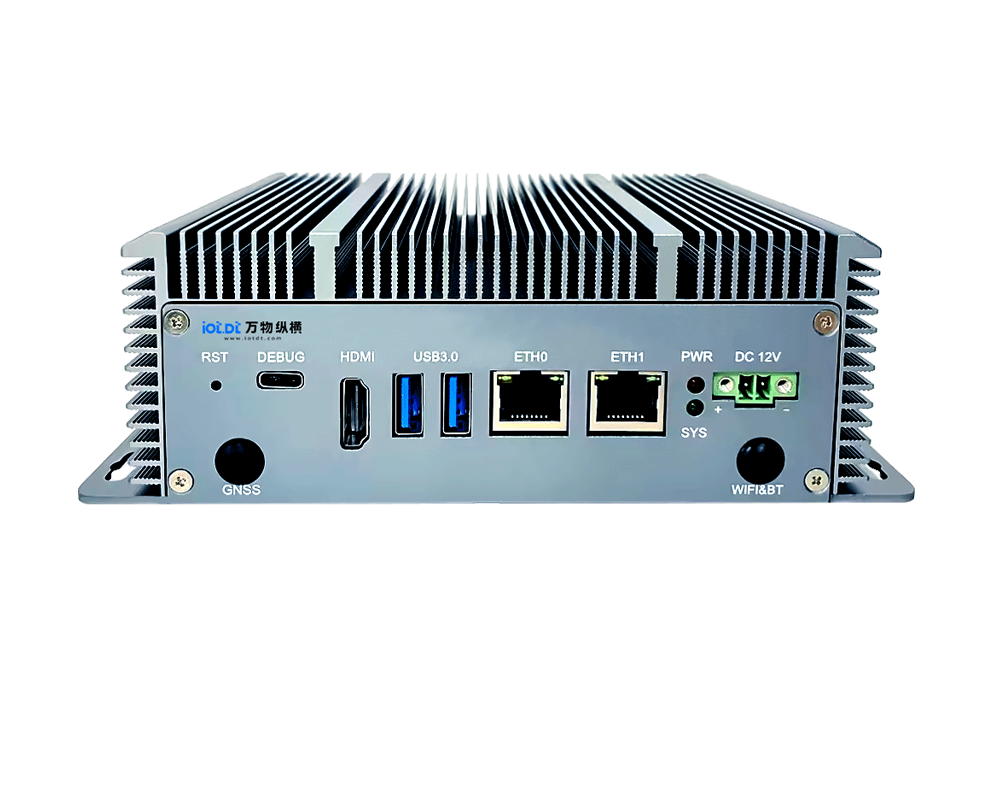
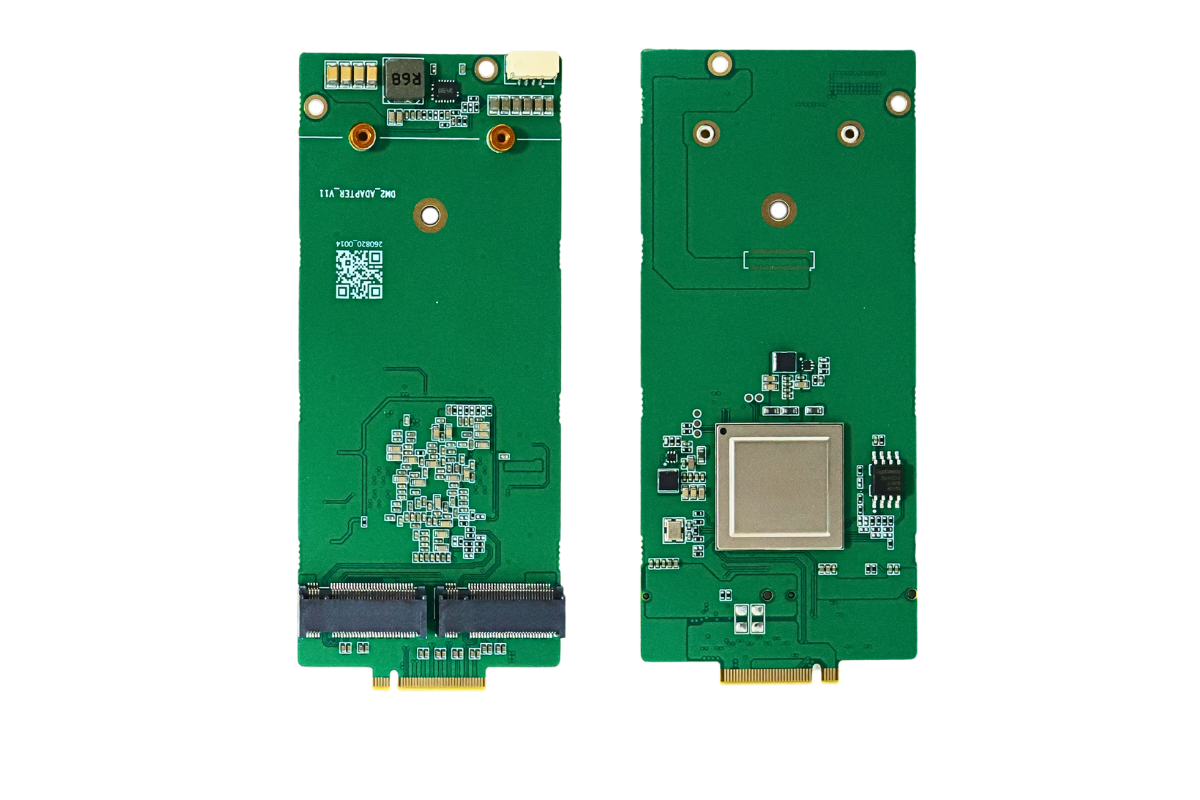
产品形态:可封装为边缘 AI 盒子、模组、PCIe 算力卡,本地私有化部署,无需上云
三、业务价值
算法工程师:减少算子适配、模型分片、显存调优的工作量,从几周部署缩短到几天;
集成商:在边缘盒子上同时跑多路视频分析 + 多模态大模型,低延迟、数据不出本地;
行业场景:智慧工地安全帽识别 + 图文问答、光伏巡检图像描述、园区安防视频理解、工业质检图文分析。
四、现存限制
BM1684X 共享内存有限,超大参数量多模态模型需要做模型分片;Transformer 解码器动态序列长度支持仍有约束,编译时需合理规划静态 shape;INT8 量化会带来小幅精度衰减,对高精度场景需要做针对性校准。
五、总结
本次 TPU-MLIR 工具更新,核心就是把过去复杂的多模态大模型分片、算子适配、显存调优工作交给编译器自动完成,让搭载 BM1684X 的边缘盒子,低成本落地视频视觉 + 大模型问答的一体化本地 AI 方案。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部