
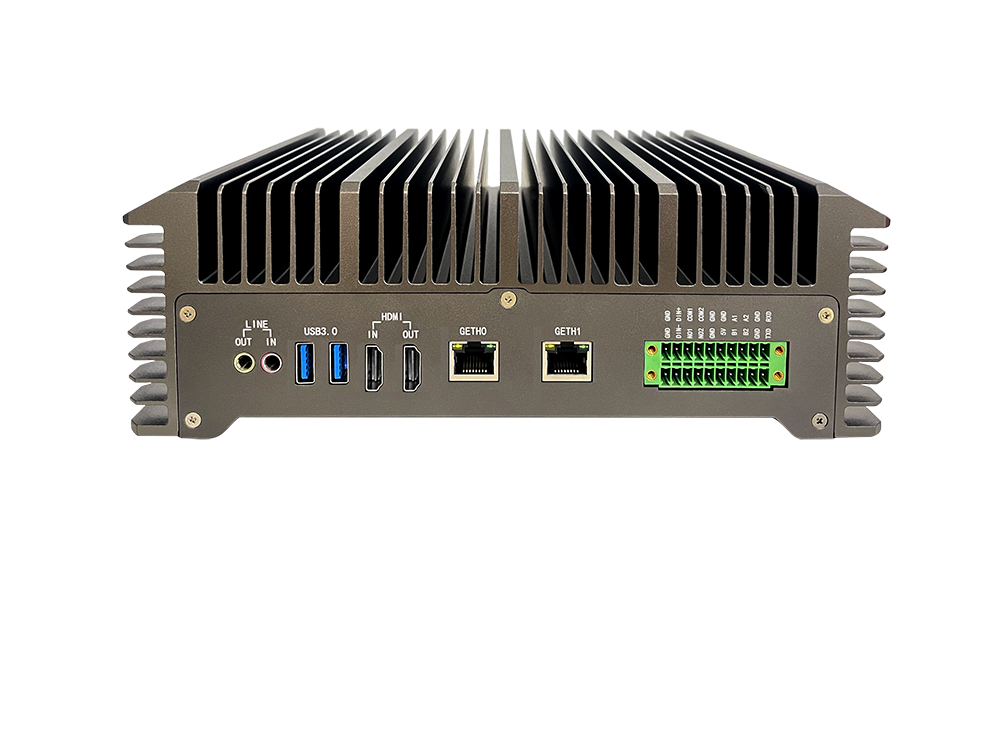
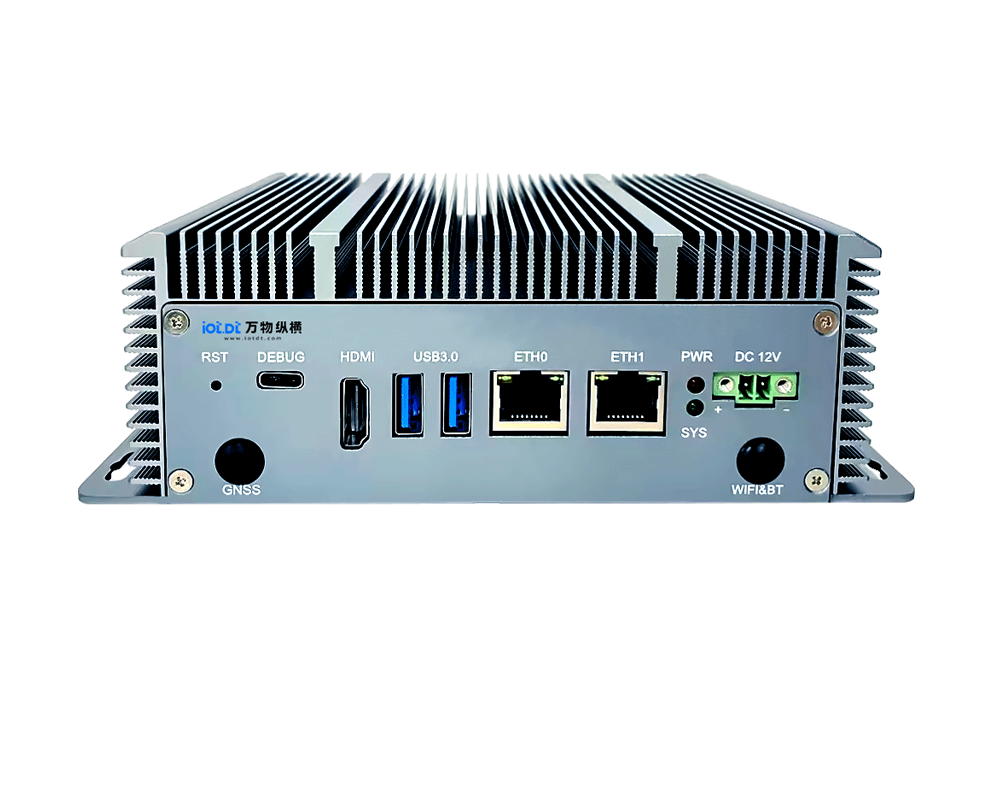
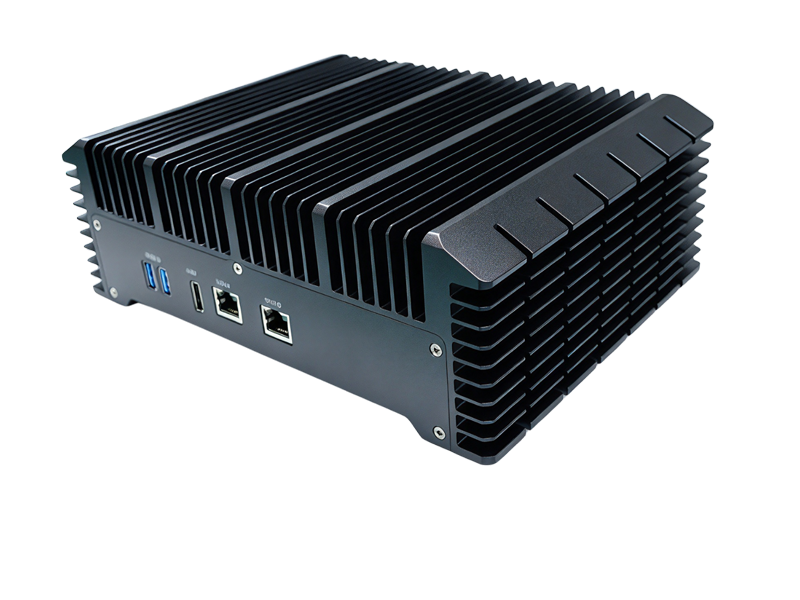
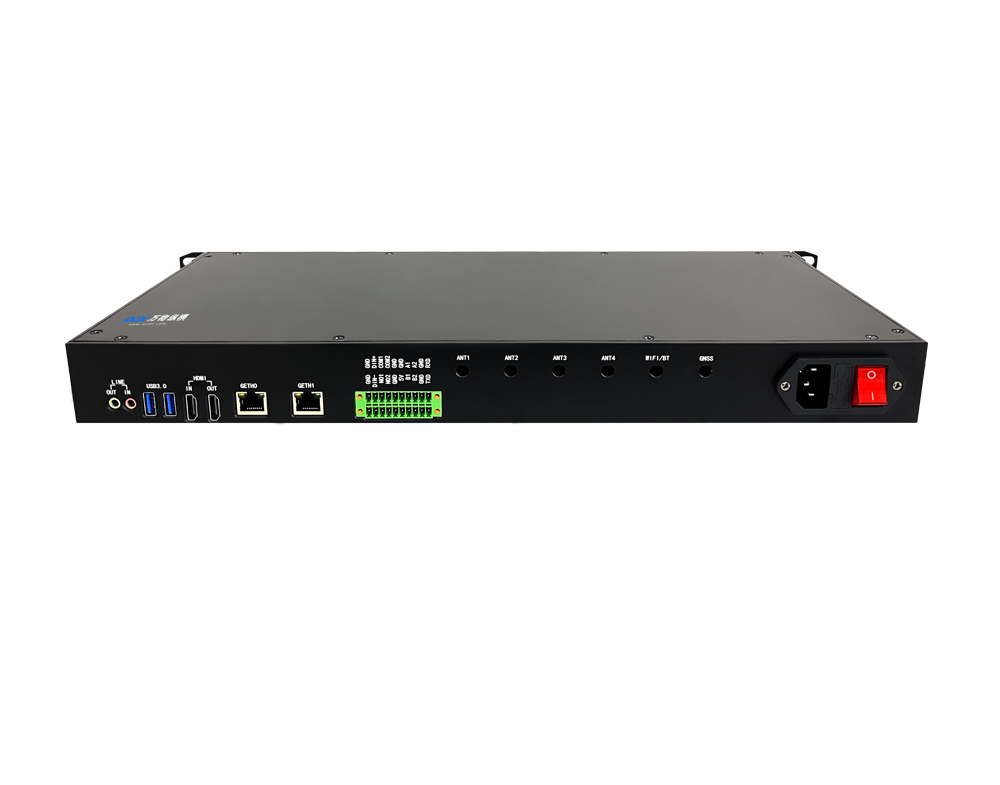


Ollama 上游官方主干目前还没有合入国产 NPU 原生后端;现在市面"适配 Ollama NPU 加速"分两类路线——兼容 API 代理层(rkllama 等)、Ollama 分支原生后端(昇腾、RK、算能社区版)。瑞芯微 RK3588 / RK3576 / RK1828、算能 BM1684X / BM1688、后摩 M50、昇腾是主力国产边缘盒子芯片载体。
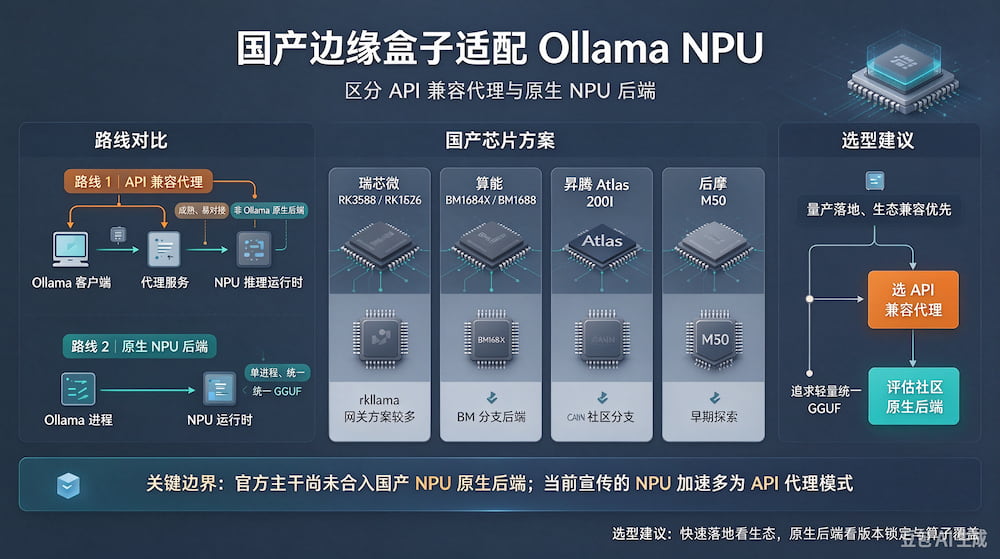
两条主流适配路线
路线一:API 兼容网关(量产盒子最常用,非 Ollama 原生后端)
代表方案:rkllama(RKLLM Runtime 封装)
底层:RKLLM SDK 跑 rkllm 模型,单独起一个兼容 11434 端口的代理服务,实现 /api/chat、/api/generate 标准 Ollama 接口
优势:原版 Ollama 客户端、Open WebUI、各类 Agent 直接对接,不用替换 ollama 二进制;RK3588、RK3576、RK1828 算力卡盒子大量采用该方案,是现在商业化 AI 盒子主流方案
短板:不是 Ollama 内部原生 backend,模型格式不是标准 GGUF,需要先用 RKNN3 工具转 rkllm 格式,没法直接 ollama pull qwen2.5 开箱跑 NPU
路线二:Ollama 原生 NPU 后端(社区分支,真正内置 backend)
在 ollama 源码内新增硬件 backend,ollama 进程内部直接调用国产 NPU SDK,原生接管推理,不用额外代理:
1. 昇腾 Ascend:社区分支,对接 CANN,容器部署,需要对应驱动版本,偏向服务器 / 工业边缘盒,成熟度相对高一些
2. 瑞芯微 RK(RKNPU / RKLLM):社区 fork 版本,新增 rkllm backend,目标支持 GGUF 直接转调 RK NPU,还在迭代
3. 算能 BM(TPU):BM1684X / BM1688 的 ollama 分支后端,基于 bmtpu runtime,多用于自研算法盒子
4. 后摩 M50、力擎 LQ50:以 llama.cpp 后端 / 独立推理服务为主,Ollama 原生后端还处于早期实验阶段
关键边界:上游官方 Ollama 主干只原生支持 CPU、Vulkan、Metal(MLX)、CUDA,国产 NPU 后端全部在社区分支,尚未进入官方主线,稳定性、算子覆盖参差不齐,不适合直接标准化量产。
硬件代表盒子
方案厂商 | 代表硬件 | 典型应用 |
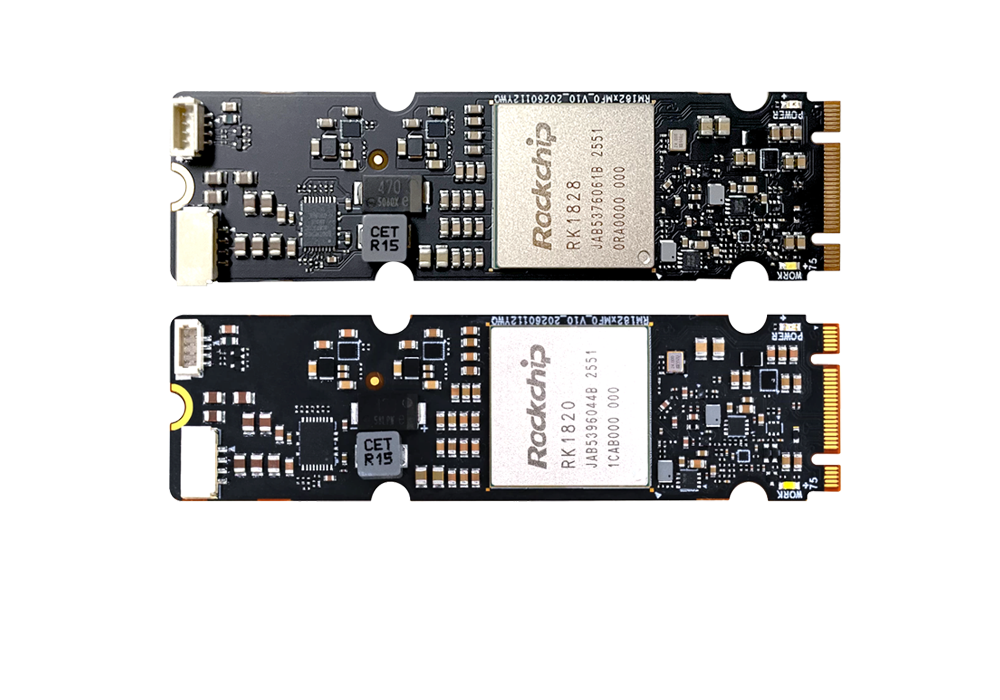
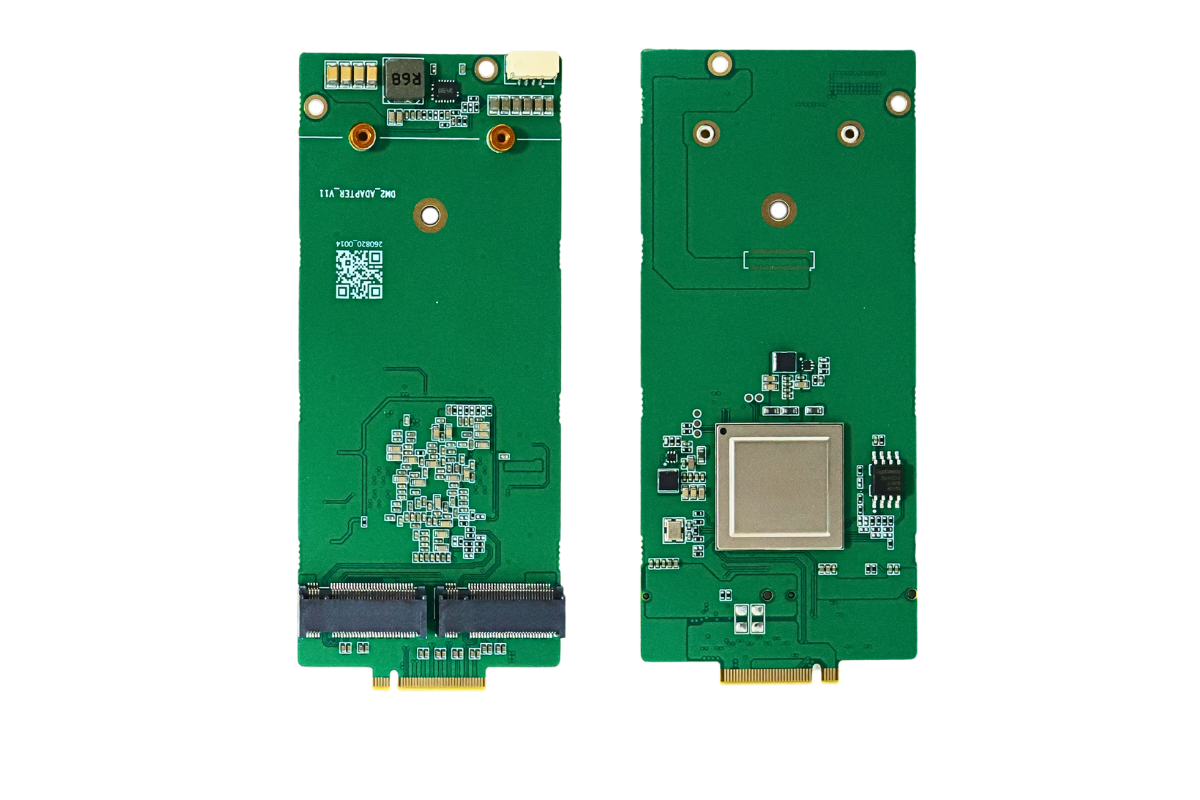
瑞芯微 | RK3588 盒子、RK3576 主机 + RK1828 M.2 算力卡(20TOPS,支持 7B VLM) | rkllama 方案已经很多厂商预装交付 |
算能 | BM1684X / BM1688 边缘盒子 | 安防、明厨亮灶、工地 AI,配套自研 ollama 分支后端 |
昇腾 | Atlas 200I 系列边缘盒 | 社区 ollama-ascend 分支 |
后摩 | M50 协算力卡 | 目前更多是 llama.cpp + bmtpu / rknn,Ollama 原生后端还在跟进 |
对项目选型的影响
✅ 快速落地、对接现有 Ollama 生态(OpenWebUI、Agent、业务系统):优先选 rkllama 这类 API 网关方案,成熟、文档多、量产验证多
✅ 追求轻量化单进程、统一 GGUF、不想多一层代理:选社区原生 NPU 后端分支,接受版本锁定、升级麻烦、部分算子缺失风险
❌ 不要误解:"支持 Ollama" ≠ "Ollama 原生 NPU 后端",很多销售宣传的 NPU 加速,都是 API 代理模式
近期趋势
随着 RKNN3、BMSDK 迭代,越来越多国产边缘盒子厂商开始同步维护 ollama 分支原生后端,目标是消除中间代理层开销、统一 GGUF 模型流转;短期看,API 兼容网关依然是商业化主力,原生后端属于技术演进方向。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部