
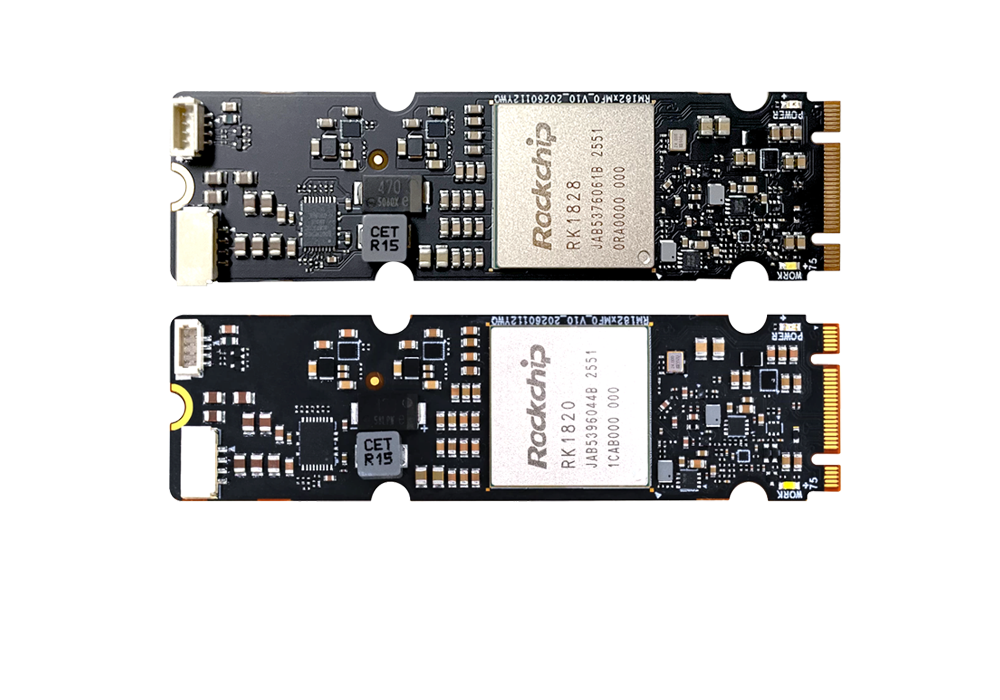
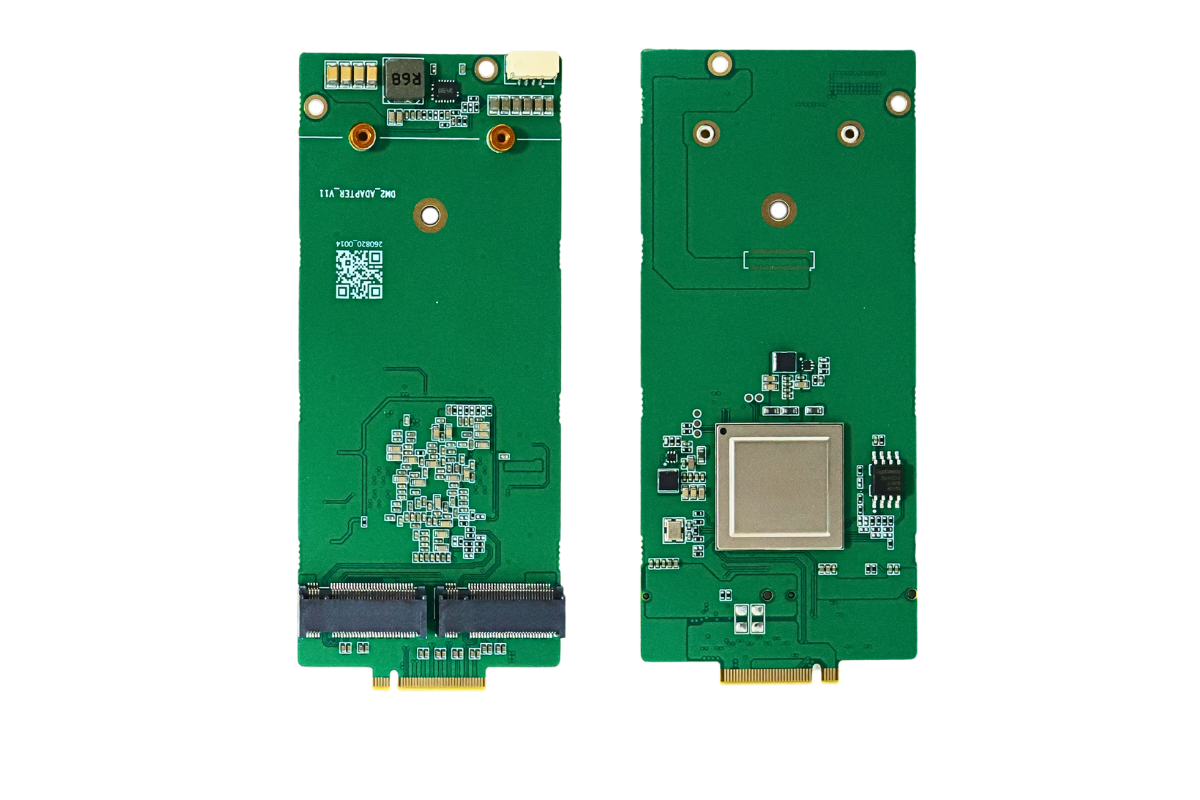


背景:LQ50 Duo 为双芯异构 NPU(两颗 LQ50),M.2 2280 形态,典型场景包括多 Agent 本地推理、多视觉 Agent + LLM Agent 混跑、多任务并发。核心痛点集中在双芯资源隔离、抢占时机、显存/片上存储争抢、调度开销、Agent 任务特征适配,与通用 GPU、RK/BM 系列 NPU 调度差异较大。
1. 硬件基础约束(调度的根源)
1.1 硬件架构
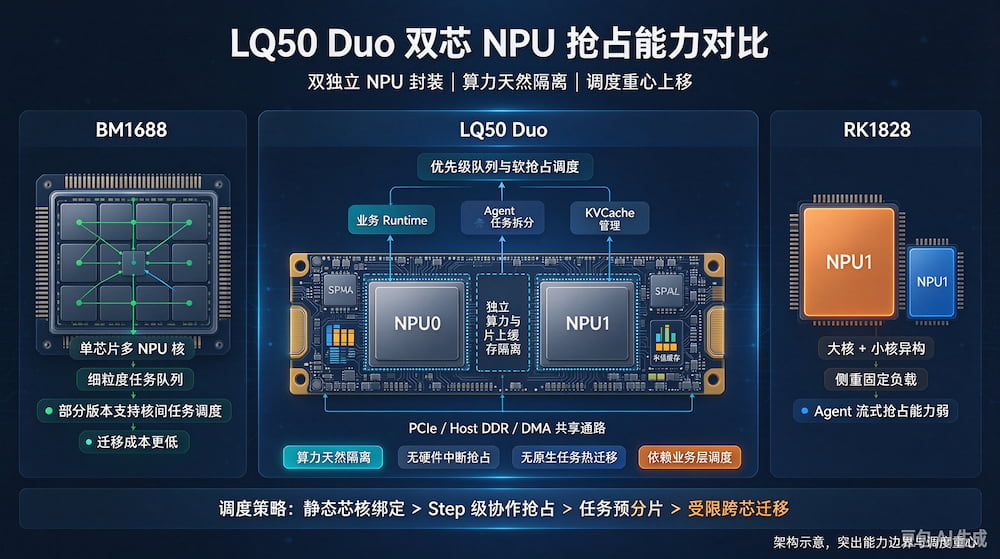
独立双 NPU 核心,各自自带片上 SRAM、权重缓存、推理流水线;共享主机侧 PCIe 带宽、主机内存、DMA 通路。不是单芯多核,而是两颗独立 NPU 芯片封装在同一张卡。
1.2 算力与存储隔离边界
芯片内部算力、片上缓存:天然隔离,一个 NPU 跑的任务不会直接挤占另一颗 NPU 的片上资源。
竞争资源:PCIe 传输、主机 DDR、驱动队列、固件任务提交通道、IO、模型加载/换模耗时。
1.3 Agent 任务特征(与普通单轮推理的最大区别)
不是固定长度 batch 推理:多阶段、间歇性、长驻留、有依赖链(LLM 生成 → 工具调用 → 视觉识别 → 再次生成)。
任务优先级差异明显:交互 Agent(人机对话、实时告警)低延迟优先;后台批量 Agent(文档解析、批量识图)吞吐优先。
任务时长不可预测:取决于 token 生成数量、工具返回结果,极易出现"长任务占死 NPU,高优先级小 Agent 饥饿"。
关键结论:LQ50 Duo 的抢占调度分为两层——NPU 内核间调度(芯片固件层)+ 上层 Agent 业务调度(框架/Agent runtime 层);固件本身一般只支持任务排队、时间片,原生不支持细粒度生成阶段抢占。
2. 多路 Agent 下典型抢占问题现象
2.1 现象 1:高优先级 Agent 被长生成任务阻塞(最常见)
场景:NPU0 跑一个长文本 Agent(持续几百 token 生成,占用 NPU 流水线),此时来了一个实时视觉 Agent(需要 100ms 内返回结果)。
问题:LQ50 NPU 推理任务一旦启动正向生成流程,固件不支持中断抢占,必须等当前推理 step/整个推理任务跑完才能释放资源;高优任务排队,时延飙升,Agent 交互卡顿。
区分:如果两个任务分到两颗不同 NPU,则不会算力阻塞,只会抢 PCIe/DMA;如果都提交到同一个 NPU 队列,就会串行排队。
2.2 现象 2:任务抢占切换带来模型换模开销抖动
场景:调度器强行把 NPU 上 LLM Agent 任务踢出,加载视觉模型给高优视觉 Agent;之后再切回 LLM。
问题:LQ50 权重加载、片上缓存刷新开销很高,频繁抢占切换会出现毫秒 ~ 百 ms 级抖动,反而比排队更差;Agent 流式输出会断流、掉帧。
2.3 现象 3:双芯负载不均,调度策略失效
简单均分策略(轮询分发 Agent 任务到 NPU0/NPU1)缺陷:Agent 任务负载差异极大,有的 Agent 是轻量工具调用、短 prompt;有的是长上下文大模型推理。轮询容易出现一颗 NPU 满载卡死、另一颗空闲,抢占机制没法跨芯迁移正在运行的任务(LQ50 Duo 不支持任务热迁移)。
2.4 现象 4:共享资源隐性抢占(容易被忽略)
两颗 NPU 同时工作时,PCIe、主机内存带宽争抢:哪怕算力互相隔离,多路 Agent 同时做模型输入/输出传输、图像预处理、向量检索回传,会出现 IO 拥塞。表现为:两个 NPU 都有空余算力,但 Agent 推理速度一起变慢,看起来像算力抢占。
2.5 现象 5:Agent 依赖链导致调度死锁/优先级反转
示例:Agent A(高优)依赖 Agent B(低优后台任务)的工具结果;调度器把 B 抢占下线,A 等待 B,高优任务被低优依赖卡住,优先级反转。
3. 可行的抢占调度方案分层
前提约束:LQ50 硬件固件不支持推理过程中硬件级中断抢占。所有"抢占"本质是:① 任务分片(在 step 之间主动让出);② 队列优先级调度;③ 双芯静态分区隔离;④ 任务预分配,避免运行中强抢。
方案 | 核心做法 | 优点 | 局限 / 注意 |
A. 静态芯核绑定 + 优先级队列 (工程最稳,推荐优先落地) | 把两颗 LQ50 固定角色划分:NPU0 跑低延迟实时 Agent(交互对话、实时检测、告警),队列优先调度;NPU1 跑吞吐型后台 Agent(批量文档解析、OCR、离线数据)。 | 从根源避免互相抢占,无换模抖动;调度逻辑简单,适合 Agent 混跑。 | 资源利用率上限低,实时 NPU 空闲时后台任务不能借用。适合对时延稳定性要求高于利用率的场景。 |
B. 时间片协作抢占(软抢占,在 token step 边界让出) 【主流 Agent runtime 方案】 | 不在硬件指令中间打断,在 LLM 每个 decode step、视觉推理单帧结束的安全断点让出。维护全局优先级表(交互 > 实时感知 > 后台批量);高优任务就绪时,当前任务保存 KVCache 让出,高优完成后恢复 KVCache 继续跑。 | 单芯内部实现优先级抢占,提升算力利用率。 | 最小抢占粒度 = 1 个 decode step,无法做到亚 ms 级硬中断;step 很长时依然有阻塞。KVCache 放 Host DDR,切换耗时需纳入预算。 |
C. 任务预分片 + 抢占阈值控制 | 长生成任务强制设置最大连续 step 配额;调度器设置饥饿超时,低优先级任务长时间得不到调度时动态提升权重;拒绝无上限的超长 Agent 任务独占 NPU。 | 规避长任务垄断,适合通用本地 Agent 集群。 | 需要精准的 step 配额调参;配额过紧会导致频繁切换抖动。 |
D. 跨芯任务迁移(受限方案,谨慎使用) | LQ50 Duo 不支持运行态无缝迁移。流程:暂停任务 → 导出 KVCache/中间张量 → 卸载当前模型 → 目标 NPU 加载模型 + 恢复 KV。 | 可平衡双芯负载,适合预估剩余时间很长、另一颗 NPU 短期空闲的后台 Agent。 | 开销很大,绝对不能用于实时交互 Agent 的抢占迁移。 |
E. 资源配额调度(QoS) | 给不同 Agent 分组设置算力配额、PCIe 带宽配额、最大并发数。例如交互 Agent 组占总调度时间 60%,后台 40%。 | 适合多租户 Agent 场景,多个业务方共用一张 LQ50 Duo 算力卡。 | 调度器实现复杂度高,需要精确的配额计量与回收机制。 |
4. 与 BM1688 / RK1828 在抢占上的差异
芯片 | 架构特点 | 抢占能力 |
LQ50 Duo | 双独立 NPU 芯片封装,算力天然隔离,但无硬件中断抢占、无原生任务热迁移。 | 调度重心放在业务 runtime、Agent 任务拆分、KVCache 管理,不依赖驱动固件硬抢占。 |
BM1688 | 单芯片多 NPU 核。 | 固件支持更细粒度任务队列,部分版本支持内核间任务调度,迁移成本更低。 |
RK1828 | 大核 + 小核异构。 | 侧重固定负载,Agent 流式抢占能力弱。 |
5. 工程落地避坑清单
1. 不要设计"强制中断正在 decode 的 NPU 任务"逻辑,LQ50 固件不支持,强行销毁任务大概率引发驱动异常、NPU 挂死。
2. KVCache 是抢占调度的核心成本:KV 越大,切换开销越高;长上下文 Agent 尽量固定绑定 NPU,减少抢占切换。
3. Agent 依赖链一定要在调度器上层做依赖感知:高优任务依赖低优任务时,临时提升依赖任务优先级,规避优先级反转。
4. 监控指标重点看:每颗 NPU 的队列长度、step 平均耗时、KV 切换耗时、PCIe 吞吐,而不是只看算力利用率;利用率高不代表 Agent 时延达标。
5. 多路 Agent 混跑优先芯隔离 > 软时间片抢占;只有资源紧张时才开启 step 级协作抢占。
请用手机扫码查看分享内容
 下一篇:国产边缘盒子适配 Ollama 原生 NPU 后端:现状与要点
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)


 试用申请
 产品咨询
 在线客服
 回到顶部