
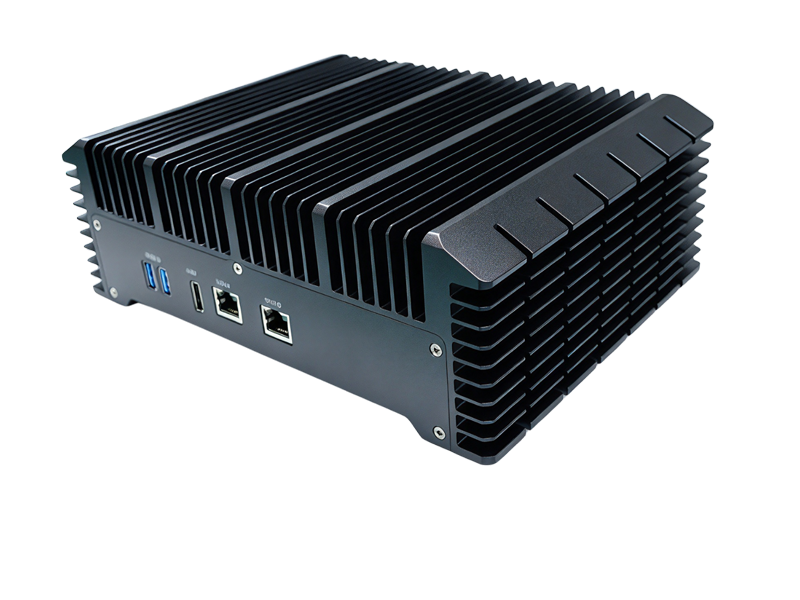
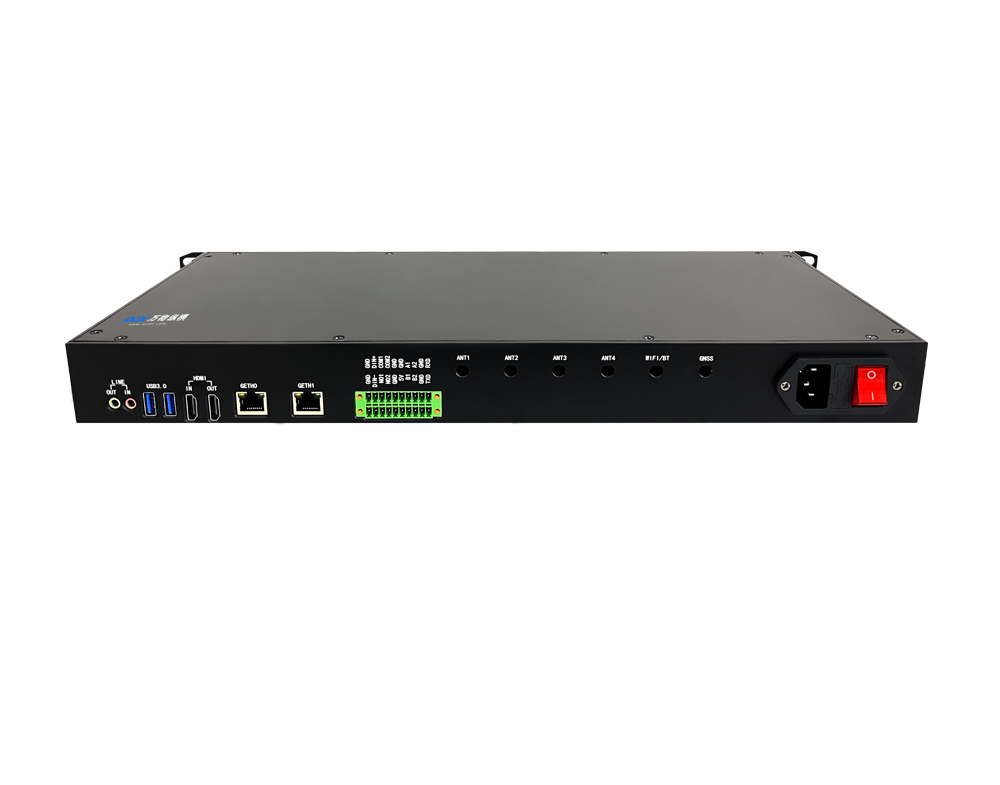
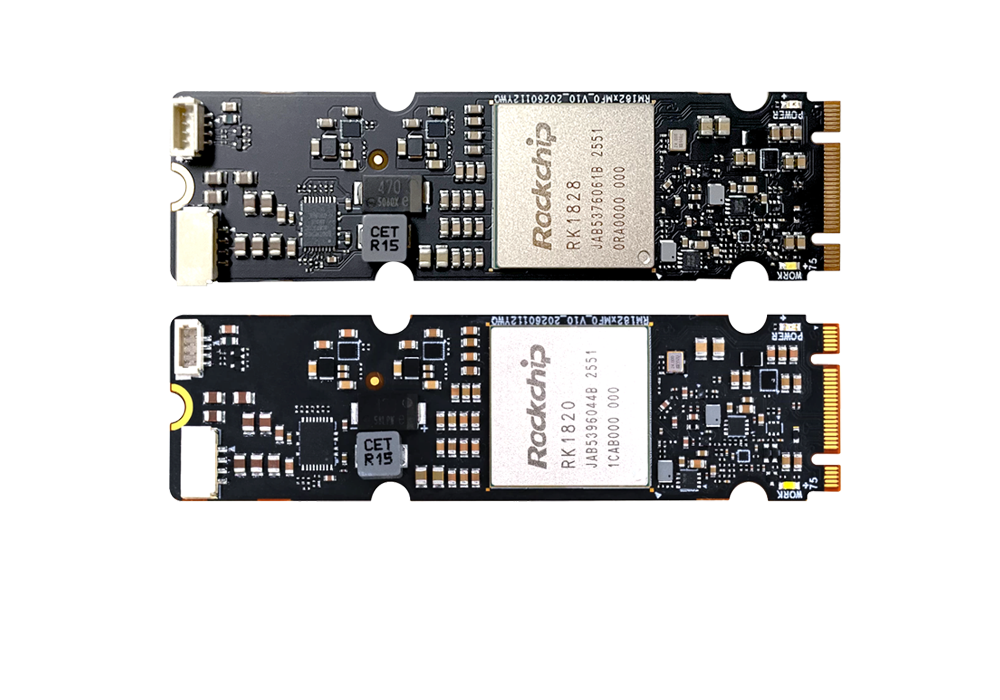
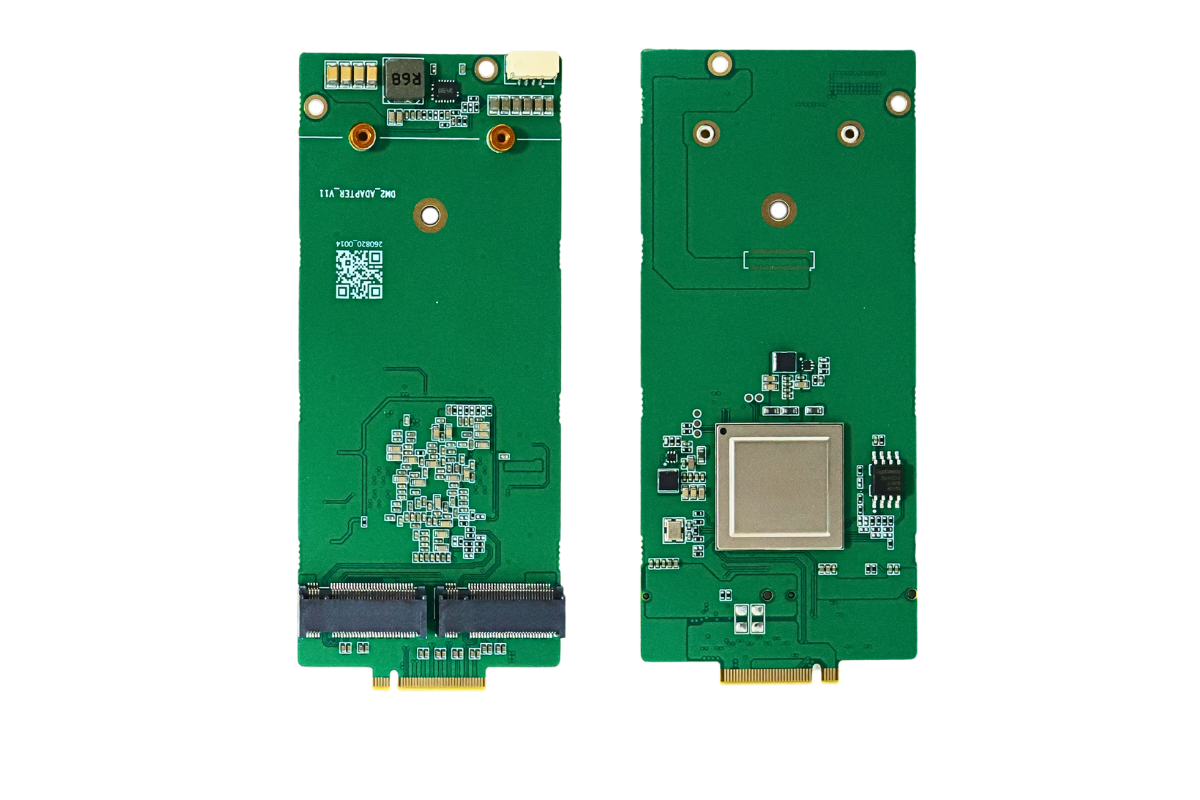


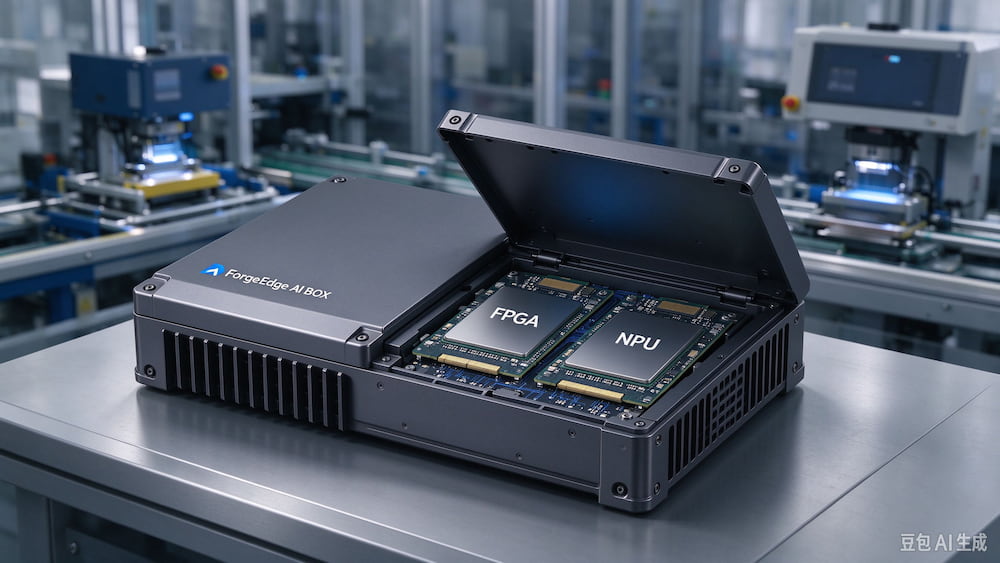
海外一款面向工业场景的模块化边缘AI盒子ForgeEdge AI Box近期流出方案细节,采用FPGA+NPU异构混合架构,主打工业产线实时视觉、传感器融合、运动控制与AI推理一体化,直接对标国内RK、算能、国产自研NPU路线的工业算法盒子赛道,是海外厂商针对工业边缘市场的差异化竞争方案。
一、架构分工:FPGA负责实时,NPU负责推理
异构分工是这套方案的核心思路:
FPGA:承担高速数据流预处理、多路相机/雷达/LiDAR同步采集、视频编解码、协议解析、硬件流水线、实时控制逻辑。优势是硬实时、纳秒级低延迟、可重配置,适配工业产线高节拍、强确定性场景,解决纯NPU方案容易出现的数据流阻塞、时序抖动问题;
NPU模组:专门承接深度学习推理,缺陷检测、目标识别、OCR、时序异常检测等AI模型,做张量加速;
模组之间通过高速PCIe/Serdes互联,内部流水线打通,预处理数据直接送入NPU,减少CPU搬运开销;
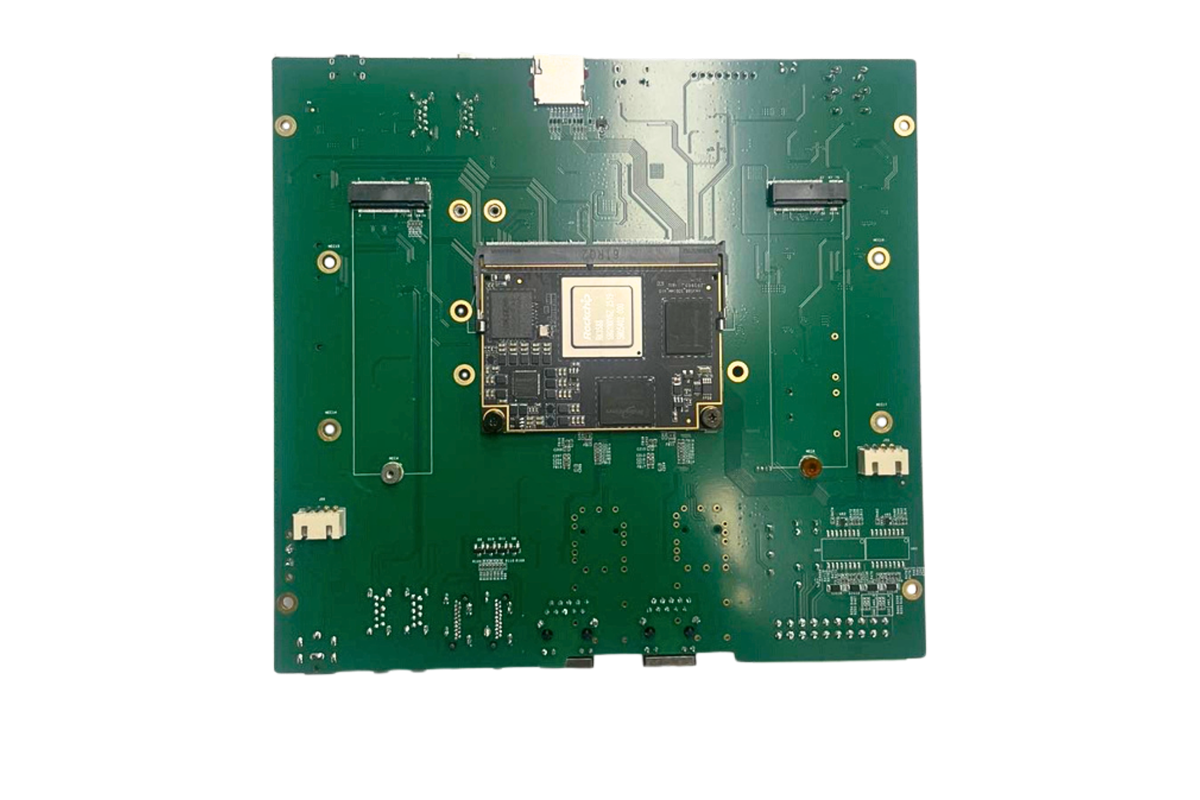
模块化设计:FPGA子卡、NPU算力卡、采集IO卡、存储卡独立插拔,算力规格、接口规格按需选配,不用整机重新改板,支持算力平滑升级。
二、工业规格与定位
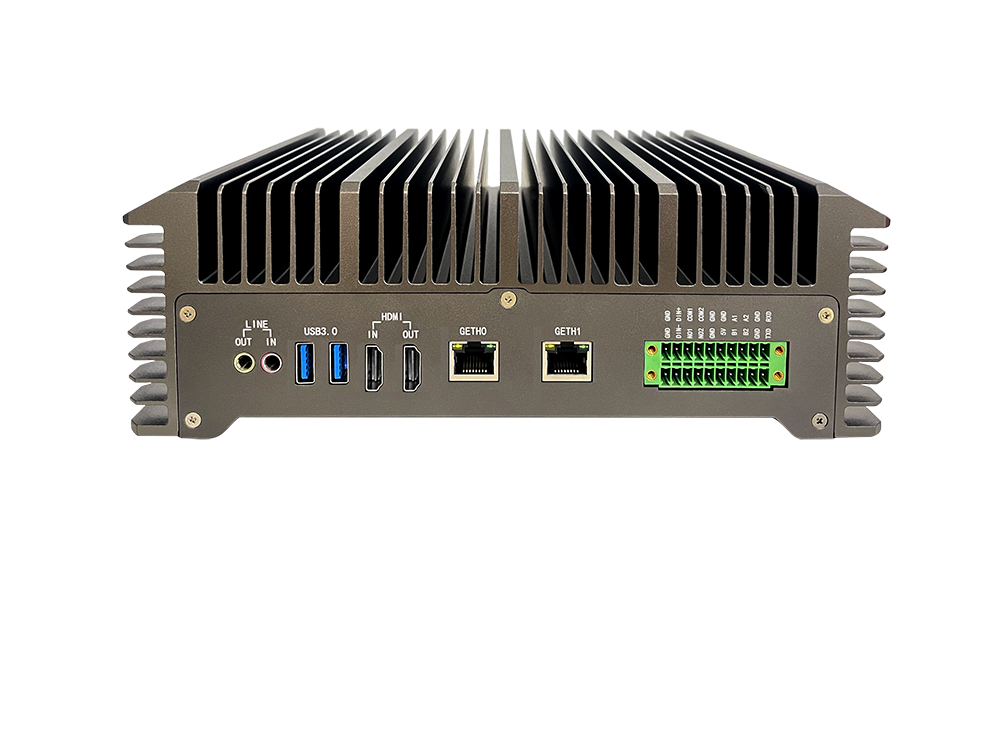
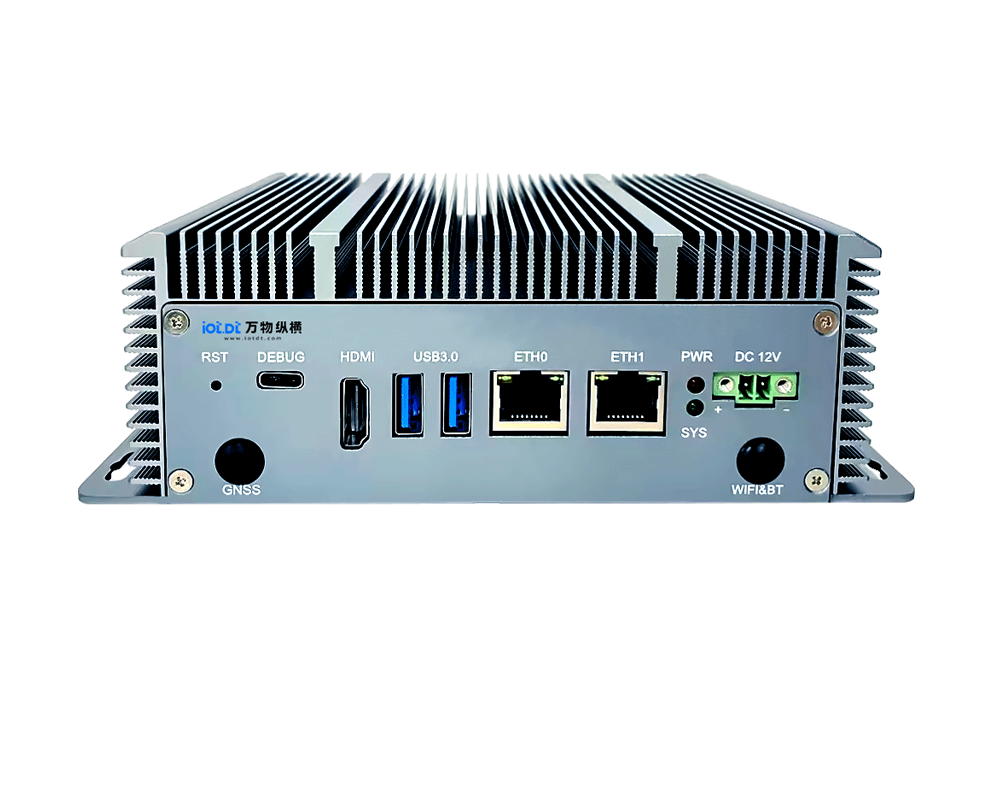
形态:无风扇密闭工业盒,宽温(典型-40℃~+70℃)、抗震动、防尘,满足工厂、冶金、仓储、港口、机器人控制柜严苛环境;
接口:多路GigE Vision、CoaXPress、RS485、CAN、千兆/万兆网口,原生适配工业视觉与自动化总线;
软件栈:配套FPGA开发套件+NPU模型编译工具链,支持PyTorch/TensorFlow模型转换;支持容器化部署、边云对接;
市场定位:海外工业自动化、机器视觉、移动机器人、安防雷达融合场景,对标国内大量出货的工业AI算法盒子(RK3588、BM1684X、国产NPU盒子)。
三、和国内主流算法盒子路线对比
对比项 | ForgeEdge FPGA+NPU方案 | 国内主流NPU单芯片算法盒子(RK/BM等) |
架构 | 异构双芯分离,FPGA硬实时预处理+NPU推理 | SoC集成NPU,CPU+NPU共享片上资源 |
延迟特性 | 时序确定性强,多路高速采集同步能力强 | AI推理算力强,但多路高并发采集容易受CPU调度影响,实时性偏弱 |
灵活性 | FPGA可自定义IP,适合定制化采集、特殊协议、专用信号处理 | 软件部署简单,开箱跑算法,适合标准化视频分析、明厨亮灶、工地安监 |
成本 | 模块化高端方案,BOM成本偏高,偏向项目定制 | 成本优势明显,标准化量产、走量性价比高 |
生态门槛 | 需要FPGA开发能力,开发周期更长 | 工具链成熟,大量现成算法包,集成商上手快 |
四、产业看点
1. 趋势印证:FPGA+NPU混合异构正在成为高端工业边缘的重要路线,核心痛点就是工业场景既要AI识别,又不能丢实时控制与高速采集确定性,纯NPU SoC在高节拍机器视觉、多传感器融合场景存在短板;
2. 竞争方向:海外这套方案主打高可靠、可重构、长生命周期,瞄准高端工业自动化;国内算法盒子优势在低成本、成熟算法生态、本地化适配(国标协议、私有化平台对接);
3. 国内厂商的应对方向:部分国产方案也开始在自研板卡上搭载FPGA协处理子卡,走同样的异构路线,补齐高速采集与硬实时短板,争夺高端机器视觉、工业检测订单。
五、短板
这套方案的最大短板是软件生态重、开发门槛高。国内算法盒子的核心护城河不是算力,而是打包好的上百种工业算法、视频接入、告警平台、国标协议,集成商可以快速交付;而FPGA+NPU方案更多是硬件底座,算法层需要客户/集成商深度二次开发,落地周期更长。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部