
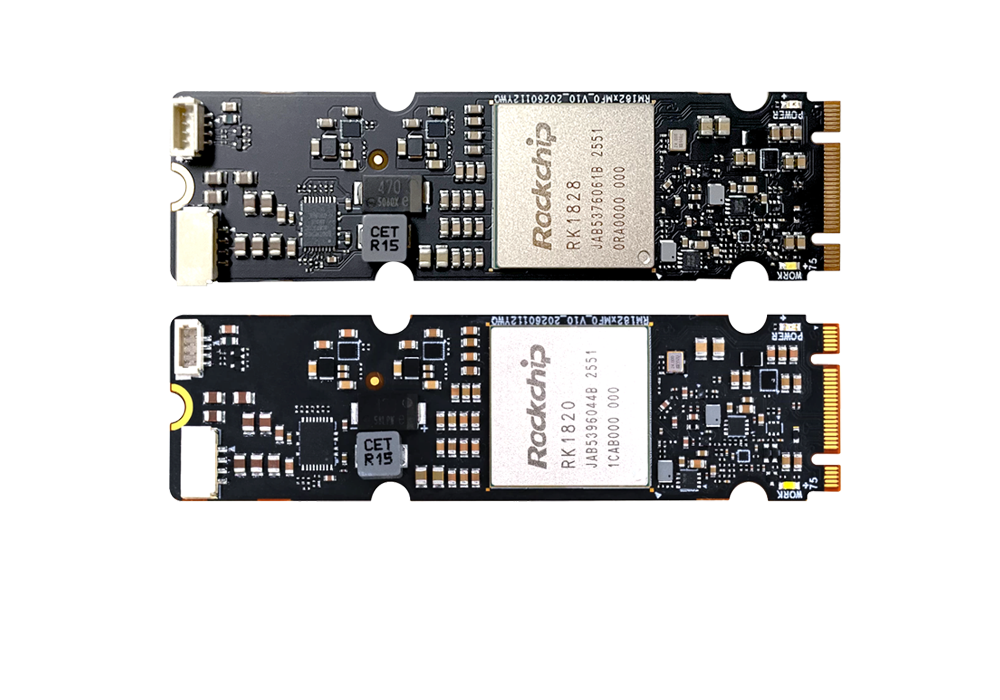


边缘私有化大模型、多模态感知、AI Agent 落地需求持续放量,M.2 形态协算力卡凭借标准化接口、低改造成本、数据本地闭环优势,成为工业、安防、机器人、车载边缘项目采购主流。当前选型阵营明显分化:RK1828 主打均衡性价比、生态成熟;LQ50 DUO 双芯算力卡主打存算一体高带宽、超大本地内存,面向14B~35B级大模型。
RK1828 算力卡(瑞芯微)
规格:M.2 2280 M-Key,INT8 20TOPS,内置5GB 3D堆叠片上DRAM,带宽高;支持INT4/INT8/FP8/FP16/BF16混合精度
适配:RK3588 / RK3576 / RK3568等瑞芯微主控,RKNPU3 SDK深度优化,原生适配Qwen、LLaMA、VLM视觉多模态模型,单卡流畅跑3B–7B模型;双卡并联可支撑9B级推理
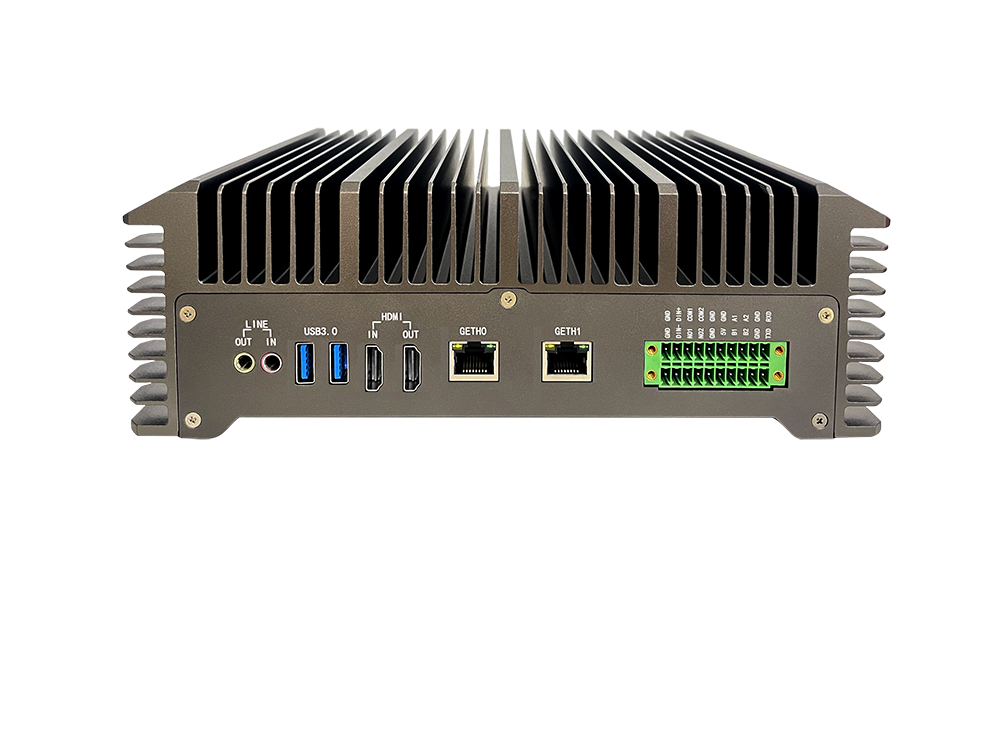
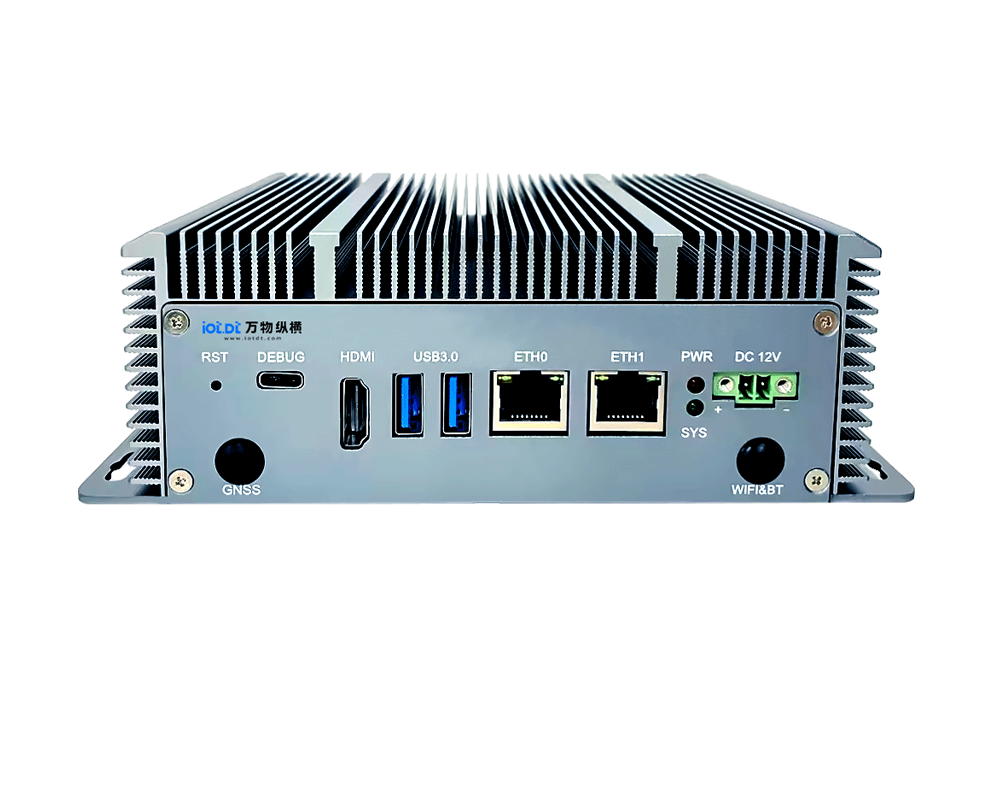
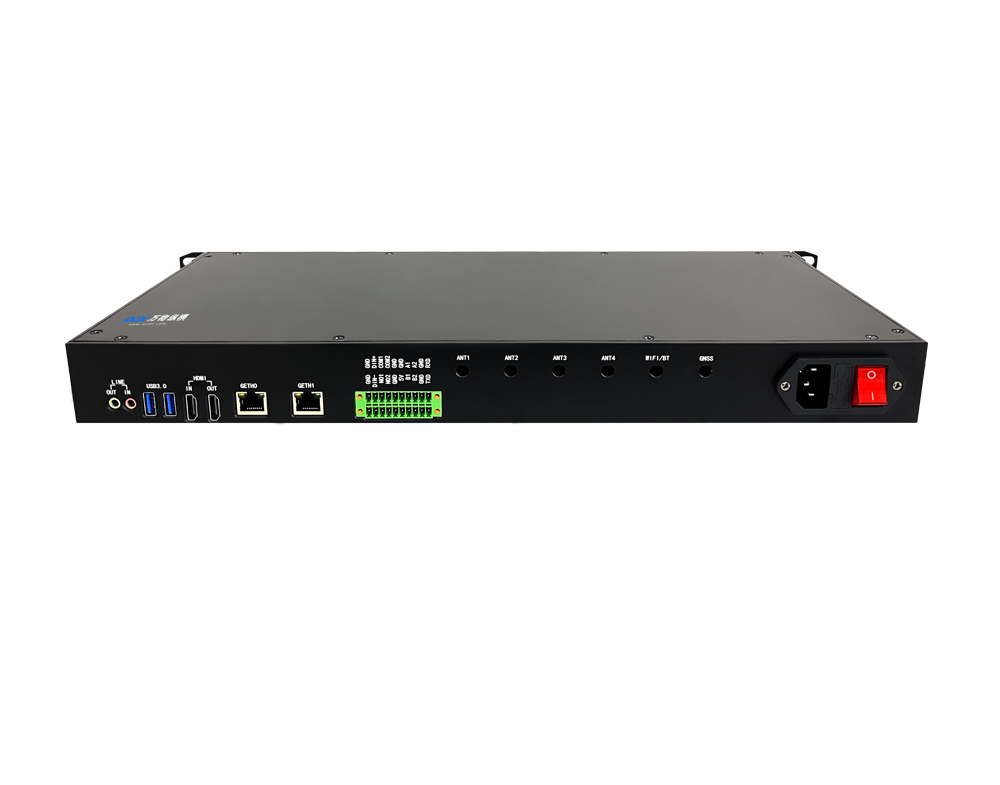
优势:生态完善、工具链稳定、供货可控、功耗友好、风冷方案成熟;多卡级联方案成熟,万物纵横等厂商已有1U机架四路RK1828算力服务器方案,适合批量工业质检、明厨亮灶、工地安防、轻量RAG知识库、端侧Agent
短板:上限锁定7B–9B区间,更大参数模型需要多卡堆叠,内存总量相比LQ50 Duo差距明显
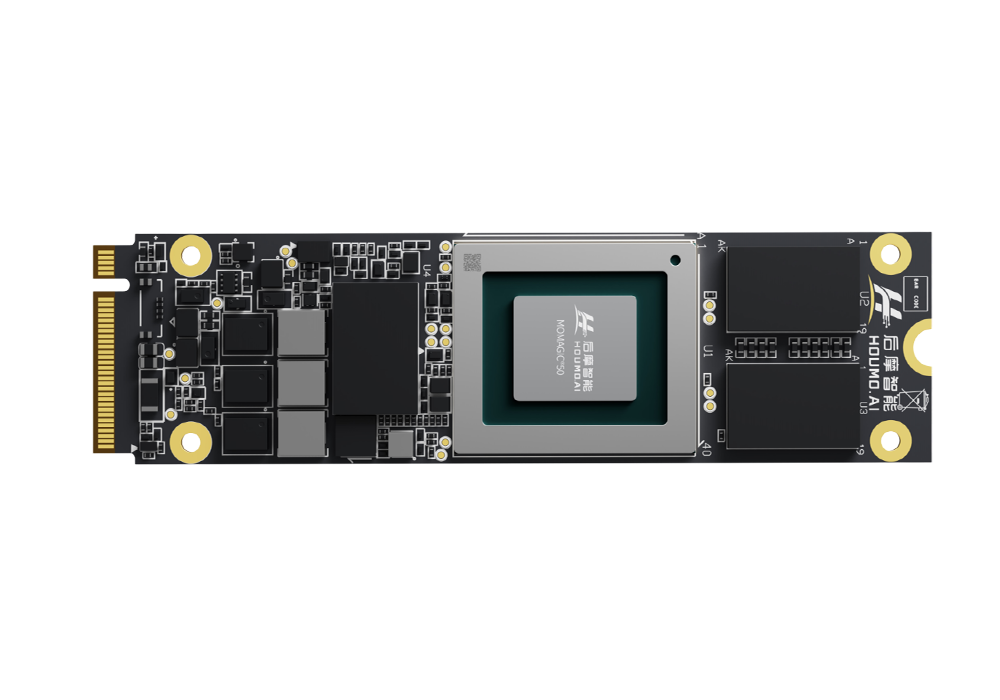
LQ50 DUO 双芯算力卡(后摩智能·力擎)
规格:Dual M.2形态,双漫界M50存算一体芯片,弹性最高320TOPS INT8,板载48GB LPDDR5、307.2GB/s带宽;自研C-to-C芯间互联,双芯协同推理
适配:后摩大道软件栈,主打14B~35B大模型本地推理,适合私有化行业知识库、多模态高并发、AI工作站、边缘大模型一体机
优势:存算一体架构,LLM解码吞吐、首token延迟表现突出;超大片载内存,大幅减少KV Cache交换开销;单卡即可承载更大参数模型,减少多卡调度成本
短板:生态起步晚于瑞芯微,框架迁移工作量更大,单价更高,适合预算充足、目标部署14B以上大模型的项目
选型对比与采购决策要点
项目 | RK1828算力卡 | LQ50 DUO双芯算力卡 |
定位 | 轻中度边缘大模型、视觉算法、规模化批量项目 | 高性能边缘、中大型参数私有化模型 |
典型承载模型 | 3B–7B,双卡到9B | 14B–35B |
单卡内存 | 5GB | 48GB |
算力 | 20TOPS INT8 | 320TOPS INT8 |
接口 | M.2 2280 单卡 | Dual M.2双芯卡 |
核心亮点 | 生态成熟、成本可控、工业场景验证充分 | 存算一体、超大内存、大模型原生优势 |
适合客户 | 集成商、安防/家政/工业产线、大批量盒子项目 | 私有化政企、本地知识库、AI工作站、高价值Agent |
采购落地趋势
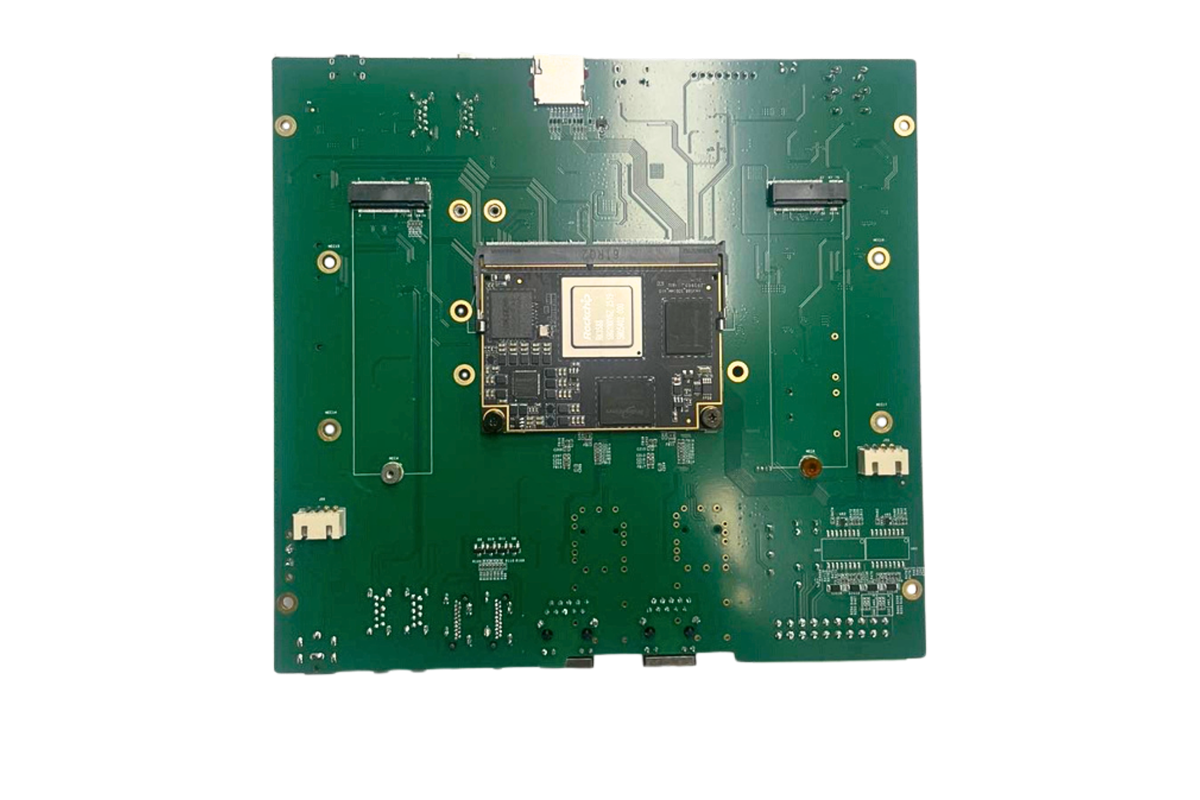
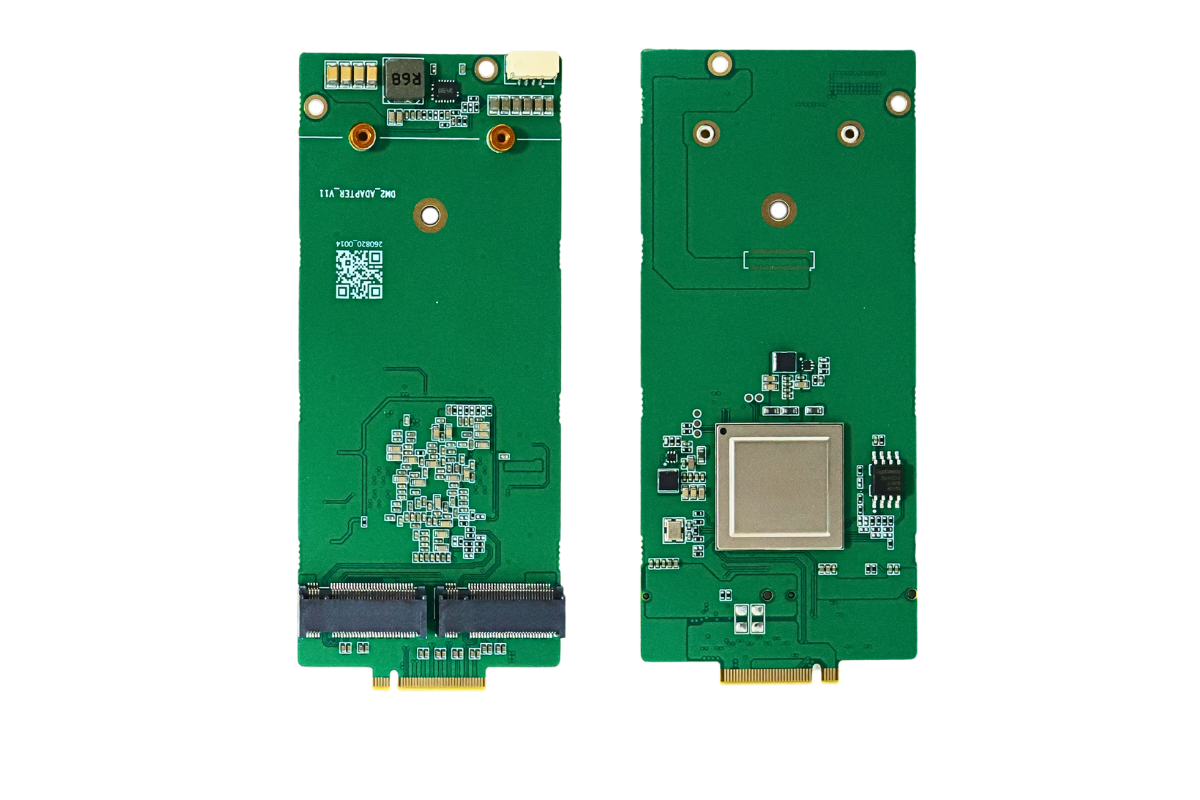
1. 混合选配成为主流:同一硬件底板双M.2槽位,可按需混插RK1828、LQ50 Duo,一套硬件平台覆盖轻量化视觉识别和大模型问答两种业务,降低硬件SKU管理成本
2. 国产信创兼容权重上升:两类方案都在推进麒麟系统适配,是边缘信创算力盒子、本地推理服务器的热门备选
3. 评估不再只看TOPS:采购评审重点转向KV Cache带宽、TTFT首token时延、长上下文吞吐、SDK易用度、售后技术支持、批量交付周期,单纯算力数值参考意义下降
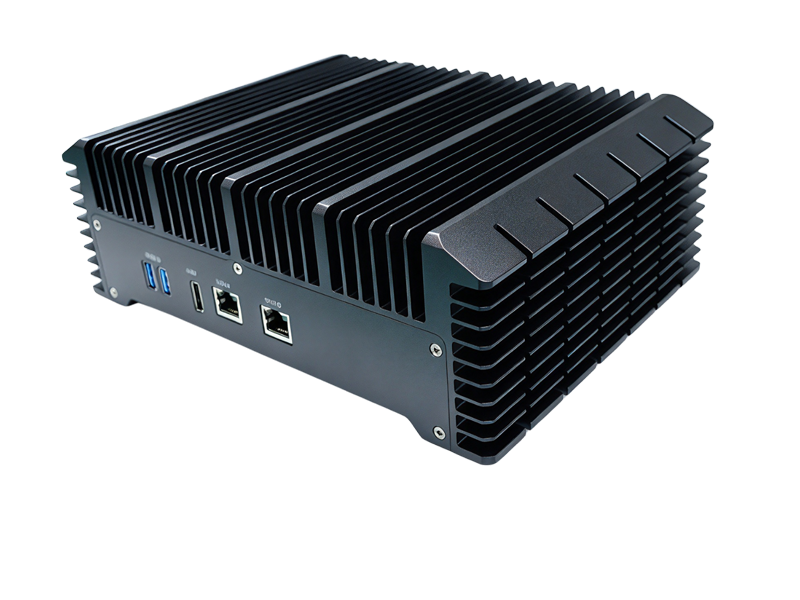
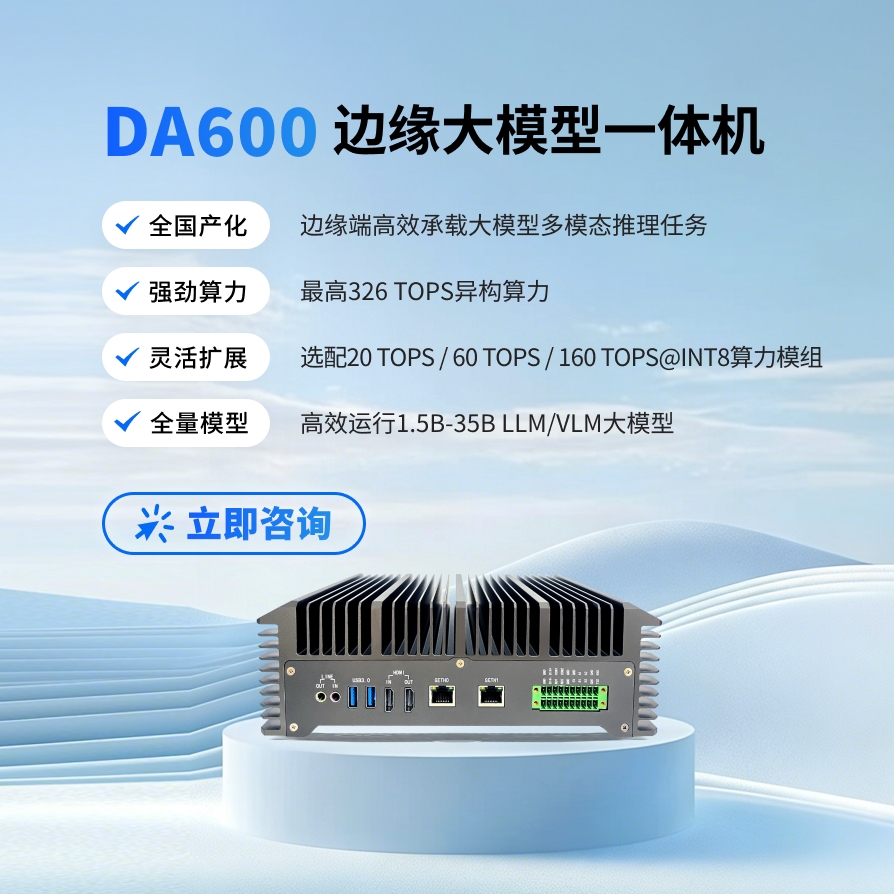
4. 方案商打包交付:万物纵横等厂商推出基于两类算力卡的AI算法盒子、大模型一体机整机方案,配套YOLO、多模态、RAG预装镜像,缩短项目落地周期
选型建议
跑7B以内、视觉检测为主、走量控成本:优先 RK1828
需要本地跑14B+大模型、看重长上下文和高吞吐私有化推理:优先 LQ50 DUO
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部