
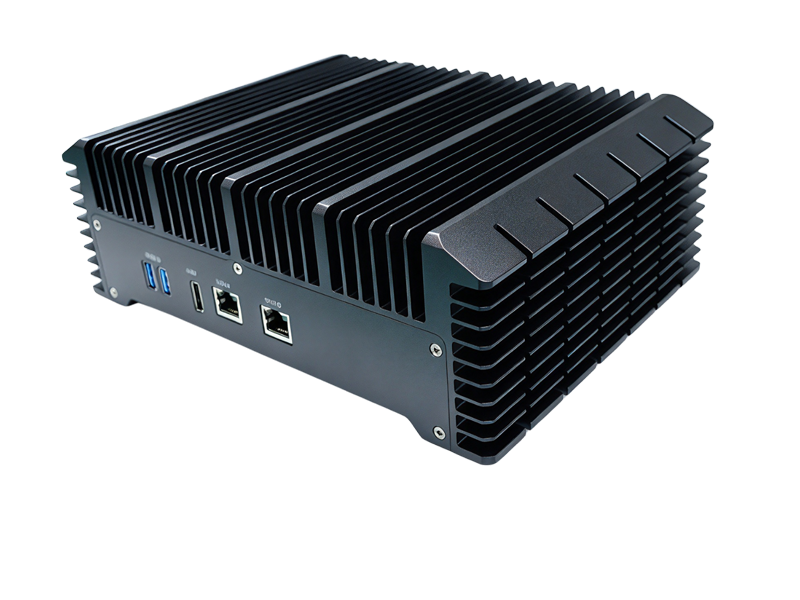
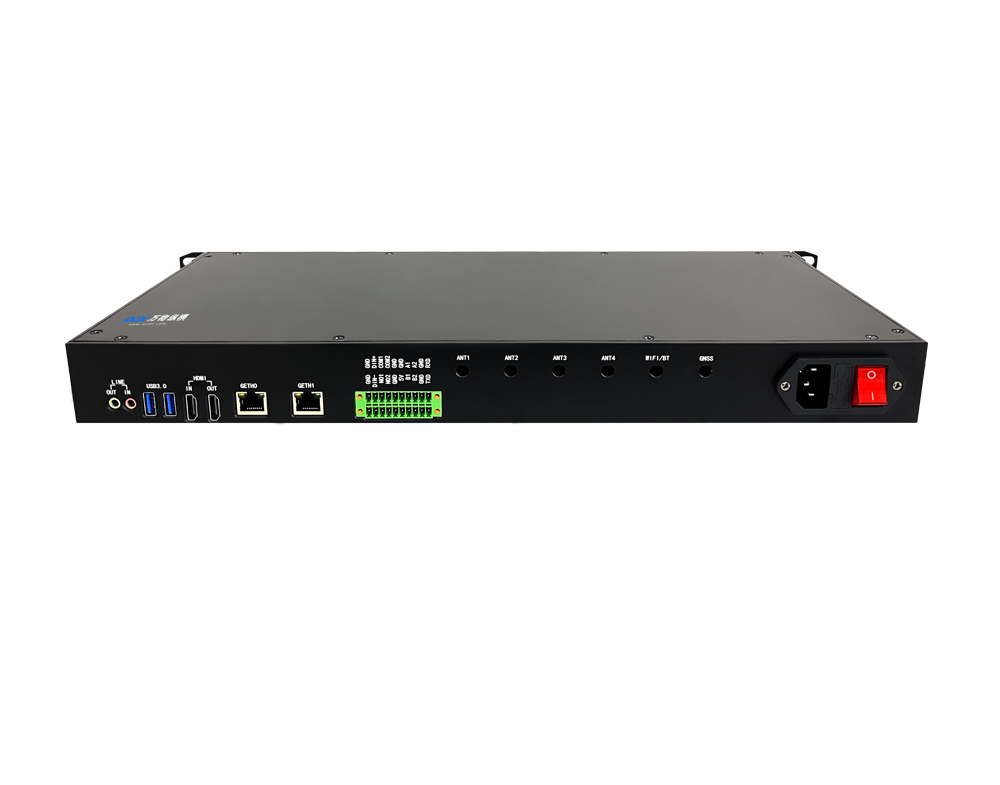
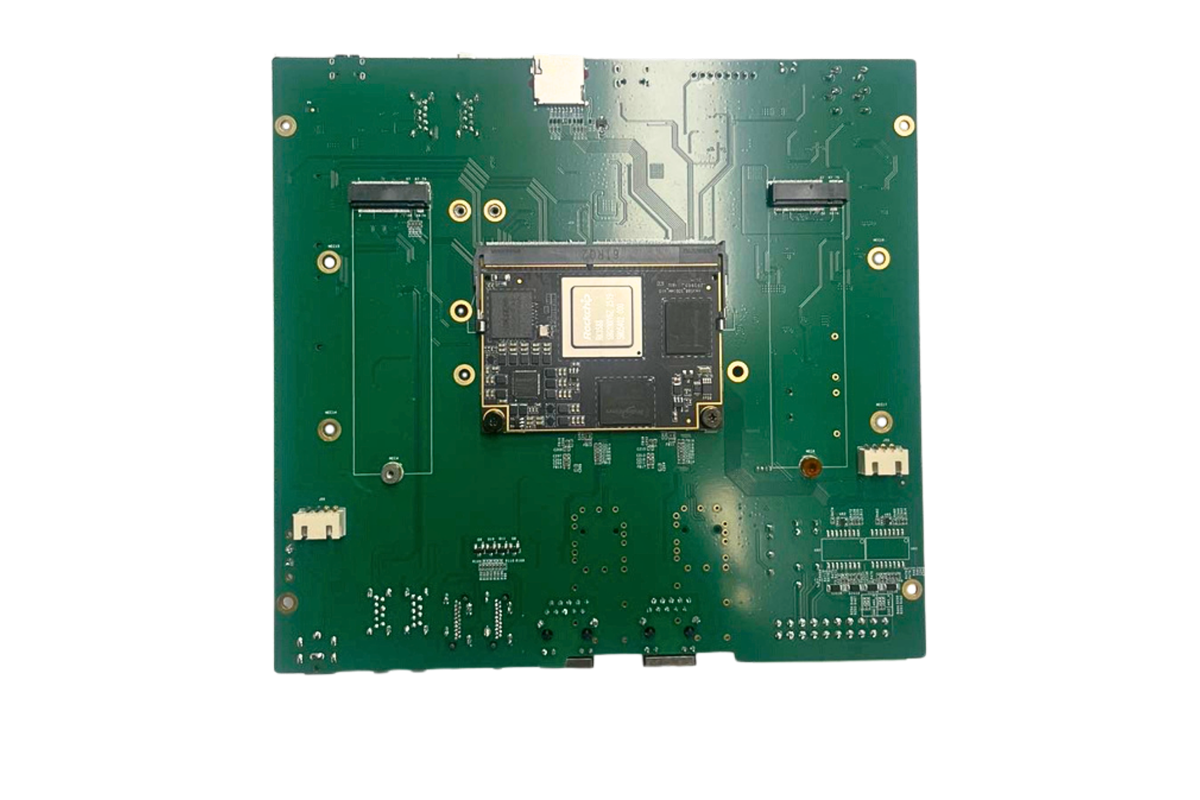


核心结论:RK3588内置6TOPS NPU在多路视频结构化、7B+大模型等场景下算力触顶,通过板载M.2 Key M PCIe接口外接AI算力卡,可实现不改板、不换主控的弹性算力扩容,是2026年边缘计算领域最主流的升级路径。
一、什么时候需要扩展算力
1.1 优先优化原生NPU(无需额外硬件)
如果是以下场景,先通过软件调优即可,不必急着加卡:
模型规模小:YOLOv5n/8n、轻量分类模型,1~2路1080P视频推理
优化手段:RKNN工具链INT4/INT8量化、算子融合、内存零拷贝、关闭非必要后台服务、CPU/NPU调频
优化后上限:单路YOLOv8s约25~30fps,7B大模型可低速运行,仅适合演示、低并发场景
1.2 必须上M.2算力扩展的场景
4路以上1080P/2K视频实时分析,或多模型串行(检测+跟踪+识别+OCR)
7B/13B本地大模型流畅对话、多模态图文理解、工业高精度缺陷检测
项目硬件已定型,无法重新画板,需要快速提升算力而不影响原有结构
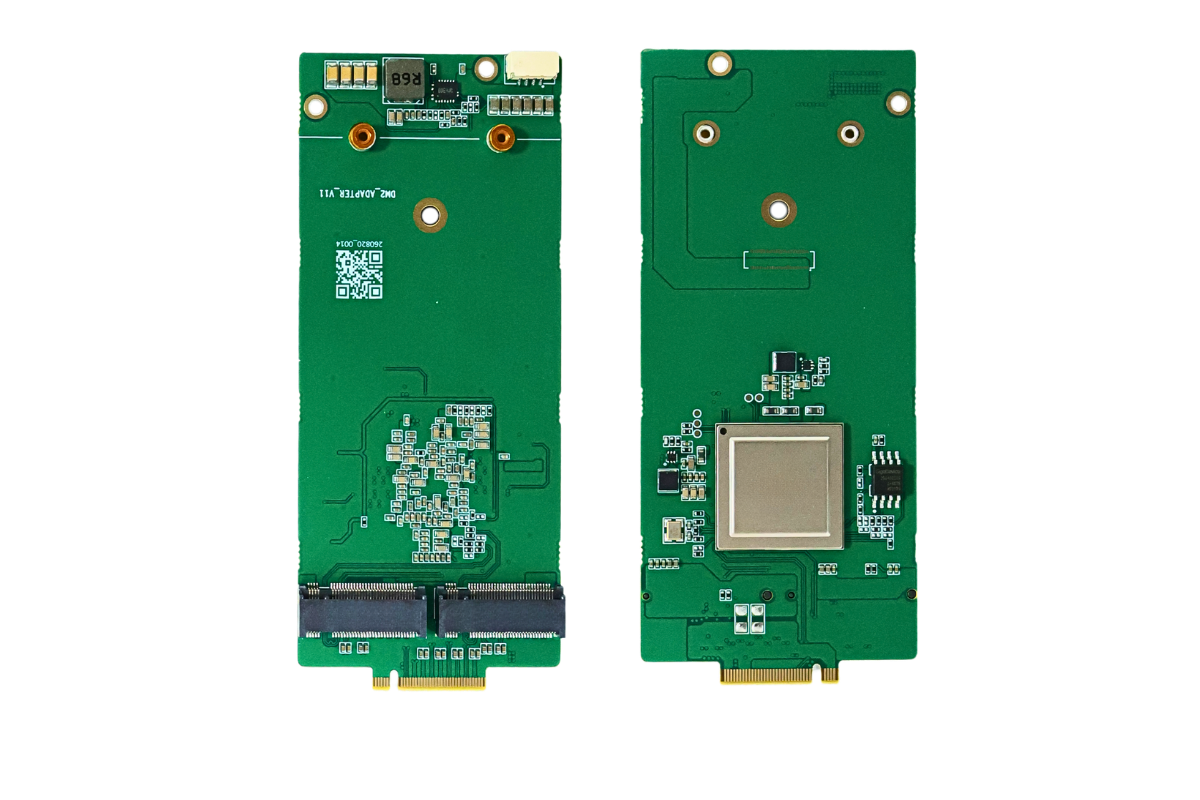
二、M.2 PCIe扩展的核心原理
这套方案的本质是异构算力分流,充分发挥两边的硬件优势:
RK3588 主控
视频采集、ISP处理
音视频编解码
业务逻辑调度
外设交互
M.2算力卡 专职推理
AI模型计算
不参与业务逻辑
通过PCIe高速总线交互
数据延迟低、吞吐大
2.1 RK3588的PCIe硬件基础
1组PCIe 3.0 x4控制器,支持拆分(bifurcation)为x2+x2、x1+x1+x1+x1等模式,是外接算力卡的主力通道
3组Combo PHY,支持PCIe 2.1 / SATA3.0 / USB3.0复用,部分开发板的M.2走这个通道,带宽相对更低
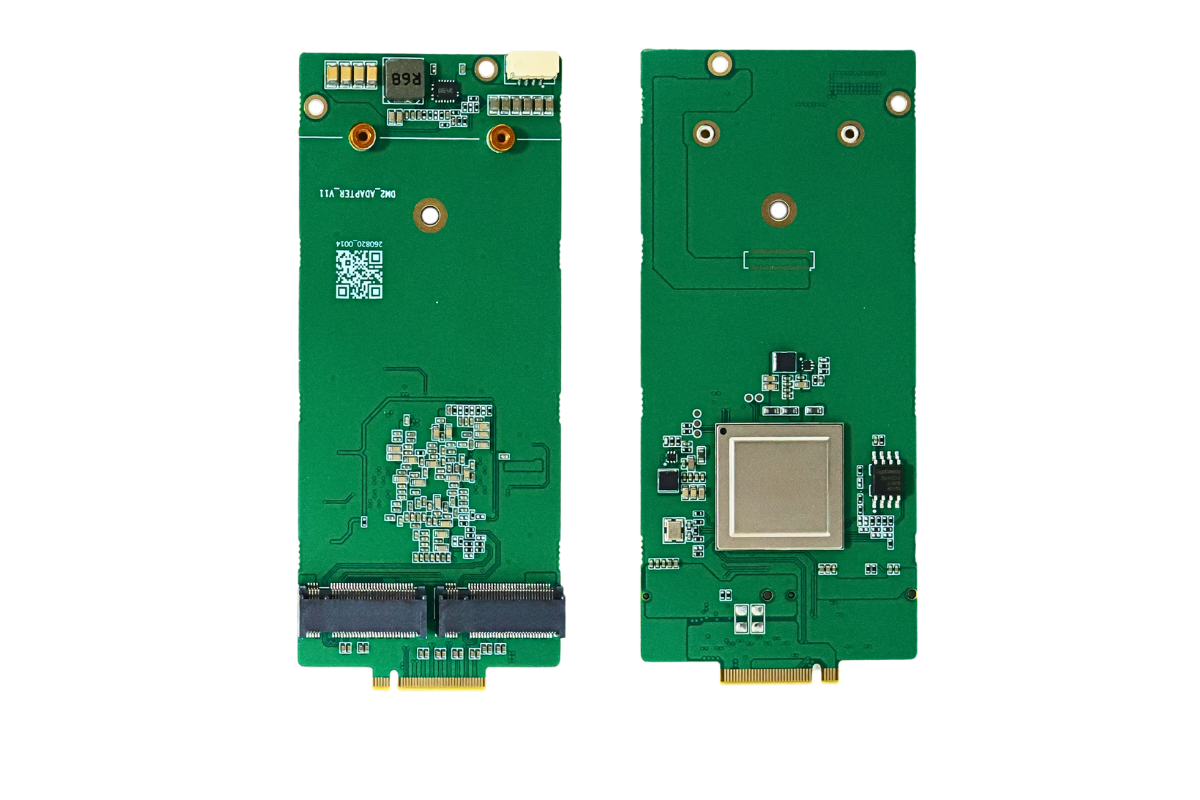
部分高端RK3588工业底板已配备双M.2插槽,可通过PCIe拆分同时接2张算力卡,算力实现翻倍扩展
三、2026热门M.2 AI算力卡横向对比
算力卡型号 | INT8峰值算力 | 典型功耗 | 接口规格 | 核心优势 | 主要短板 | 适配场景 |
Hailo-8 | 26TOPS | 2.5W | M.2 Key M,PCIe3.0 x4 | 视觉CNN能效比极强,YOLO系列帧率高,驱动成熟,支持工业宽温 | 大模型支持较弱 | 多路安防、工业视觉、NVR智能分析 |
杰和LM2-100-V0 | 25TOPS | 2~5W | M.2 B+M Key,PCIe3.0 x2 | 国产方案,能效比高,2242小尺寸,兼容Key B插槽 | x2带宽限制大模型吞吐 | 低功耗嵌入式盒子、小型AI终端 |
DEEPX DX-M1M | 25TOPS | 2.46W | M.2 Key M,PCIe3.0 x2 | 超低功耗,国产自主,x2通道即可跑满 | 生态覆盖面较小 | 电池供电设备、低功耗边缘节点 |
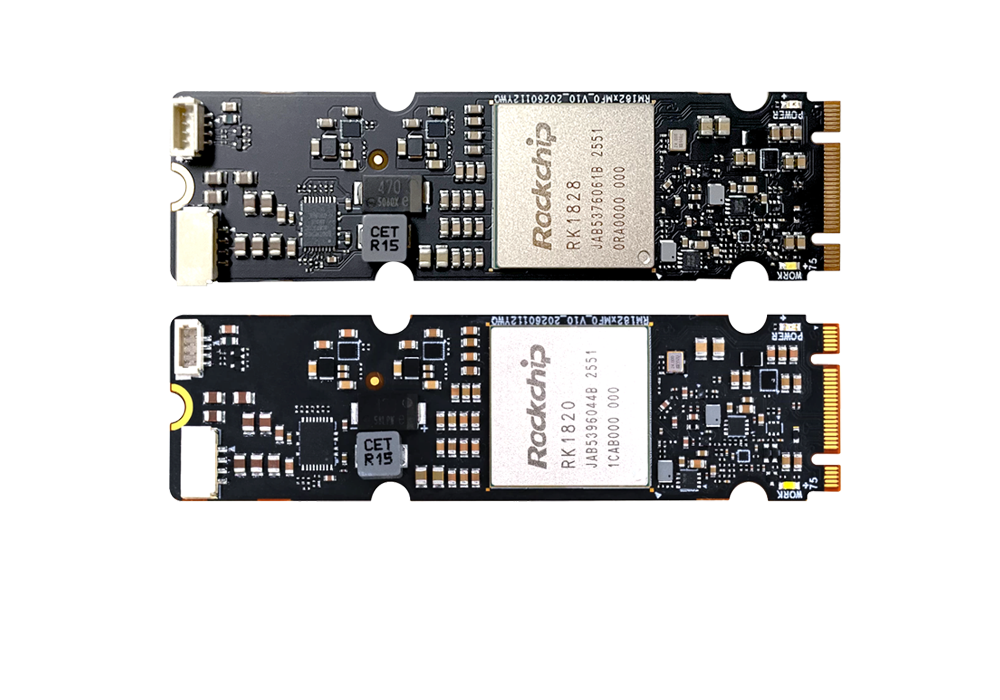
RK1828 M.2 | 20TOPS | ~10W | M.2 Key M,PCIe3.0 x4 | 瑞芯微自家生态,RKNN/RKLLM一套工具链,开发成本最低,板载大显存 | 单卡算力中等 | 国产大模型部署、多模态推理、瑞芯生态项目 |
算能BM1688 M.2 | 16TOPS | 5~8W | M.2 Key M,PCIe3.0 x4 | BMRT工具链成熟,安防行业模型适配多 | 大模型推理性能一般 | 传统视觉分析、人脸抓拍、结构化分析 |
后摩LQ50(HM50) | 160TOPS | ~21W | M.2 Key M,PCIe3.0 x4 | 存算一体架构,24GB大显存,BF16算力强,支持百亿级大模型 | 功耗与发热较高 | 本地7B/13B大模型、VLM图文理解、边缘Agent |
实测参考:RK3588 + Hailo-8组合,运行YOLOv8s平均帧率达84.7fps,RK3588 CPU占用仅10%左右,主控负载极低。
四、硬件落地必踩的核心坑点
4.1 接口与通道模式切换
主流算力卡均为M.2 Key M规格,Key B/E插槽无法使用;部分B+M Key的卡(如LM2-100)可兼容,但带宽仅x2
绝大多数RK3588开发板的M.2插槽默认配置为NVMe SSD模式,PCIe通道常与SATA/USB3复用,必须修改设备树(dts)切换为PCIe RC模式,否则插卡无法识别
PCIe3.0 x4拆分双x2需要硬件底板支持+设备树配置,不是所有板子都支持
4.2 供电是头号故障源
功耗等级 | 代表型号 | 供电要求 |
低功耗(2~5W) | Hailo-8、DEEPX、LM2-100 | 普通M.2插槽3.3V供电即可满足 |
中功耗(~10W) | RK1828、BM1688 | 需确认底板3.3V供电≥3A |
高功耗(20W+) | LQ50 | 普通底板M.2供电普遍不足,会出现掉卡、死机、降频,需要额外供电或定制底板 |
4.3 散热与结构适配
5W以内的算力卡可被动散热,适合密闭工业盒子
10W以上必须加装散热片+风扇,工业宽温场景需选型工业级卡
注意M.2插槽的高度空间,很多超薄机箱装不下带散热模组的算力卡
五、软件适配与异构调度逻辑
RK3588 + M.2算力卡是两套独立的推理引擎,算力不能直接数值叠加,核心是任务拆分调度:
工具链各自独立:Hailo用HailoRT转HEF模型,瑞芯系用RKNN/RKLLM,算能用BMRT编译bmodel
最优调度逻辑:视频流/输入数据由RK3588采集、预处理(缩放、格式转换),通过PCIe DMA零拷贝发送给算力卡,推理完成后结果回传主控执行业务逻辑
开发门槛最低的组合:RK1828 + RK3588——共用RKNN工具链,模型一次转换可在两个芯片上调度,RKLLM大模型框架原生支持,适合快速落地国产大模型方案。
六、其他替代方案对比
方案 | 优势 | 劣势 | 适合场景 |
USB AI加速棒 | 即插即用,不用修改设备树 | USB带宽低,延迟高,多路视频吞吐差 | 原型验证、临时调试 |
更换高算力主控 (RK1828主板) | 单芯片方案,结构简洁 | 需重新画板、改结构、重走认证,周期长 | 新项目从零开始 |
云端推理 | 算力无上限,不用管硬件 | 依赖网络,有隐私风险,延迟高 | 非实时、非离线场景 |
七、选型极简建议
纯视觉多路检测、低功耗工业场景:**Hailo-8**
国产替代、小体积低功耗终端:**杰和 LM2-100-V0 / DEEPX DX-M1M**
追求统一开发生态、部署国产大模型:**RK1828 M.2**
本地跑 7B/13B 大模型、多模态 VLM:**后摩 LQ50**
需要双卡扩容、多传感器接入:选择带双 M.2 插槽的 RK3588 工业底板
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部