
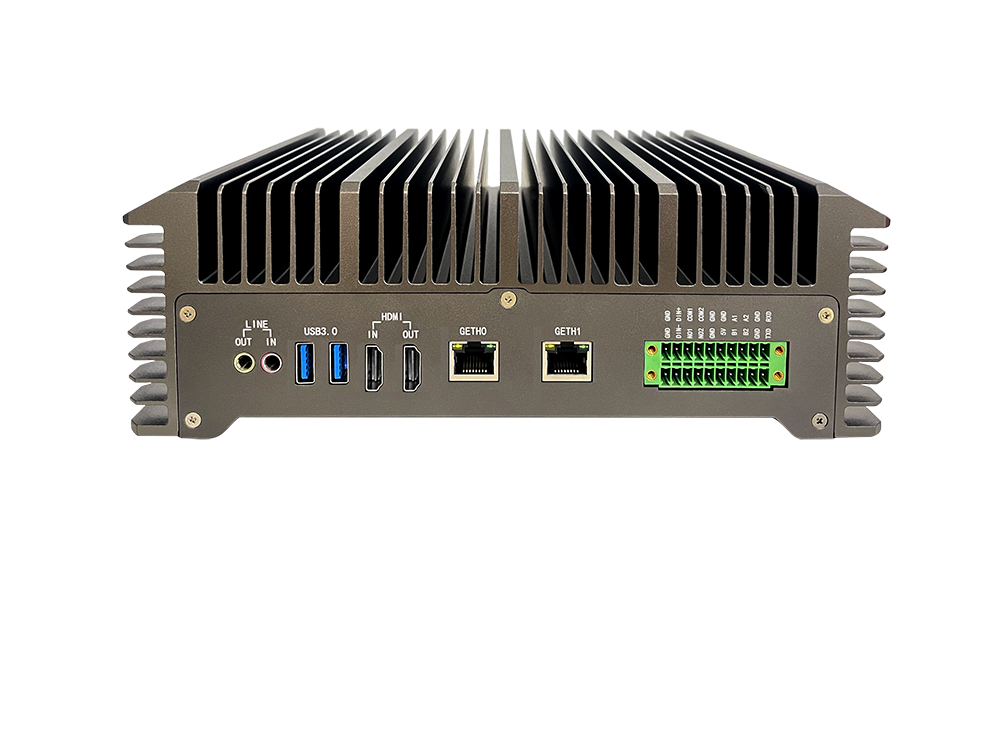
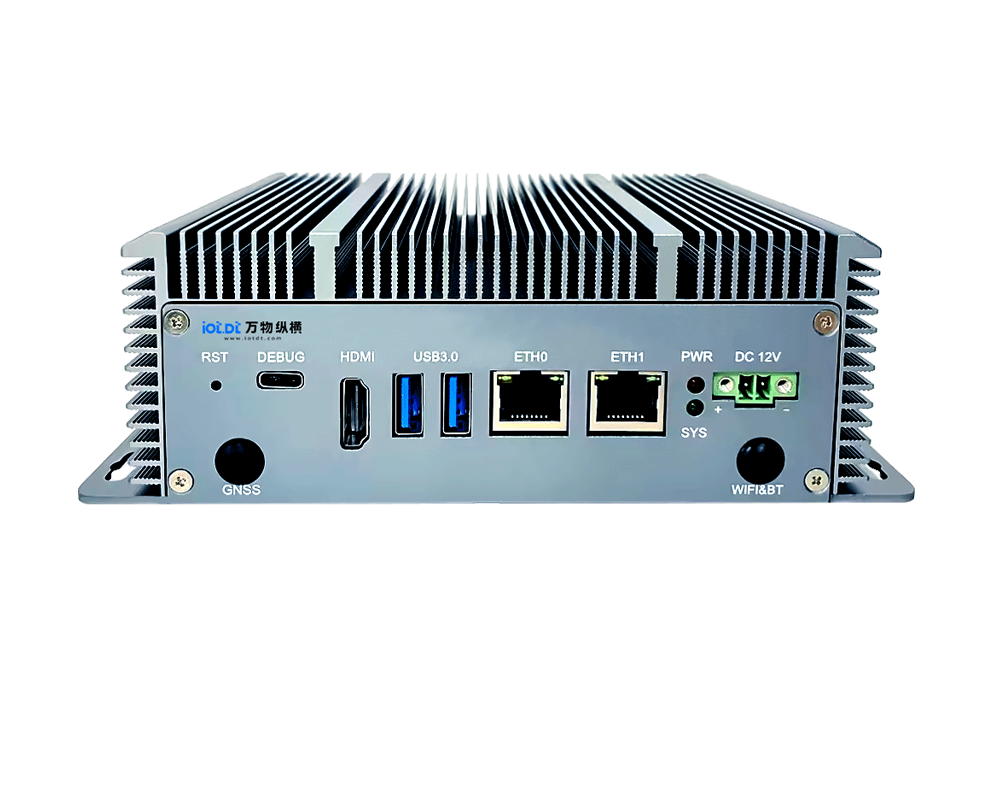
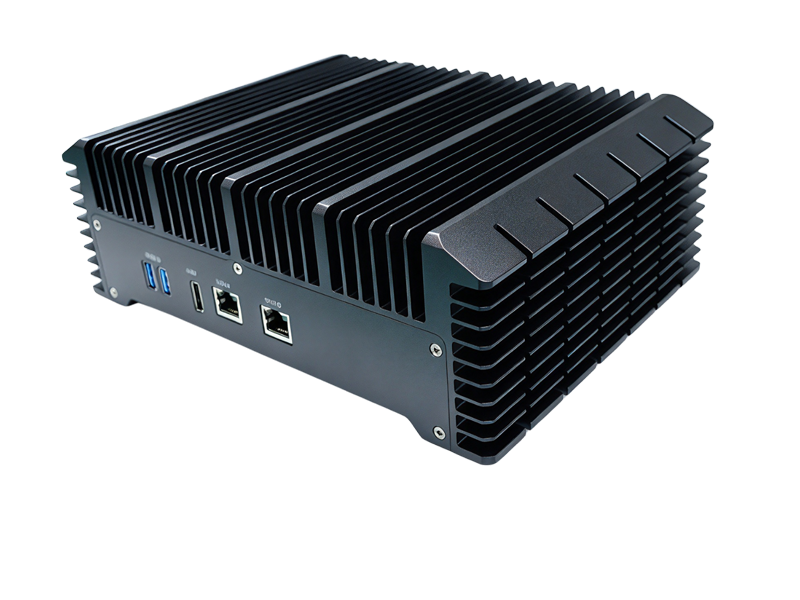
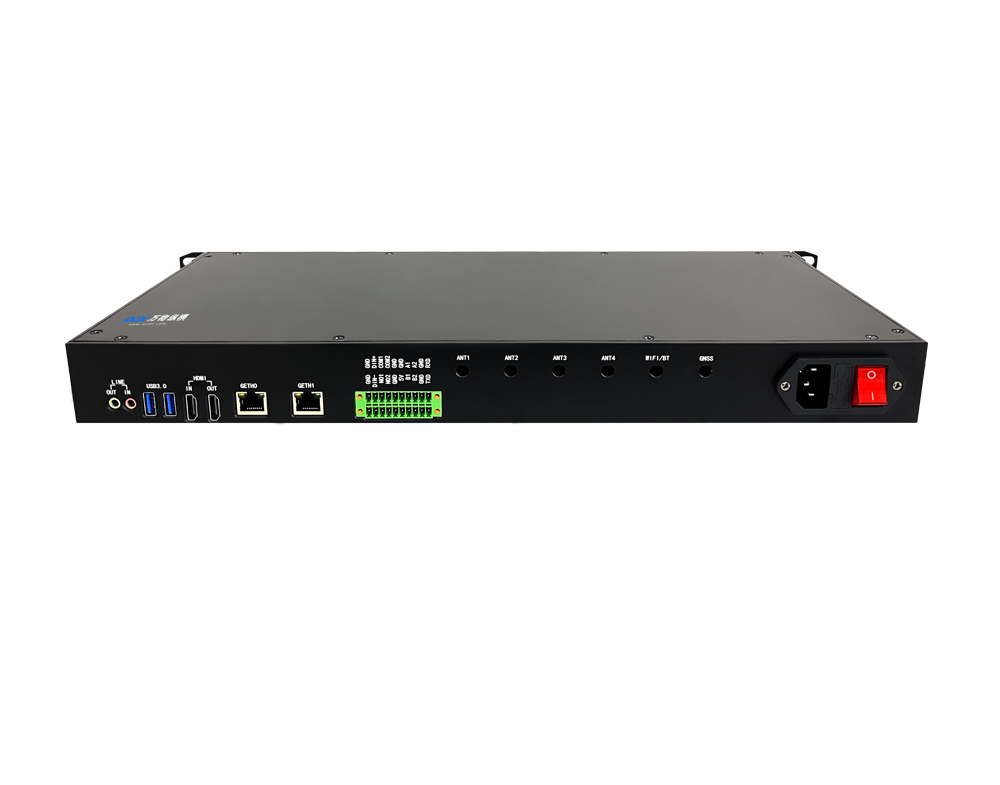


核心判断:CV186AH 赢在安防多路长跑,RK3588 赢在通用算力与生态
8 路更稳:视频流原生的 TPU 架构,8 路 1080P 单算法长时运行,丢帧与推理抖动小于 RK3588。
资源更宽:16 路硬解余量可支撑分析之外的同时预览、推流与录像。
功耗更低:典型 10~12W、被动散热、-20~+60℃ 宽温,适合无人值守现场。
短板明确:A53 弱核,加上大模型、带屏交互与开源生态不足,复杂业务与多模态场景应选 RK3588。

1. 对标结论:差异不在纸面算力,而在算力的使用方式
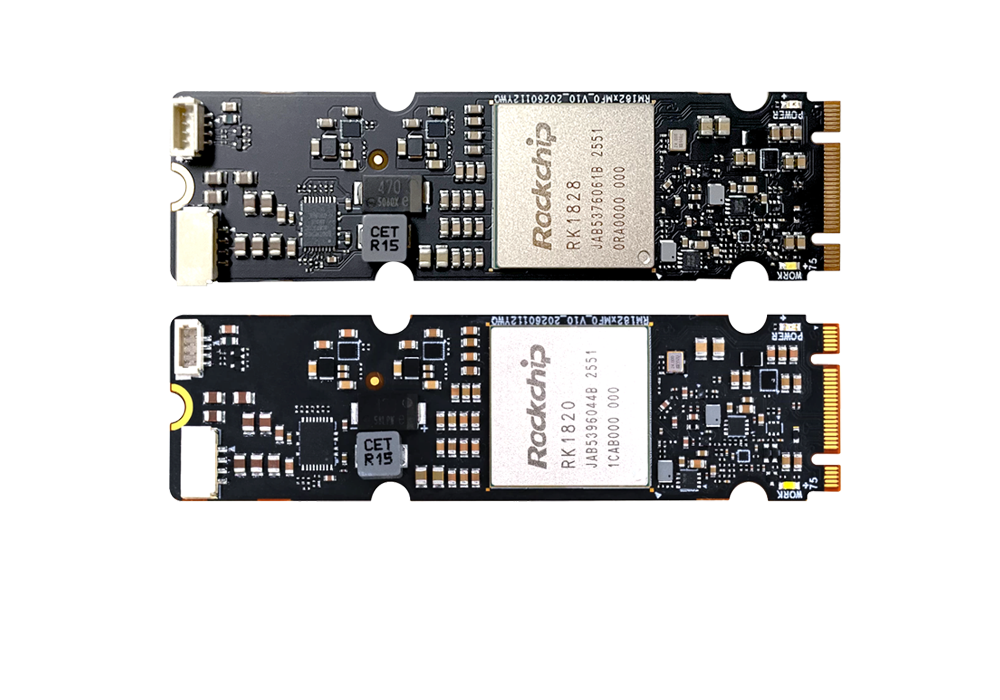
把两颗芯片放进同一台 8 路视频分析盒子里比较,最先被注意到的往往是算力数字:CV186AH 标称 7.2 TOPS INT8、12 TOPS INT4,高于 RK3588 的 6 TOPS INT8。但这个差距解释不了实测表现,因为 TOPS 只是峰值吞吐,真正决定多路视频能否稳定跑满的是流水线结构。CV186AH 的 VPSS 与 TPU 是按视频流设计的,缩放、裁剪、鱼眼展开等前处理在硬件里完成,图像进来就能直接推理,CPU 只负责调度和轻量后处理;RK3588 的 NPU 更通用,前处理链路往往要靠 CPU 与 GPU 分担,多路并发时资源竞争更明显。这就是为什么算力更低的 RK3588 在单路测试里不落下风,到了 8 路同时满载却更容易出现帧率波动。
另一侧的差距同样由架构决定。RK3588 的 4 核 A76 加 4 核 A55、Mali GPU 与成熟的 RKNN 工具链,让业务逻辑、可视化界面、本地小参数模型都有落脚点;CV186AH 的 6 核 A53 在复杂后处理、多目标跨帧关联和并发网络服务上明显吃力。因此这次对标更准确的结论是场景分工:CV186AH 是把一路路视频稳定跑完的专业设备,RK3588 是能承载更多类型任务的通用平台。
规格对照:同口径下的硬件差异
维度 | ||
CPU | 6 核 A53 @1.6GHz | 4 核 A76 + 4 核 A55 |
NPU 算力 | 7.2 TOPS INT8 / 12 TOPS INT4 | 6 TOPS INT8 |
视频编解码 | 16 路 1080P 硬解、10 路硬编 | 16 路 1080P 解码 |
图形能力 | 无强 GPU,界面渲染能力弱 | Mali GPU,支持 HMI、带屏交互与可视化 |
功耗与散热 | 典型 10~12W,可被动散热 | 高负载普遍 15W 以上,多数方案需风扇 |
工作温度 | 工业宽温 -20~+60℃ | 以商用温度为主,宽温依赖整机方案 |
网络与安全 | 双千兆,自带 SM4 国密 | 多形态网口方案,无内置国密加速 |
特色硬件加速 | 鱼眼、畸变校正、图像拼接 | 依赖 GPU 或软件实现 |
生态与开发 | 与 BM1684X 工具链兼容,安防算法现成可迁 | RKNN 生态成熟,社区、教程与第三方项目多 |
这张表里最容易被误读的是算力行。CV186AH 的 7.2 TOPS 是 INT8 峰值,且与 INT4 档位共用同一套量化路径,实际能跑出多少帧取决于模型结构和前处理是否走硬件;RK3588 的 6 TOPS 更偏向单路大模型的通用推理。所以采购时不要拿 TOPS 直接比价,而要按“目标算法 × 目标路数 × 目标帧率”这一组条件去实测。表的下一层才是真正的差异来源:编解码通道数、散热形态和工作温度,这三项决定了盒子能不能在无人值守的机柜或户外箱体里连续跑上一年。
2. 四项实测优势:多路、编解码、功耗与算法迁移
2.1 8 路并发跑得稳,单路推理 18~25ms
按 8 路 1080P、25fps 的 RTSP 接入做长时间测试,每路各跑一个 YOLOv5s 或 YOLOv8n 单算法,CV186AH 可以做到单路 18~25ms 推理、每路 25fps 稳定输出;连续 7×24 小时运行后,丢帧率和推理耗时抖动都明显小于同条件下的 RK3588。稳定性来自两处:一是解码、缩放、推理在同一条硬件流水线上串起来,中间不落到 CPU 内存来回拷贝;二是 VPSS 承担的图像处理工作量大,CPU 占用被压得很低,长时间运行不容易因为热累积和内存碎片出现掉帧。需要提醒的是,这个成绩对应的是“一路一个算法”,如果某一路要同时叠加人脸、越界、烟火两三个算法,8 路全开的帧率会掉到 4~5 路的水位。
2.2 编解码留有余量,可同时预览、推流与录像
标称 16 路 1080P@30fps 硬解、10 路硬编,意味着 8 路全做 AI 分析之后,解码侧还有富余通道可以挂预览、二次推流和本地录像,不必为了 AI 牺牲观看体验。这一点在多路高负载时比参数更重要:RK3588 的 VPU 与 NPU 在满载下会争抢内存带宽,8 路以上并发时容易出现预览卡顿或推流掉帧,而 CV186AH 的通道是分开核算的,余量能实打实留出来。对项目验收来说,这直接决定“能不能一边分析一边看”这个常被客户追问的功能点。
2.3 功耗与工业稳定性更适合无人值守
整机典型功耗 10~12W,被动散热版本不需要风扇,60℃ 高温环境下不降频;相比之下 RK3588 满载普遍在 15W 以上,多数整机方案必须加风扇才能压住温度。风扇在粉尘、油烟、户外箱体里是典型的故障源,明厨亮灶、智慧工地、变电站这些场景恰恰最怕这一点。宽温 -20~+60℃ 的标称配上无风扇结构,让 CV186AH 的现场运维成本明显低一档,这也是它在安防项目里被反复选用的现实原因,而不只是算力参数。
2.4 算法迁移成本低,安防模型基本可以直接搬
CV186AH 与 BM1684X 共用同一套工具链,市面上大量现成的安防算法——车牌识别、人脸检测、烟火识别、离岗睡岗、安全帽识别——都有可复用的量化脚本和部署样例,迁移到盒子上通常只需重跑一次量化校准。INT4 档位进一步压缩了轻量模型的算力开销,给“提帧率”或“降功耗”留了调节空间。对集成商而言,这部分省下的是人力而不是硬件成本,往往比多 1 TOPS 更实在。反过来,如果项目用的是自研新结构模型,这套工具链对自定义算子的宽容度不如 RKNN,需要提前留出适配时间。
3. 三项短板:CPU、大模型与生态
3.1 6 核 A53 是最大的现实瓶颈
多路视频分析里,NPU 只负责推理那一段,剩下的解码调度、目标跟踪、跨帧关联、告警判定、图片编码、HTTP 与 WebSocket 上报全部压在 CPU 上。6 核 A53 @1.6GHz 的绝对性能有限,一旦算法需要复杂后处理——比如多目标 ID 维持、区域规则判定、抓拍图上传、第三方平台对接——CPU 很容易打满,反过来拖慢整条推理流水线。这是实测里最需要提前评估的一项,也是最容易被“7.2 TOPS”这个数字掩盖的风险。RK3588 的 A76 大核在这类业务逻辑、数据上报和本地服务上要从容得多,同样的后处理代码搬过去,CPU 占用通常低一大截。
3.2 通用 AI 与多模态基本不在能力范围
CV186AH 的定位是视频分析专用加速,不适合跑 7B、14B 级别的本地大模型,也不适合做视觉问答、多模态理解这类任务。RK3588 侧有 RKLLM 支撑的小参数量大模型推理,能跑本地 Agent、图文问答、语音交互一类的复合功能,这是两者能力边界上最硬的一条。如果项目规划里出现“盒子要能对话”“要能看图说话”这类需求,选型阶段就应该排除 CV186AH,不必等到集成时再发现跑不起来。
3.3 图形界面与开源生态明显落后
没有强 GPU,意味着不适合做本地可视化大屏、GUI 配置界面和渲染类交互,带屏产品基本不会考虑它。生态层面差距更直接:RK3588 的社区教程、开源项目、第三方插件和踩坑记录数量远超算能 TPU,新手调试、疑难排查、非标准算子支持都更容易找到答案。CV186AH 的问题排查更多依赖厂商 SDK 文档和原厂支持,这在项目周期紧张时会放大风险。选它等于选了“更专业的设备 + 更窄的社区”,需要有对应的技术支持渠道兜底。
4. 选型建议:按场景定,而不是按算力数字定
项目场景 | 优先选择 | 决定性理由 |
智慧工地、明厨亮灶、园区安防 | CV186AH 8 路盒子 | 多路常规算法长跑、无风扇、宽温,现场运维成本最低 |
能源变电站、机房与无人值守站点 | CV186AH 8 路盒子 | 低功耗、宽温、国密支持,配合国产化验收更顺 |
需要本地大模型、图文问答、语音交互 | RK3588 盒子 | RKLLM 支撑小参数量模型,CV186AH 不具备这条能力 |
机器人、带屏 HMI、可视化交互 | RK3588 盒子 | Mali GPU 与 A76 大核支撑界面、渲染与实时控制 |
自研新算法、需要快速迭代与社区支持 | RK3588 盒子 | RKNN 算子覆盖广、社区资料多,试错成本低 |
既有 BM1684X 算法资产需要下沉 | CV186AH 8 路盒子 | 同工具链,量化脚本与部署流程基本可直接复用 |
这张表的用法是先看第二列再看第三列:先判断项目里有没有“大模型、带屏、自研新算子”这三类需求,只要命中一个,就往 RK3588 走;如果全部不命中,剩下的差异就只是稳定性与运维成本,CV186AH 在这一点上更占优。真正难判断的是中间地带——既有常规多路分析、又想预留一点智能升级空间的项目,这时建议按主力设备选 CV186AH,把大模型需求单独放到一台 RK3588 或边缘服务器上,不要用一颗芯片硬扛两类任务。
5. 采购与验收必查项
1. 核算“路数”的真实口径。市面上 8 路盒子的标注方式并不统一,有的是 8 路并发 AI,有的只是支持接入 8 路摄像头但只能 4 路同时推理。签约前要明确写清每路可跑几个算法、是否持续 25fps、叠加算法后如何降级。
2. 内存按 8GB 起步。4GB 版本在 8 路满载时容易内存吃紧甚至 OOM,尤其是开启抓拍图缓存和本地录像之后,余量会被迅速吃掉。
3. 提前验证模型可转换性。Sophon 工具链对自定义算子的支持不如 RKNN 宽松,新结构模型、注意力模块、后处理算子都要在选型阶段做一次转换验证,不要留到集成阶段。
4. 按目标场景做满负荷压测。至少连续跑 24 小时,记录每路推理耗时、CPU 与内存占用、丢帧数、整机温度,并模拟真实业务的抓拍与上报逻辑,而不是只跑裸推理。
最后要说明结论的边界。上述实测表现来自 8 路 1080P、单路单算法这一组条件,换成 4K 接入、多算法叠加、复杂后处理或不同的 SDK 版本,数值都会变化;算力、编解码与功耗口径取自厂商公开规格,整机实测则受盒子厂商的散热设计与内存配置影响。因此这份对比适合用来确定方向,不适合直接当作验收指标——正式采购仍应按上节第 4 条做压测复核,以自家算法在自己场景下的实测数据作为最终依据。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部