
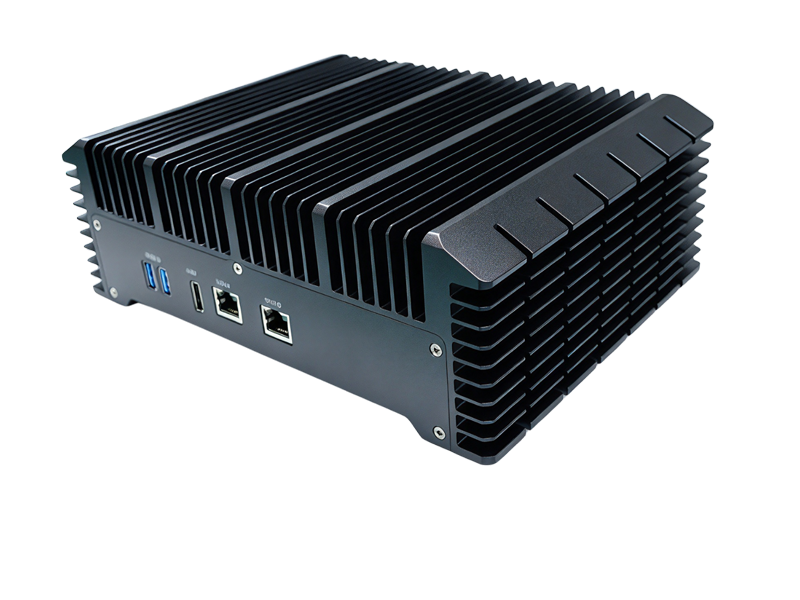
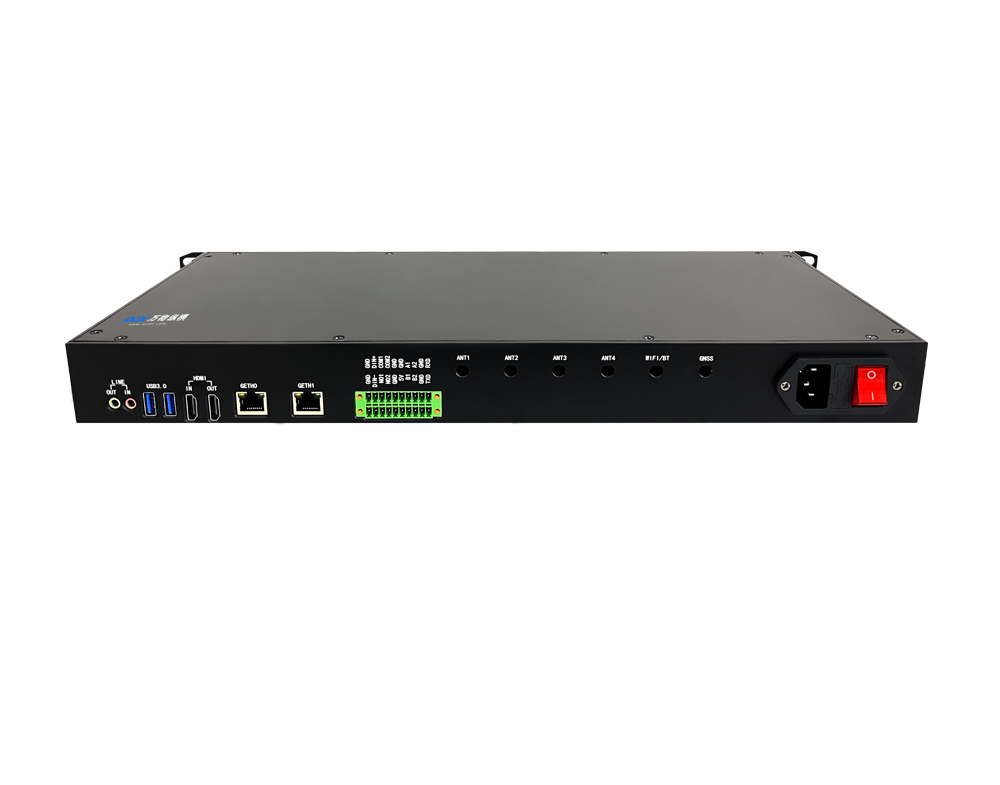


1. SC26 边缘计算赛道前瞻
本届 SC26 以"加速计算与 AI 基础设施"为核心主题,边缘计算正从"配套设备"升级为分布式智算体系的关键节点。参展厂商中,NVIDIA、Intel、AMD 等国际巨头将展示新一代边缘加速方案,EnGenius 等企业将发布 SE110/SE210 系列边缘服务器,国产算力厂商也通过生态伙伴展示端侧推理能力。
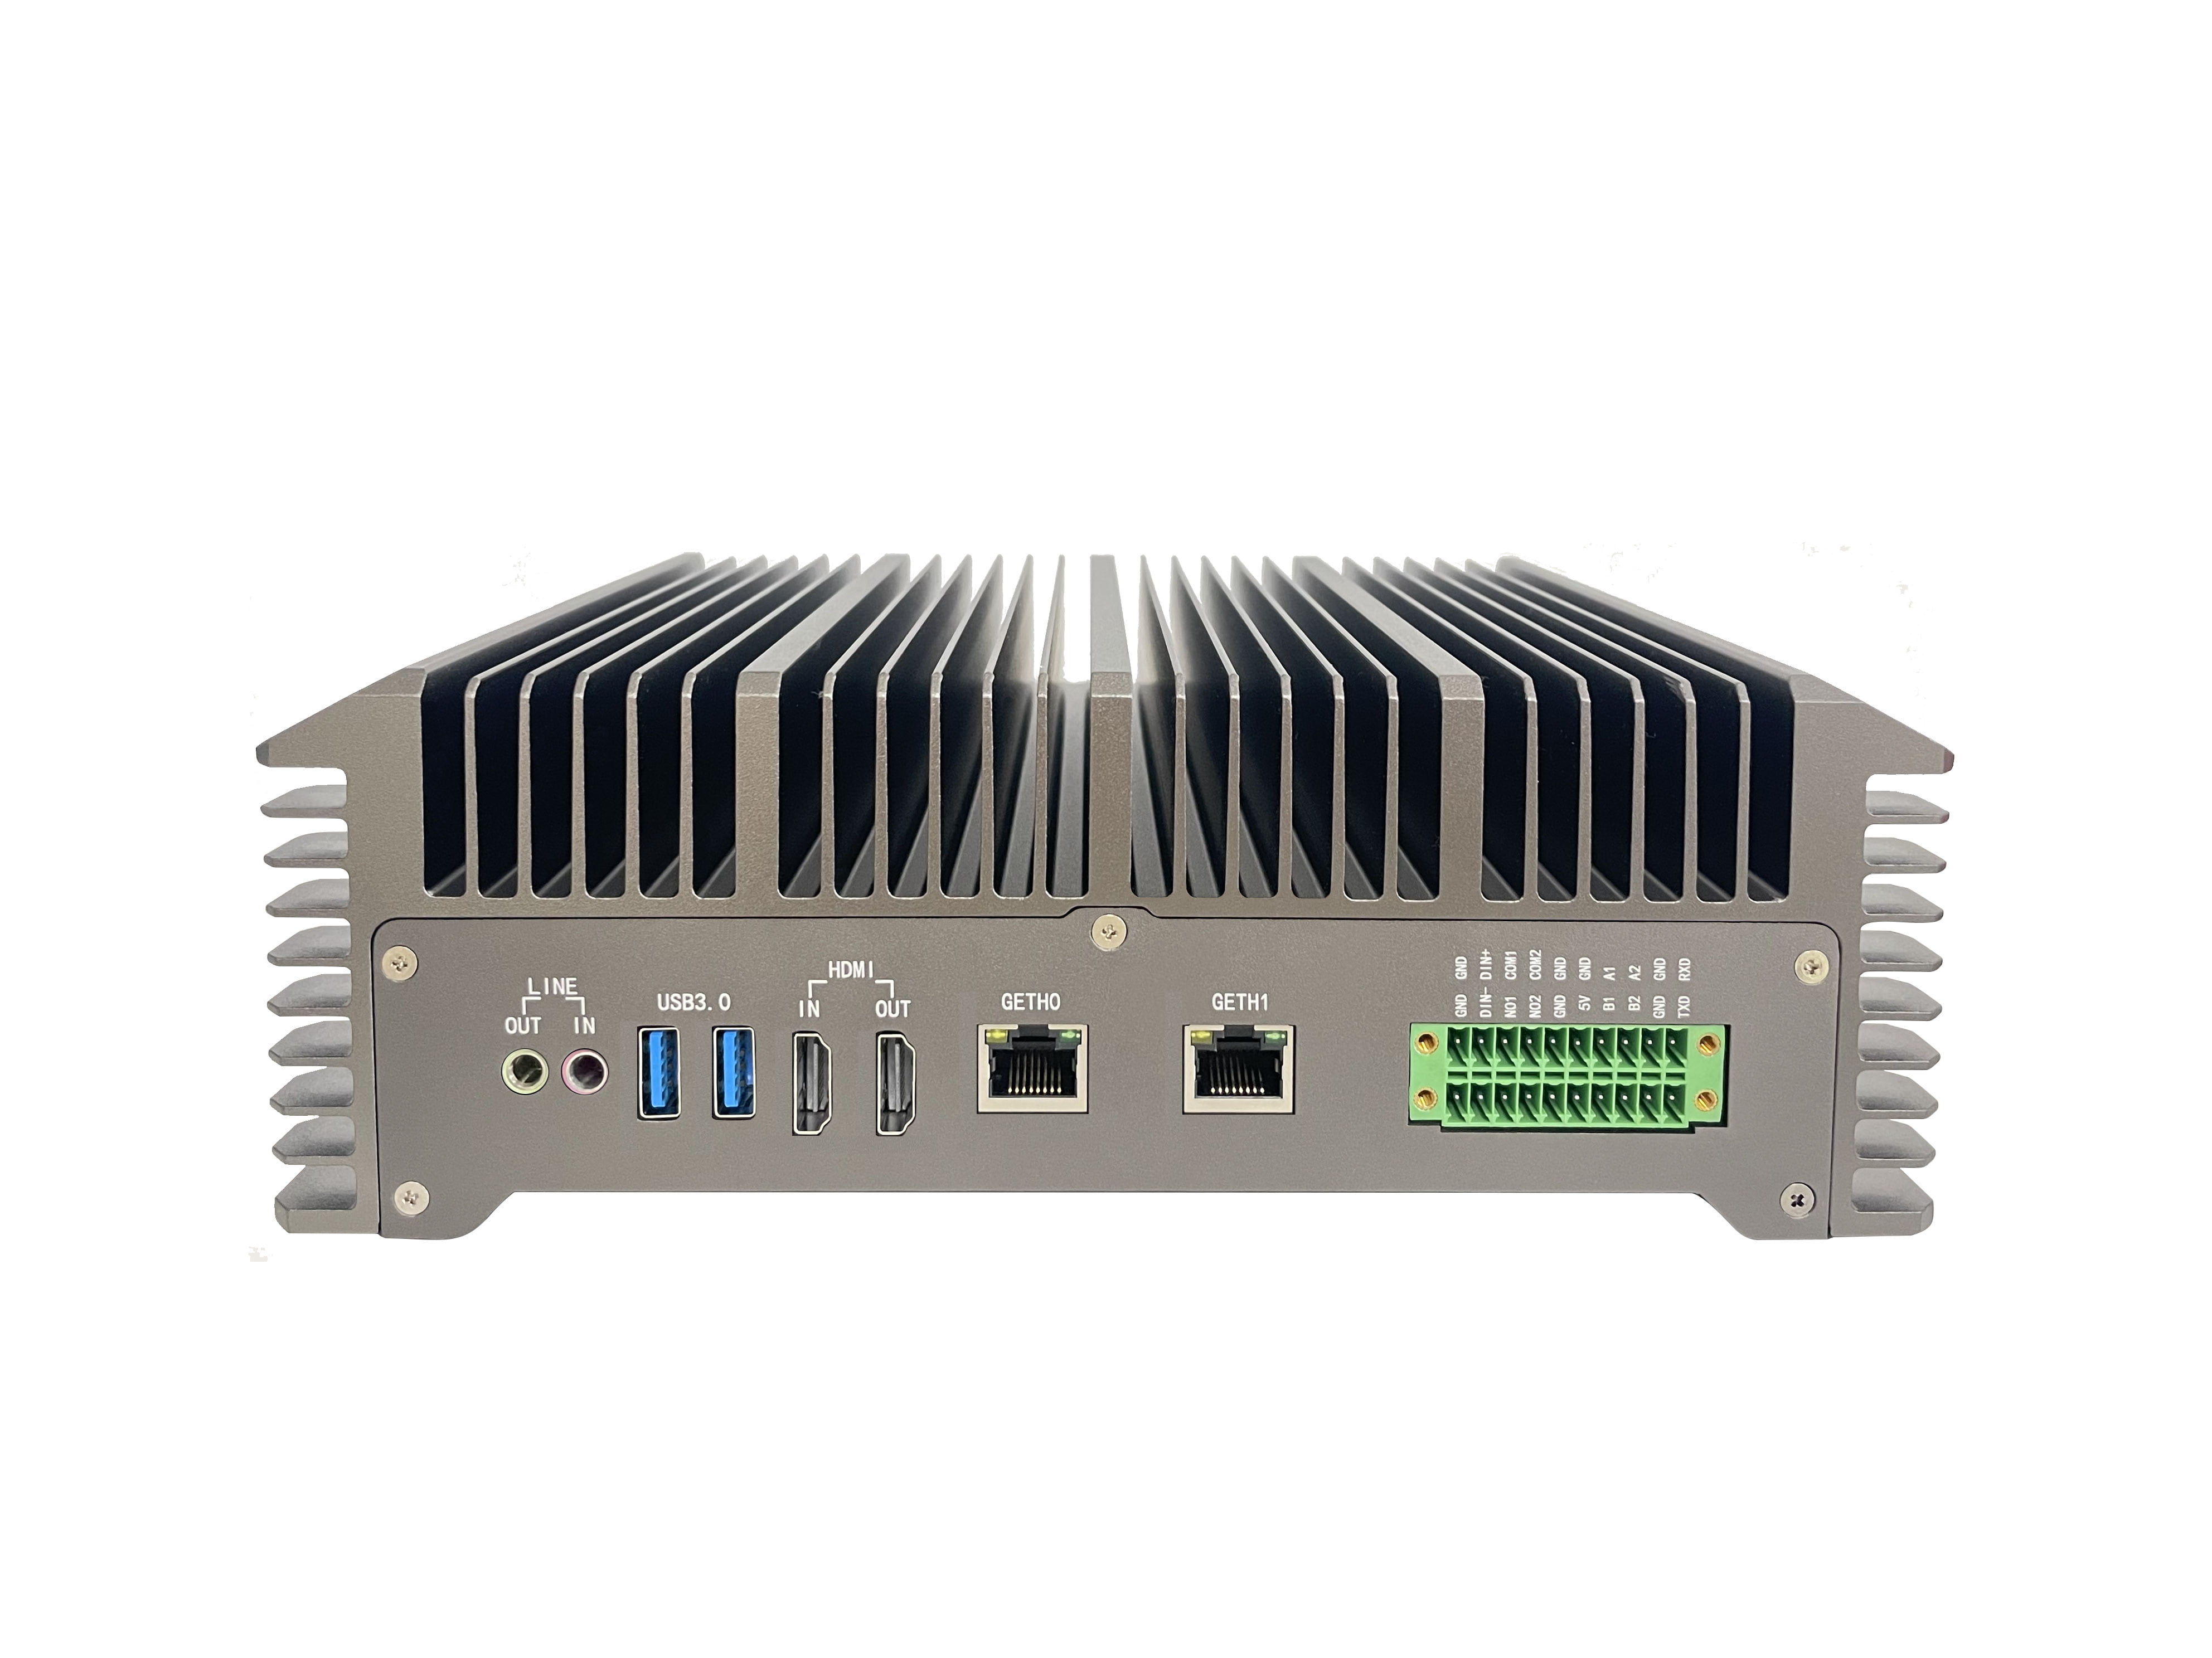
从技术趋势看,2026 年边缘计算盒子呈现三大方向:
算力密度持续提升:单盒 INT8 算力从几 TOPS 向几十甚至上百 TOPS 演进
能效比成为核心指标:工业场景对功耗约束严苛,单位瓦算力成为选型关键
大模型本地化下沉:7B-14B 参数大模型逐步实现边缘端部署,推动"云边协同"向"边端智能"升级
2. 2026 主流边缘计算盒子算力排行榜
以下按 INT8 峰值算力从高到低排序,覆盖国际与国产主流方案,价格为公开渠道整机参考价(工业级配置):
产品型号 | 核心芯片 | INT8 峰值算力 | 典型价格 | 视频解码能力 | 功耗 |
NVIDIA Jetson AGX Orin 32GB | Orin SoC | 200 TOPS | 约 24000 元 | 多路 4K 解码 | 15-60W |
NVIDIA Jetson Orin NX 16GB | Orin NX SoC | 100 TOPS | 约 10500 元 | 多路 1080P | 10-25W |
Firefly AIBOX-1684X | 算能 BM1684X | 32 TOPS | 约 4600 元 | 32 路 1080P | 12-26W |
HTH 华体 EdgeMax Pro | 自研 NPU | 32 TOPS | 未完全公开 | 16 路 1080P | 15W |
爱芯元智 AXClaw Box(帝王虾盒) | AX8850 | 24 TOPS | 约 3500 元 | 16 路 1080P | 10W 级 |
爱芯元智 AX650N 方案 | AX650N | 18 TOPS(INT8)/ 72 TOPS(INT4) | 约 4000 元 | 多路高清 | 12W 级 |
算能 EC-A1688JD4 | 16 TOPS | 约 2700 元 | 16 路 1080P | 8-15W | |
NVIDIA Jetson Orin Nano 8GB | Orin Nano | 40 TOPS | 约 6500 元 | 多路 1080P | 7-15W |
算能 EC-A186JD4 | 7.2 TOPS | 约 2300 元 | 8 路 1080P | 5-10W | |
RK3588 | 6 TOPS | 约 1900 元 | 8 路 1080P | 8-15W | |
RV1126 | 2 TOPS | 约 800 元 | 4 路 1080P | 3-5W |
1.1 梯队划分
第一梯队(30 TOPS+):高性能边缘推理
以 NVIDIA Jetson AGX Orin 和算能 BM1684X 为代表,适合多路视频分析、工业质检、大模型边缘部署等高算力需求场景。其中 BM1684X 在 32 路视频并发分析场景下性价比突出,是国产高算力边缘盒的标杆产品。
第二梯队(10-30 TOPS):主流工业级
覆盖爱芯元智 AX8850、算能 BM1688 等国产主力方案,以及 Jetson Orin Nano。这一梯队是当前项目落地最集中的价位段,兼顾算力、功耗与成本,适合智慧安防、园区管理、通用工业检测等场景。
第三梯队(10 TOPS 以下):轻量终端与成本敏感型
以瑞芯微 RK3588、RV1126 和算能 CV186AH 为代表,主打低功耗、低成本,适合单路或少量路数视觉分析、传感器数据处理、简单 AI 推理等场景。
2. 性价比深度解析
算力标称值仅为参考,真实性价比需要结合有效算力、视频路数、生态成熟度、工业可靠性四个维度综合评估。
2.1 算力成本比(TOPS/元)
产品 | 算力成本比(INT8 TOPS/百元) | 备注 |
算能 BM1688 | 0.59 | 国产中端性价比之王 |
算能 BM1684X | 0.70 | 高算力段性价比领先 |
瑞芯微 RK3588 | 0.32 | 通用计算 + AI 兼顾 |
NVIDIA Orin NX | 0.95 | 生态溢价高但有效算力强 |
爱芯元智 AX8850 | 0.69 | 带 AI-ISP 协同优化 |
核心结论:纯算力数字对比下,国产方案在中低价位段具备明显成本优势;NVIDIA 方案虽然单价高,但 CUDA 生态成熟,实际有效算力和模型适配度更优,适合算法团队自研场景。
1.2 能效比(TOPS/W)
工业现场供电与散热条件有限,能效比直接决定 7×24 小时运行稳定性。
爱芯元智 AX 系列:自研 NPU + AI-ISP 协同,能效比约 2-2.5 TOPS/W,在低功耗场景优势明显
算能 BM 系列:能效比约 1.2-1.5 TOPS/W,视频解码与算力均衡
NVIDIA Orin 系列:能效比约 2-3 TOPS/W,高端制程带来能效优势
瑞芯微 RK3588:能效比约 0.4-0.6 TOPS/W,主打通用计算而非纯 AI 算力
1.3 隐藏成本:生态与适配
算力之外,工具链成熟度和算法迁移成本是更大的隐性支出:
NVIDIA:CUDA 生态最完善,开源模型几乎开箱即用,迁移成本最低,但授权和硬件成本高
算能:BMNet 工具链持续迭代,支持主流框架,安防视频分析场景适配成熟,国产化项目首选
爱芯元智:Pulsar2 工具链原生支持 DeepSeek、Qwen 等国产大模型,AI-ISP 与 NPU 同芯片协同,成像 + 推理一体化优势显著
瑞芯微:RKNN 工具链社区资源丰富,通用外设接口多,适合混合业务场景
1.4 工业可靠性差异
真正的边缘计算盒子不是"开发板加外壳",宽温、防尘、无风扇、长时间稳定运行是硬指标:
工业级机型通常支持 -40℃~60℃ 宽温、IP40 以上防护
算能 SE7 微服务器、研华 UBOX 系列等通过严格工业认证,适合户外、机柜等严苛环境
消费级/开发板级产品价格低,但长期运行故障率高,不建议商用项目批量部署
2. 分场景选型指南
2.1 智慧安防:多路视频分析
首选:算能 BM1684X 方案(32 路视频解码 + 32 TOPS 算力)
理由:单盒可处理 32 路 1080P 视频结构化,路数成本最低,国产信创适配完善,适合平安城市、园区安防等大规模部署。
2.2 工业质检:高精度视觉检测
首选:NVIDIA Jetson Orin NX / 爱芯元智 AX8910 方案
理由:工业检测对算法精度要求高,需要灵活调优模型,Orin 生态最成熟;爱芯元智方案在成像质量上有 AI-ISP 加成,适合缺陷检测等对画质敏感场景。
2.3 成本敏感型项目:多路轻量分析
首选:算能 BM1688 / 瑞芯微 RK3588
理由:2000-3000 元价位,满足 8-16 路基础算法(安全帽、烟火、人员聚集等),性价比突出,适合下沉市场和中小项目。
2.4 大模型边缘部署:本地 Agent 与私有化
首选:NVIDIA Jetson AGX Orin / 爱芯元智 AX650N
理由:运行 7B-14B 参数大模型需要更大显存和更高算力,AGX Orin 32GB 版本可流畅运行 7B 模型;AX650N INT4 算力达 72 TOPS,在量化大模型推理上有优势。
3. 趋势总结
2026 年边缘计算盒子市场正呈现"两头挤压中间升级"的格局:低端被更高集成度的 IPC 和智能相机蚕食,高端向边缘服务器和微服务器形态升级,中端则在算力翻倍的同时价格持续下探。
SC26 预计将进一步验证两大趋势:一是光电混合计算开始向边缘侧渗透,光互连技术提升多盒集群带宽;二是端侧大模型成为标配,7B 模型边缘运行将成为中高端盒子的及格线。对于选型者而言,不必盲目追求最高算力,匹配场景路数、算法精度要求和长期运维成本,才是性价比的真正内涵。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部