


目前公开渠道暂无 CV186AH 部署 YOLO12 的完整第三方实测横评。以下数据基于算能官方同平台 YOLOv8 基准性能、YOLO12 模型计算量特性、多路业务实测数据以及官方功耗参数综合整理,可作为落地部署的核心参考。
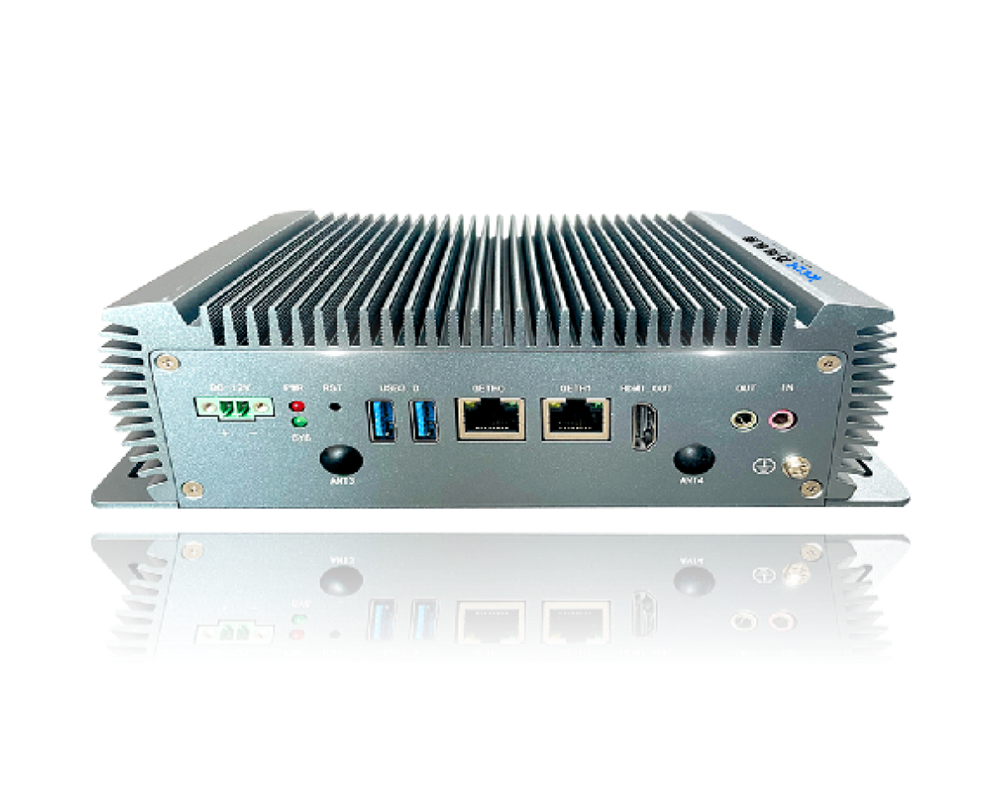
一、核心硬件基础规格
CV186AH 是算能面向边缘视觉场景的高集成度 AI 处理器,核心参数如下:
TPU 峰值算力:7.2 TOPS INT8、12 TOPS INT4、1.5 TFLOPS FP16/BF16
CPU:六核 ARM Cortex-A53 @ 1.6GHz
视频编解码:16 路 1080P@30fps 硬解码、10 路 1080P@30fps 硬编码
官方标称能力:最大支持 8 路 1080P 全高清视频全流程智能分析(解码 + 推理 + 后处理)
二、单路推理帧率参考
输入分辨率 640×640,INT8 量化。
2.1 纯 TPU 推理(仅模型计算,无前后处理/解码)
基于算能官方 CV186X 同算力平台的 YOLOv8 实测基准,结合 YOLO12 的 FLOPs 特性推算:
模型 | 单图推理耗时 | 对应帧率 | 备注 |
YOLOv8s(官方实测) | ~5.2 ms | ~192 FPS | 算能官方工具链基准数据 |
YOLO12-n(推算) | ~1.4~1.8 ms | 550~700 FPS | FLOPs 约 7.5G,小于 YOLOv8n |
YOLO12-s(推算) | ~4.5~5.5 ms | 180~220 FPS | FLOPs 约 23.3G,略低于 YOLOv8s |
纯推理帧率为 TPU 峰值算力下的理论/基准值,实际业务中因视频解码、图像预处理、NMS 后处理、CPU 调度开销,帧率会显著下降。
2.2 端到端推理(1080P 视频流)
包含解码 + 缩放 + 预处理 + 后处理,为实际业务场景的真实帧率,也是多路部署的核心参考:
YOLO12-n:单路端到端帧率约 60~90 FPS,CPU 负载约 20%~30%
YOLO12-s:单路端到端帧率约 25~40 FPS,可满足单路实时需求
若启用 INT4 量化,帧率可再提升 30%~50%,但 mAP 会有 2%~4% 的精度损失
三、多路并发推理真实帧率
1080P 视频流,YOLO12-n INT8。结合官方多路能力与第三方业务实测数据,典型路数下的性能表现如下:
并发路数 | 单路平均帧率 | TPU 整体负载 | 说明 |
4 路 | 25~30 FPS | 55%~65% | 完全满足实时监控需求,余量充足 |
8 路 | 12~15 FPS | 85%~95% | 达到官方标称的 8 路智能分析上限 |
16 路 | 5~7 FPS | 接近满载 | 受解码带宽与调度开销限制,非算力瓶颈 |
第三方双任务实测参考:8 路 1080P 同时运行人体检测 + 安全帽分类双模型时,单路平均帧率约 5 FPS,可作为多模型叠加场景的性能参照。
四、真实功耗数据
不同产品形态下的功耗差异较大,核心数据如下:
4.1 核心板(仅 SoC + 内存核心模块)
待机轻载:3~4W
典型 8 路推理负载:约 5.5W
峰值满负载:最高 7.5W(5V 供电)
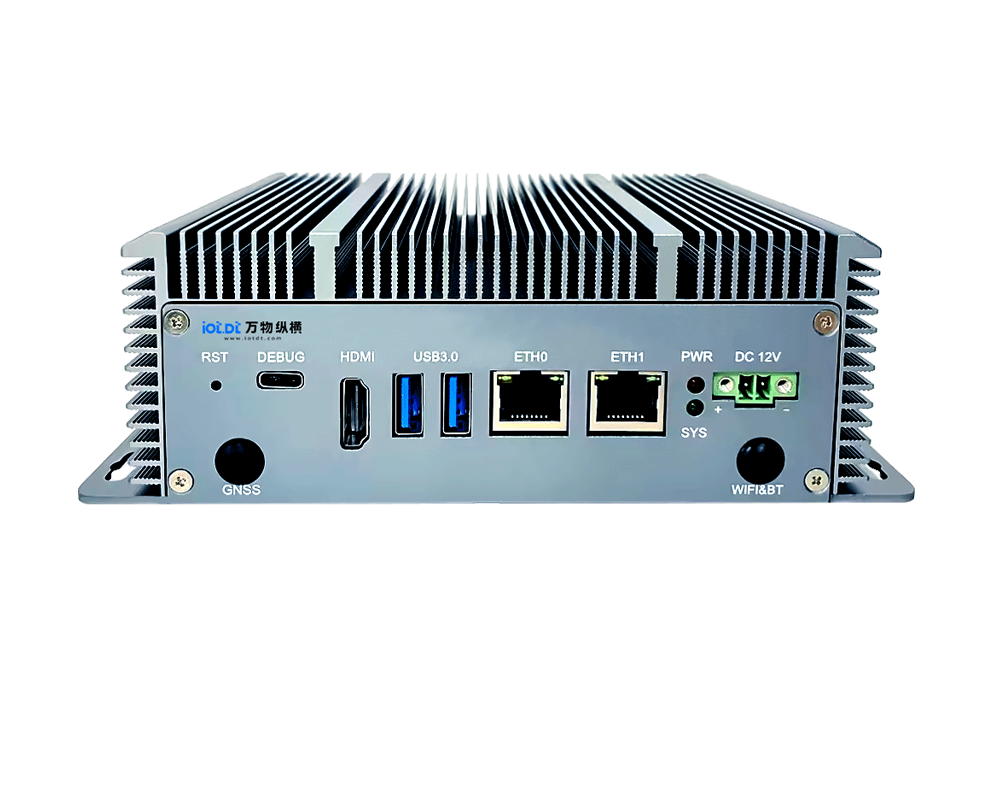
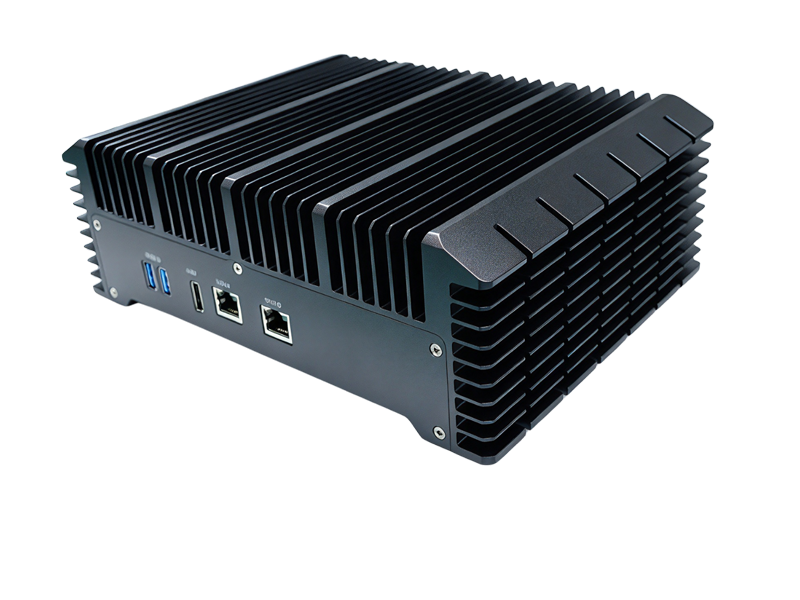
4.2 无风扇整机(含接口、存储、外设,如 EC-A186JD4)
待机:5~6W
典型 AI 推理负载:约 8.5W
满负载(全接口 + TPU 满载):最高 14W(12V 供电)
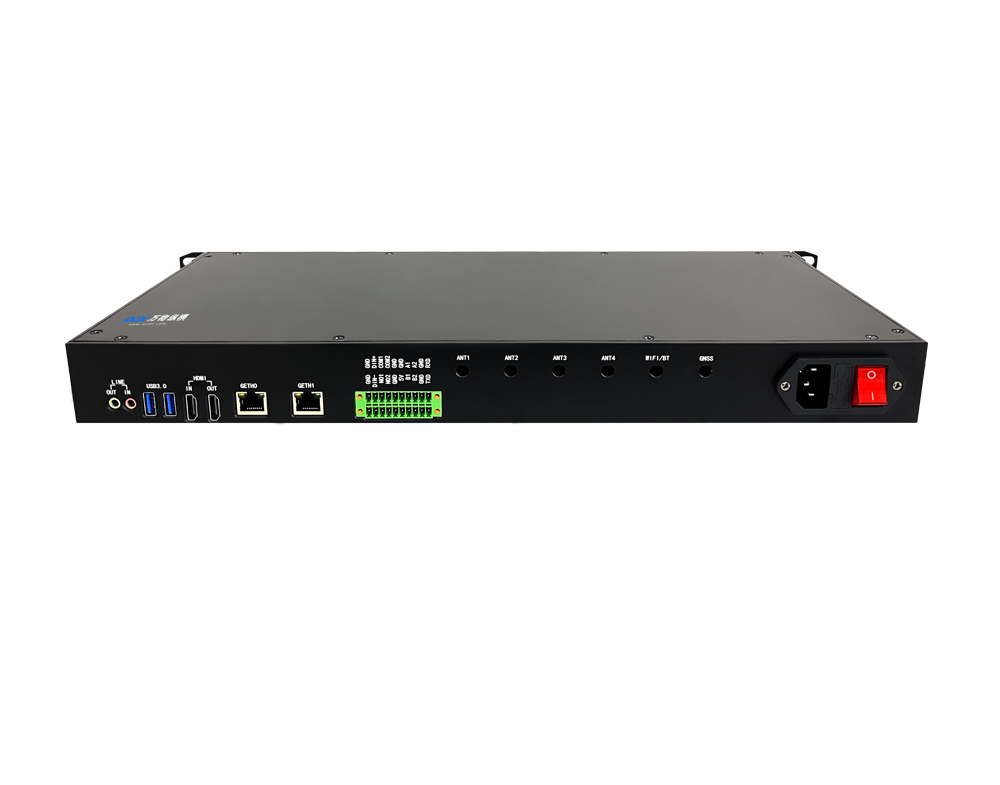
4.3 标准整机(算能官方 SE9 微服务器)
典型工作功耗:约 12.5W
五、性能优化关键提示
1. 输入分辨率从 640×640 降至 384×640,可减少约 30% 计算量,帧率提升明显,适合 1080P 宽屏视频场景。
2. 使用算能 TPU-MLIR 工具链进行 INT8 量化与算子融合,可最大化发挥 TPU 效率,比通用 ONNX 推理性能高 40% 以上。
3. 多路场景下采用批量推理(Batch=2~4),可提升 TPU 利用率,总吞吐量提升 15%~25%。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部