在人工智能向多模态、本地化、工业化深度演进的当下,视觉大模型的训练与推理正从云端中心走向边缘终端。视觉大模型训推一体机凭借本地部署、低延迟、高安全、易扩展等核心
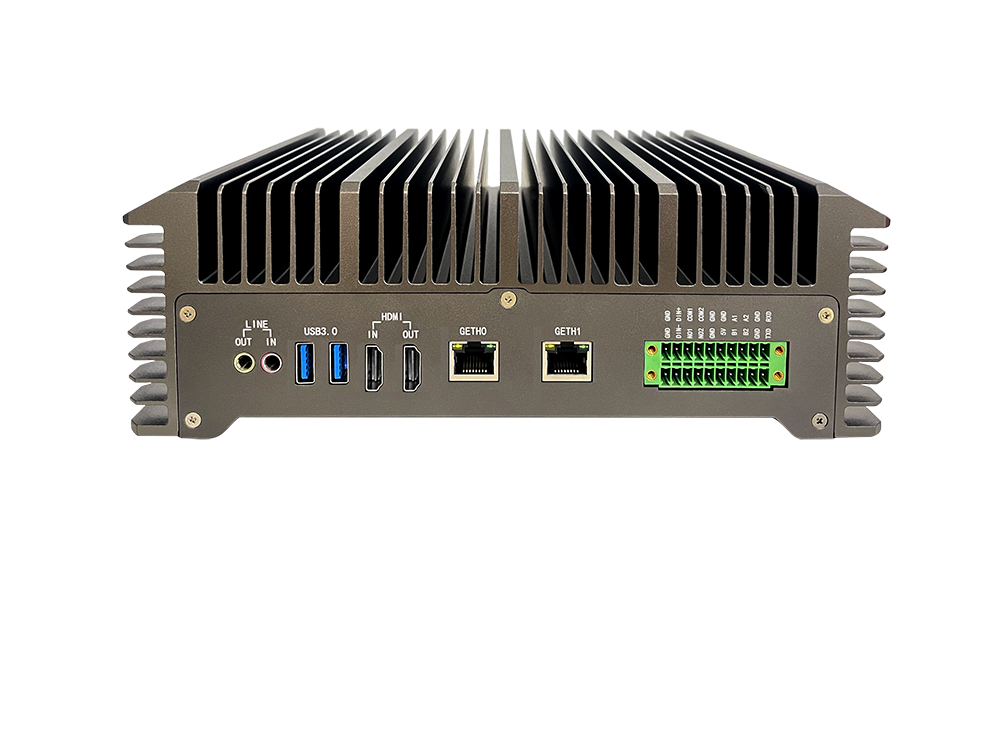
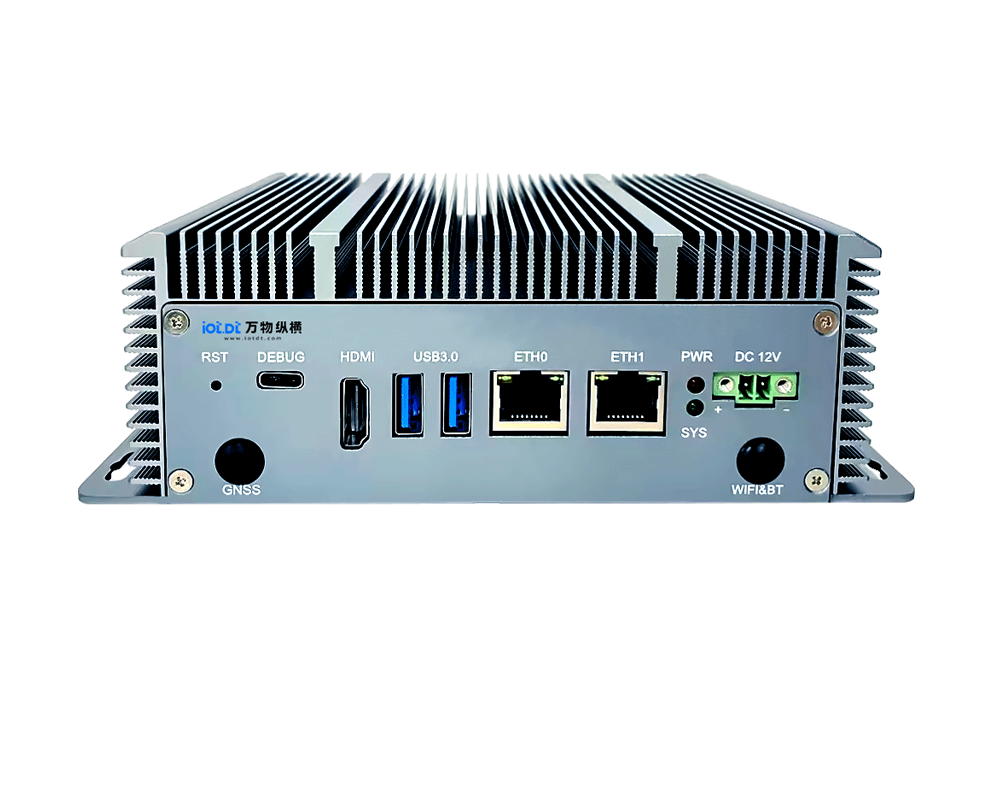
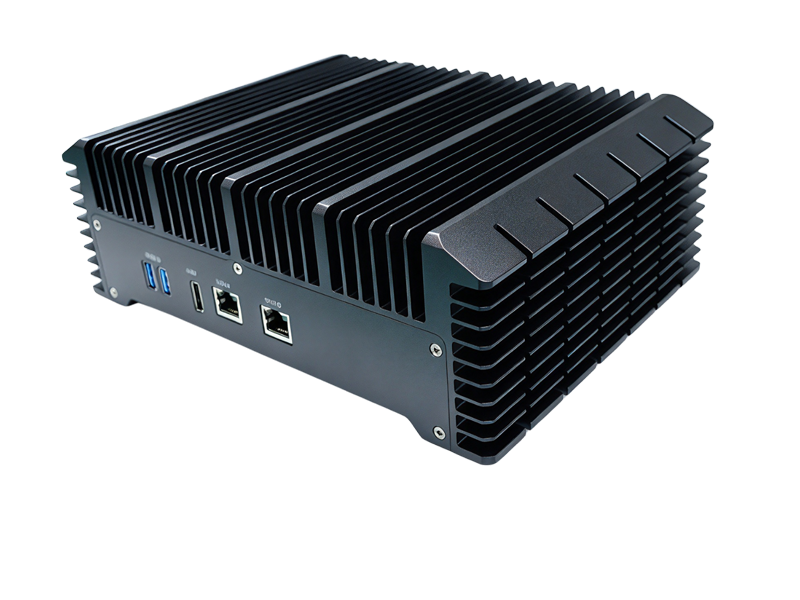
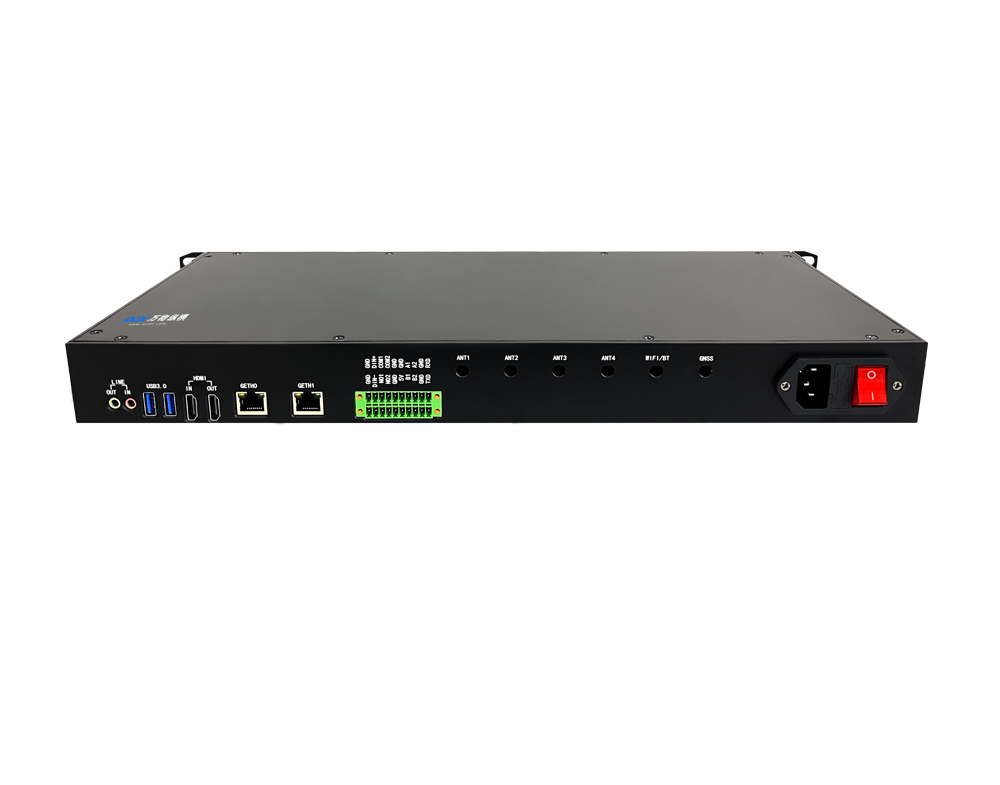
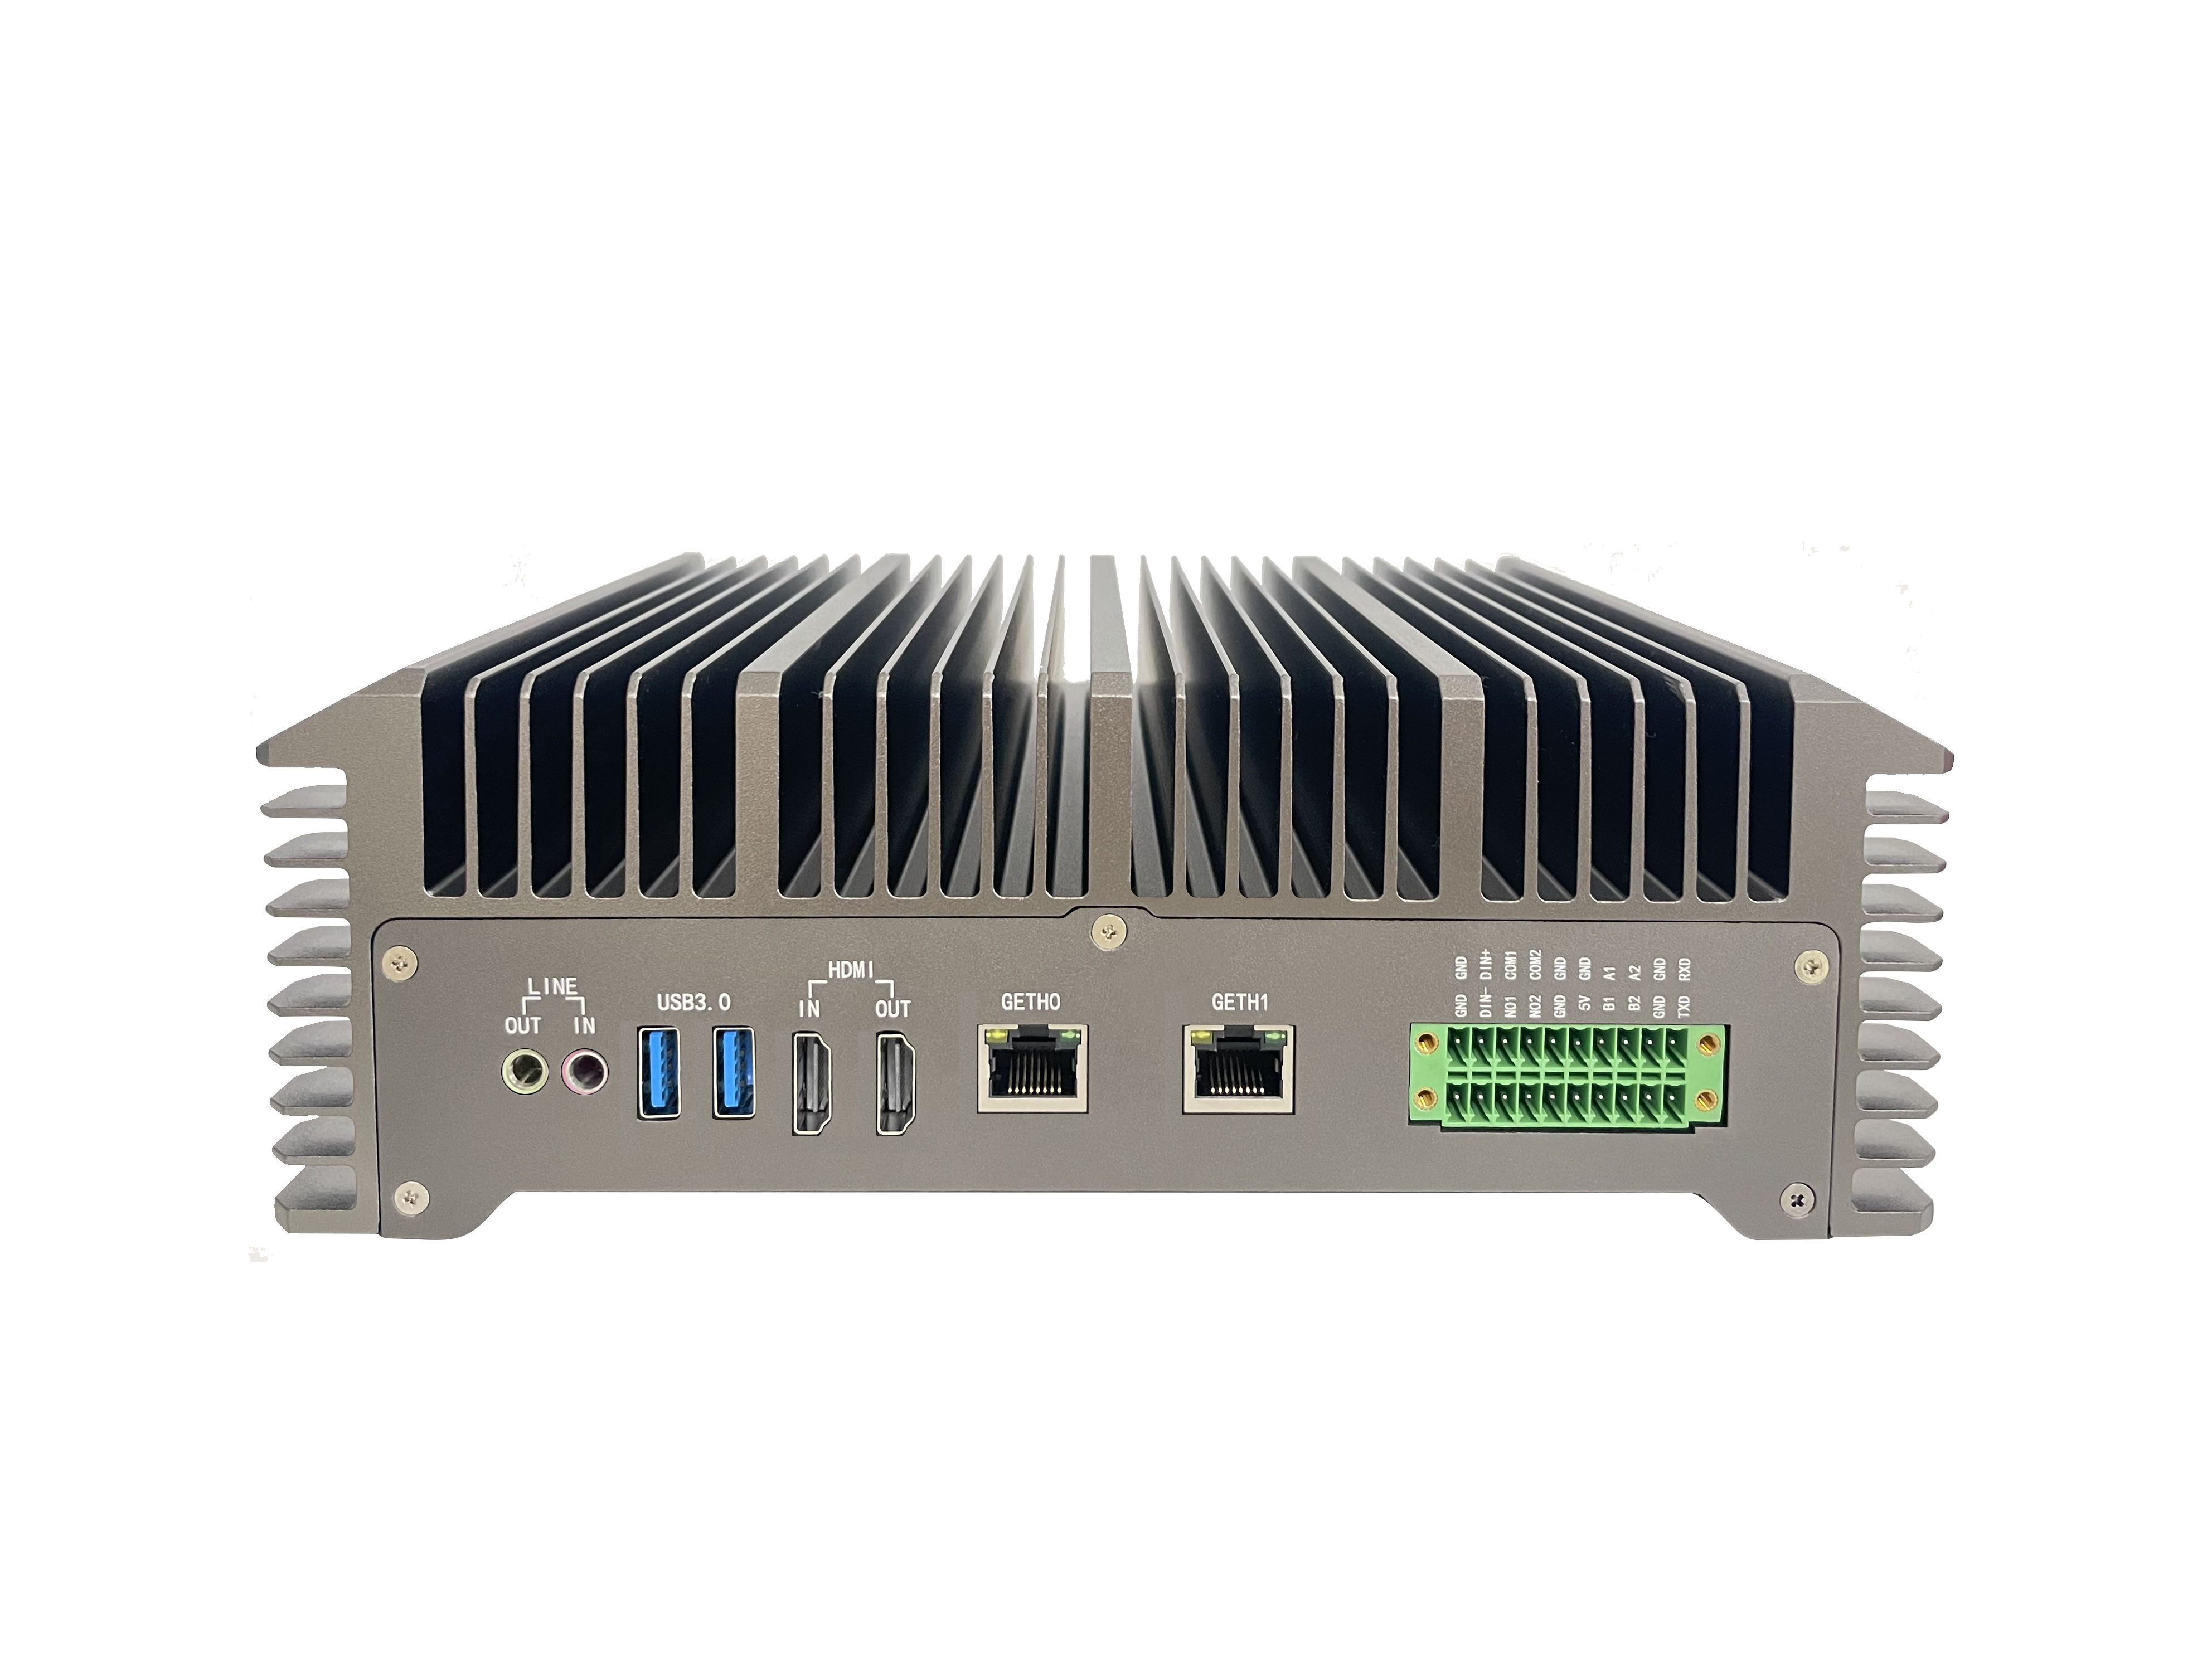
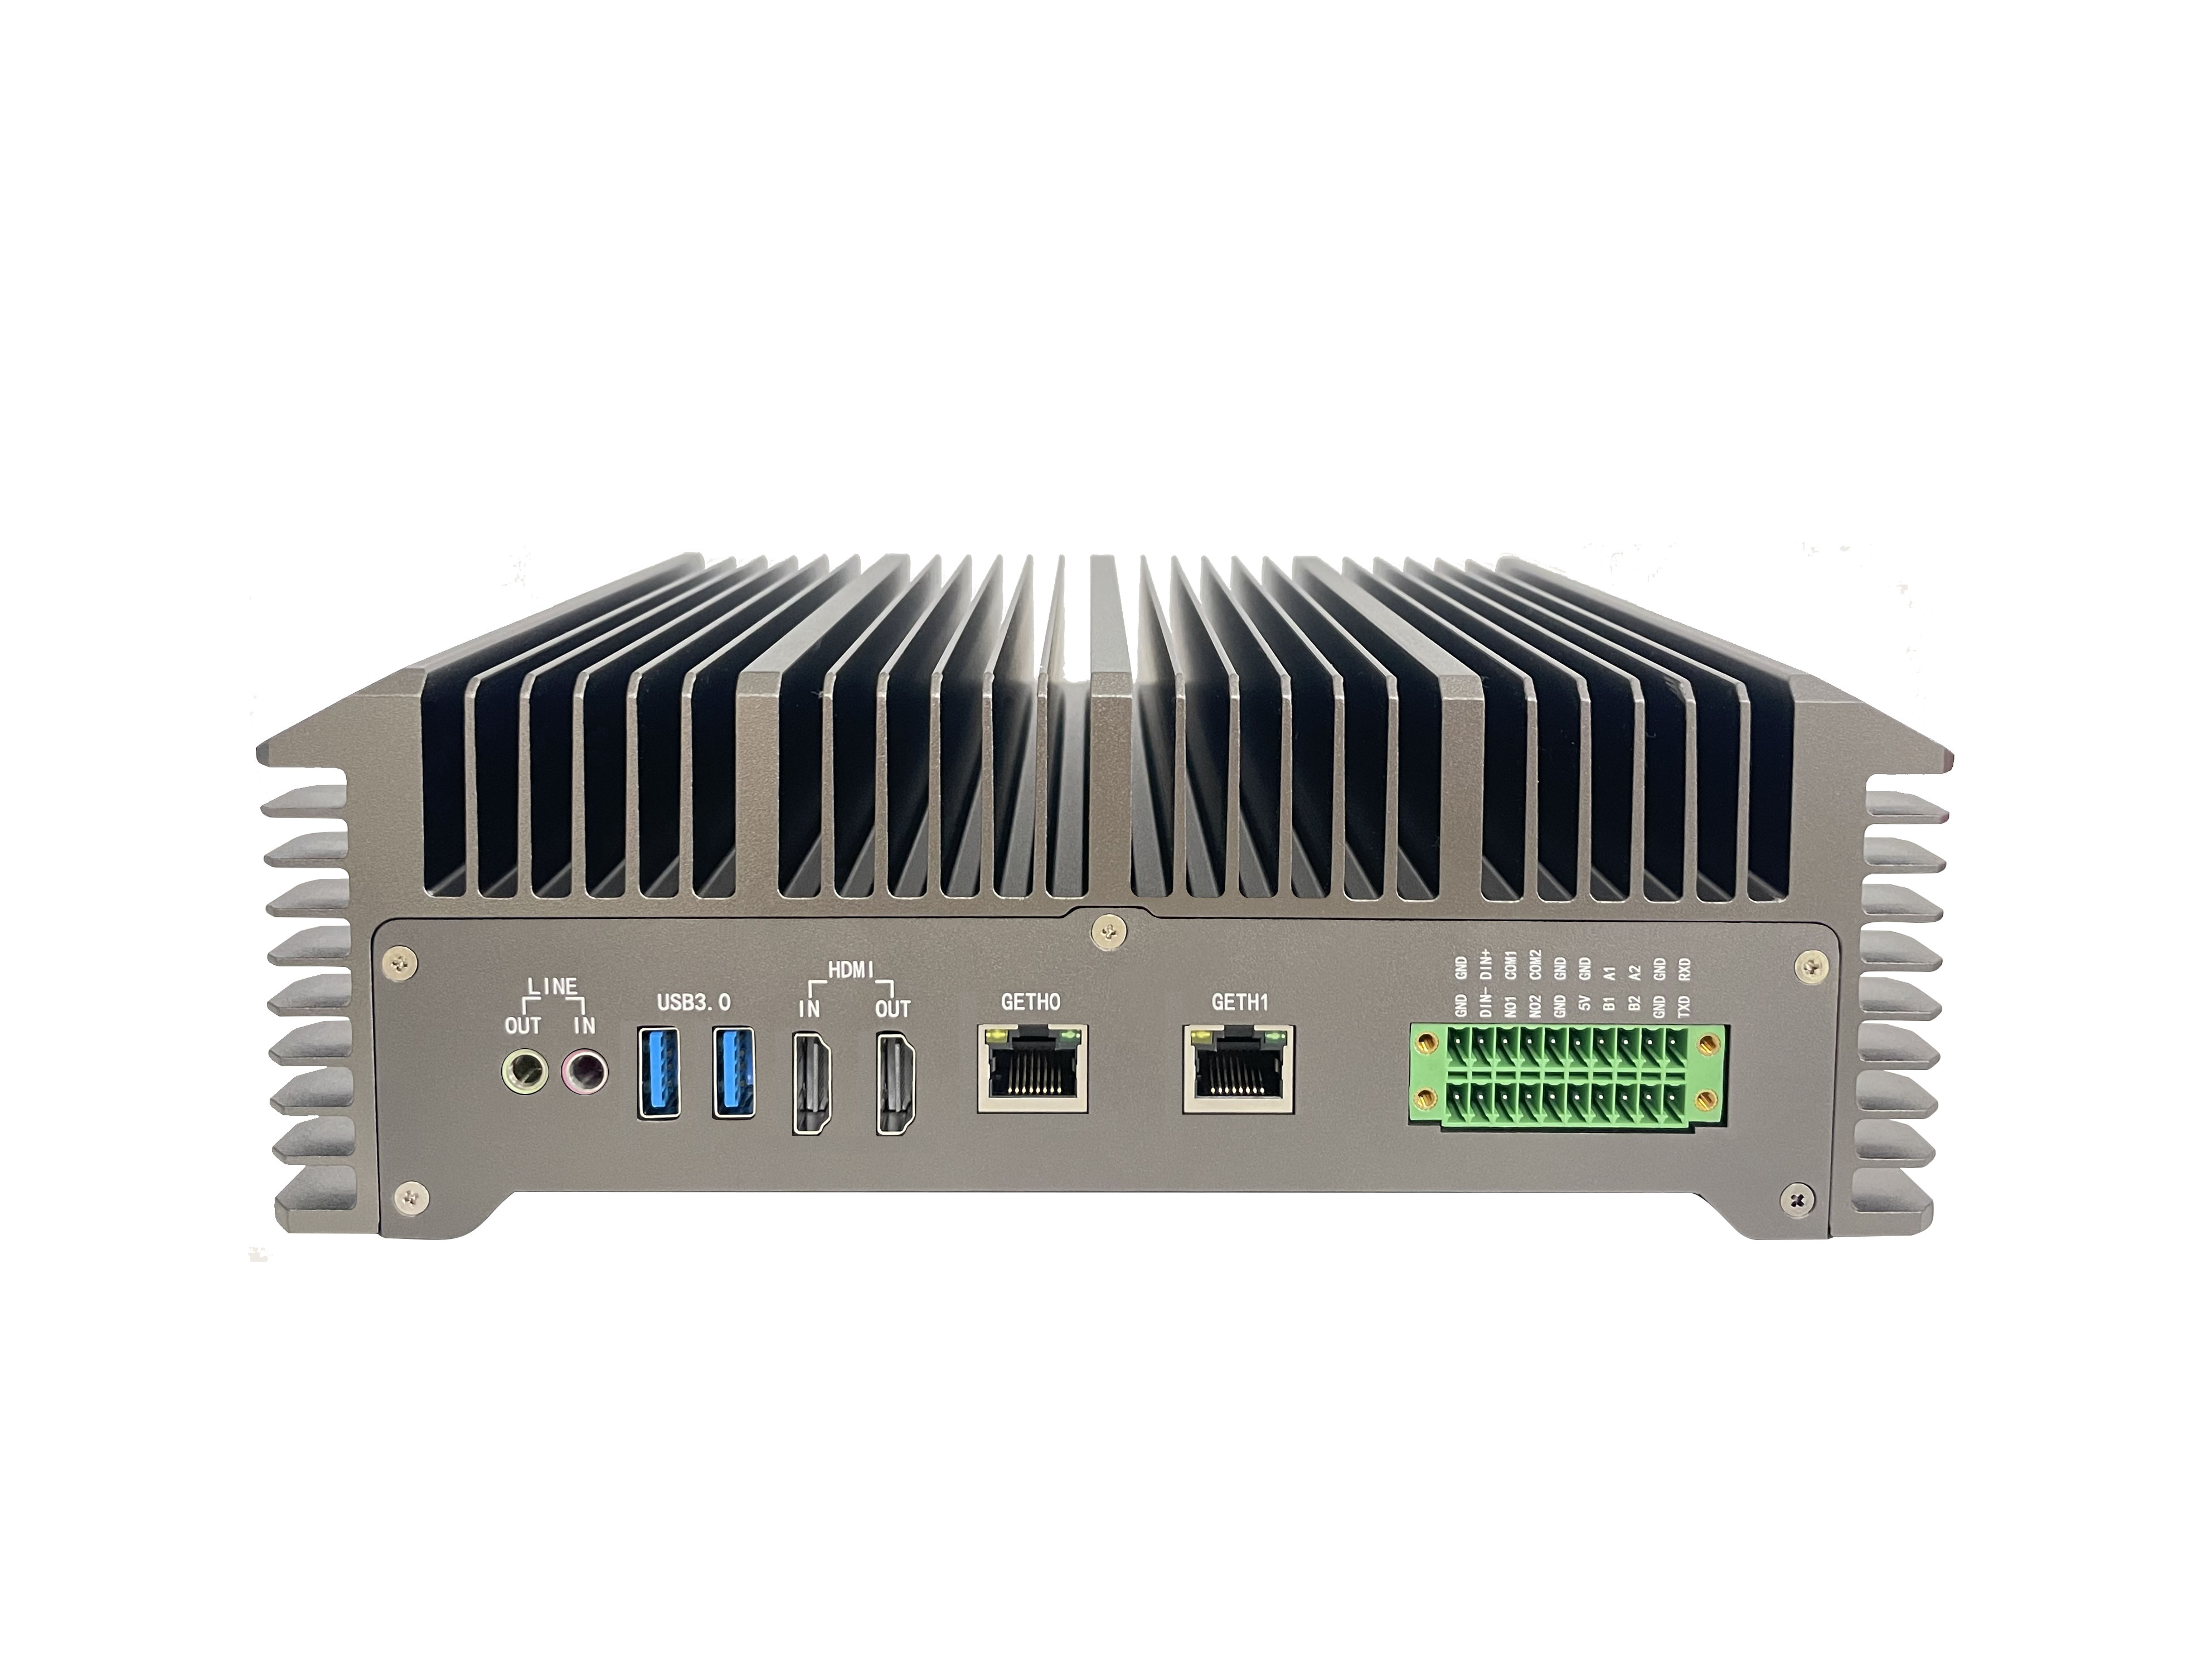
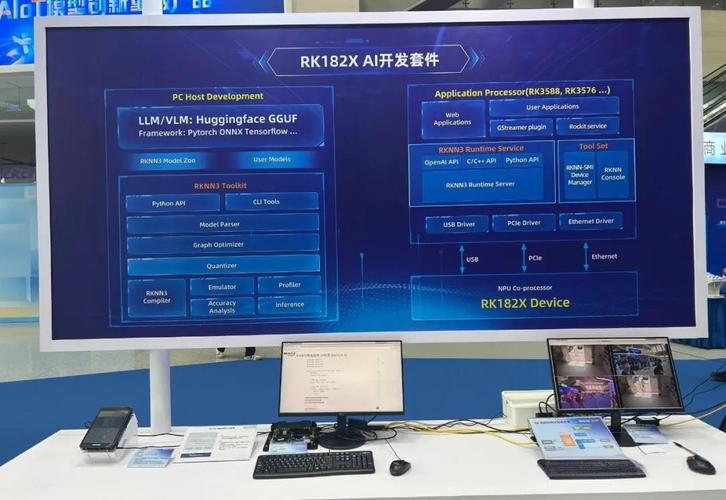
瑞芯微RK3588大模型一体机凭借6TOPS NPU算力+异构计算架构+成熟RKLLM工具链,可全兼容运行Qwen、ChatGLM、Llama2等主流开源大模型
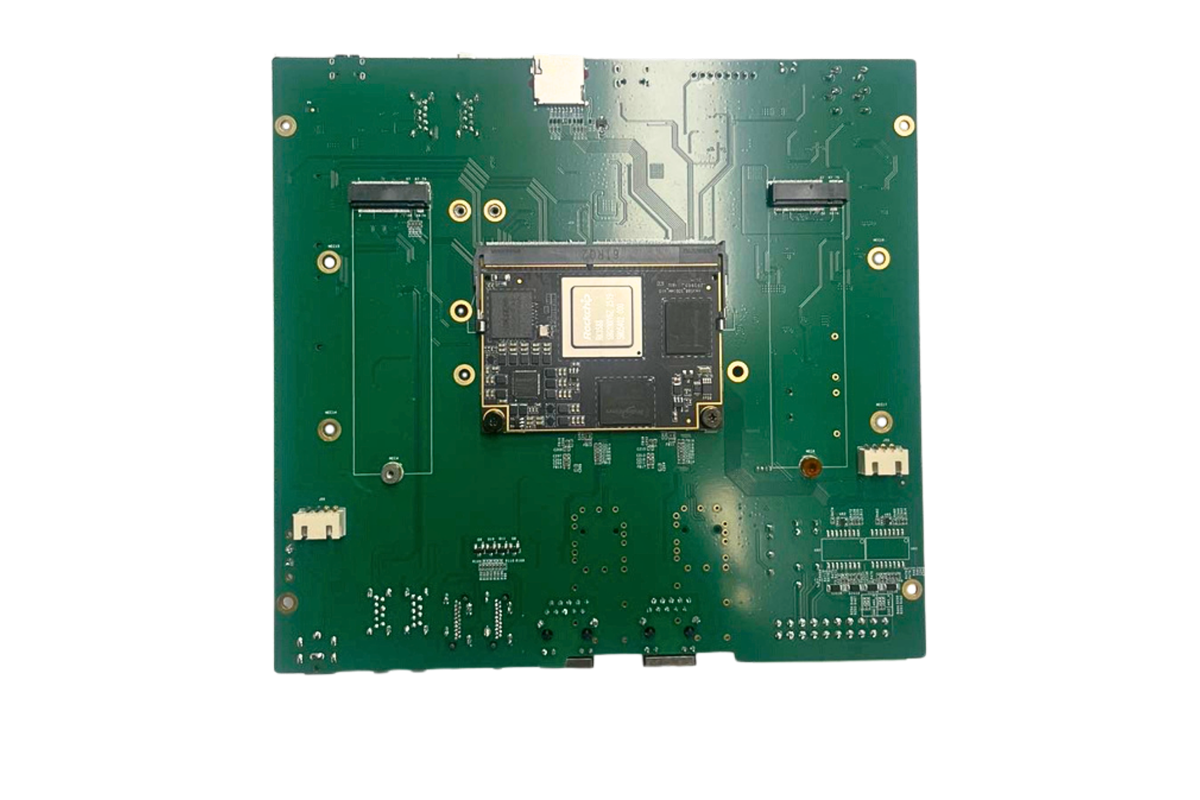
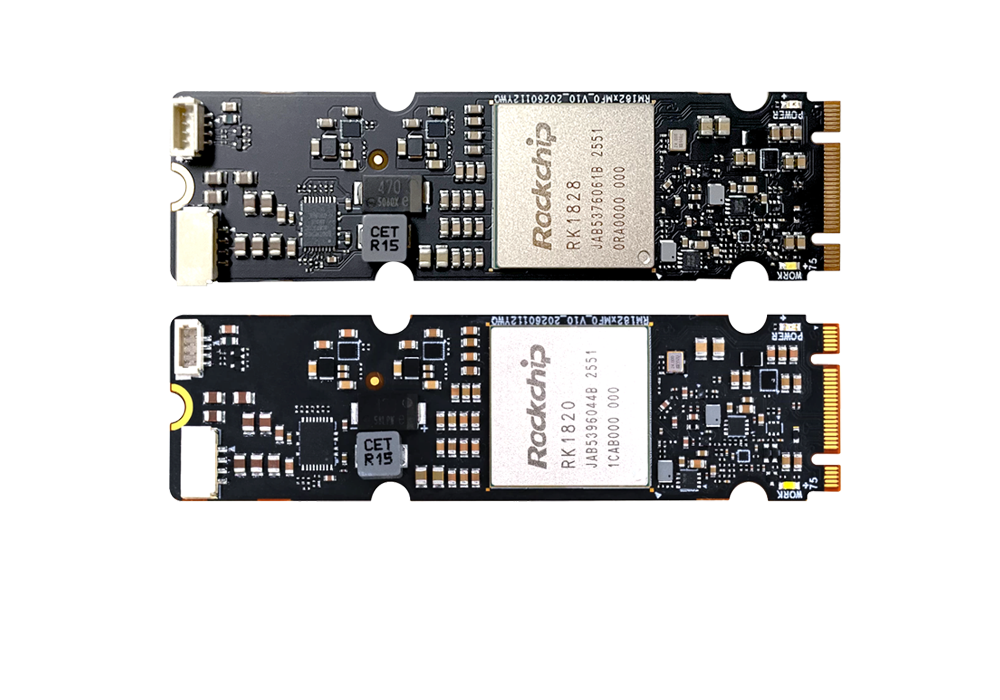
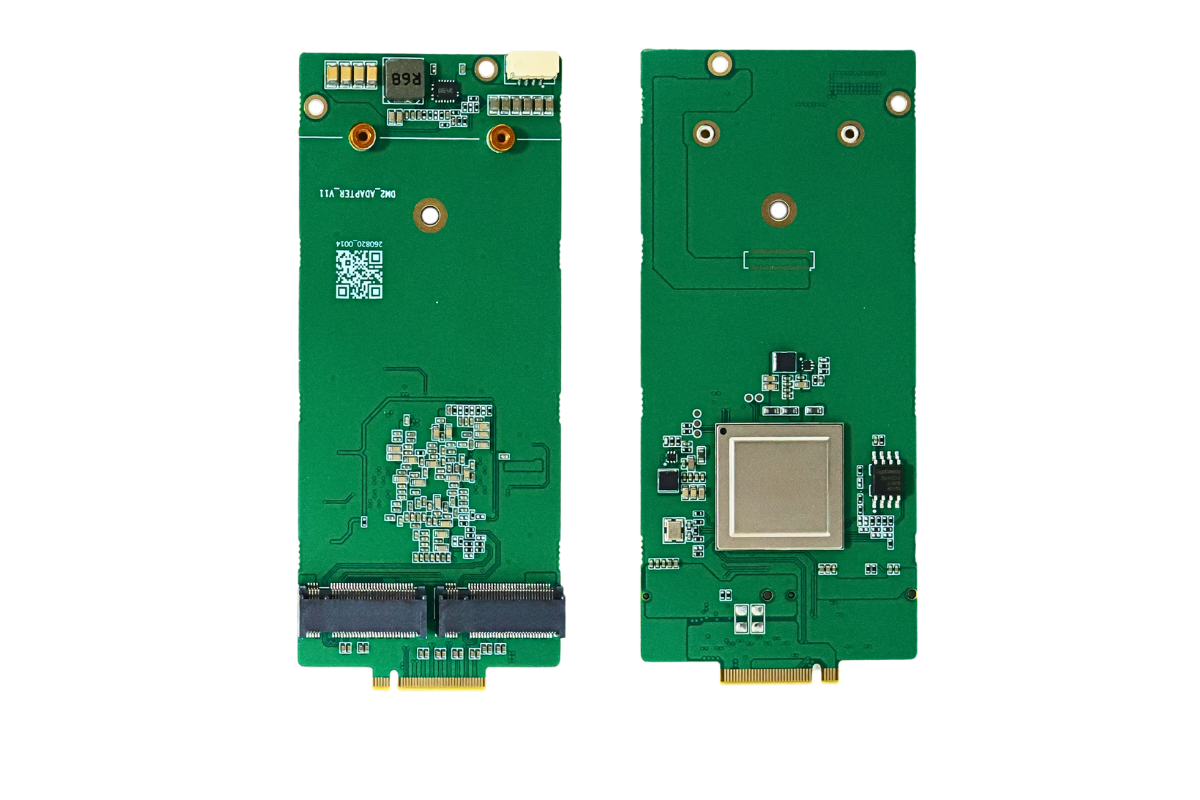
瑞芯微RK3588大模型一体机凭借双M.2扩展,实现了算力与存储的按需灵活升级,完美解决原生6TOPS NPU在运行8B+参数大模型时的算力与带宽瓶颈,是本地化
瑞芯微RK3588大模型一体机,以6TOPS原生NPU+PCIe扩展至160TOPS的组合,成为边缘侧部署大模型的高性价比、高扩展标杆方案。一、核心算力架构:6
瑞芯微RK3588大模型一体机,本地可稳定跑通7B级大模型,13B级可勉强运行,30B级受硬件限制无法本地部署。以下从硬件能力、部署方案、性能与限制、一体机选型
当AI大模型向边缘端下沉,全国产化AI大模型一体机 凭借算力自主、数据安全、场景适配的核心优势,成为市场新宠。相较于海外方案,国产一体机不仅解决了“卡脖子”问题
*










 试用申请
 产品咨询
 在线客服
 回到顶部