M.2 2280 凭借标准化尺寸、M-Key PCIe 4.04 接口、低功耗、易插拔扩容的优势,正在成为边缘 AI 硬件的主流形态。国产 M.2 算力卡的发展
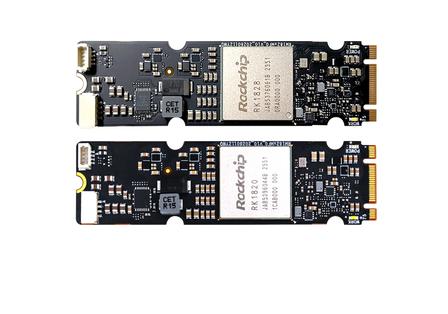
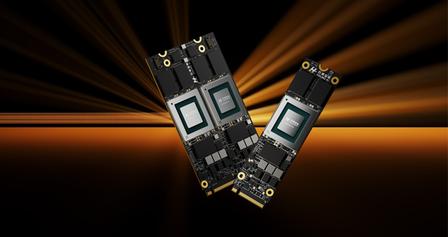
M.2 2280(宽 22mm、长 80mm)依托成熟 PCIe 总线、标准化机械结构,已经成为国产边缘 AI 算力卡的主流硬件形态,算能、瑞芯微、寒武纪、爱芯
大模型推理瓶颈大多不是纸面 TOPS,而是板载内存、内存带宽、量化支持、软件栈、PCIe 接口、功耗散热,M.2 形态体积受限,坑点比标准 PCIe 大卡更多。
M.2 算力卡的多卡级联无法实现严格的算力线性叠加(1+1=2),仅在特定的边缘推理场景下接近线性,多数场景下实际性能提升幅度显著低于理论标称值。厂商宣传的 “
核心本质:SoM 是完整的嵌入式主机单元;M.2 算力卡只是 PCIe 外接 AI 加速外设,本身不能独立跑系统。一、核心差异对比表对比项 M.2 AI 算力卡
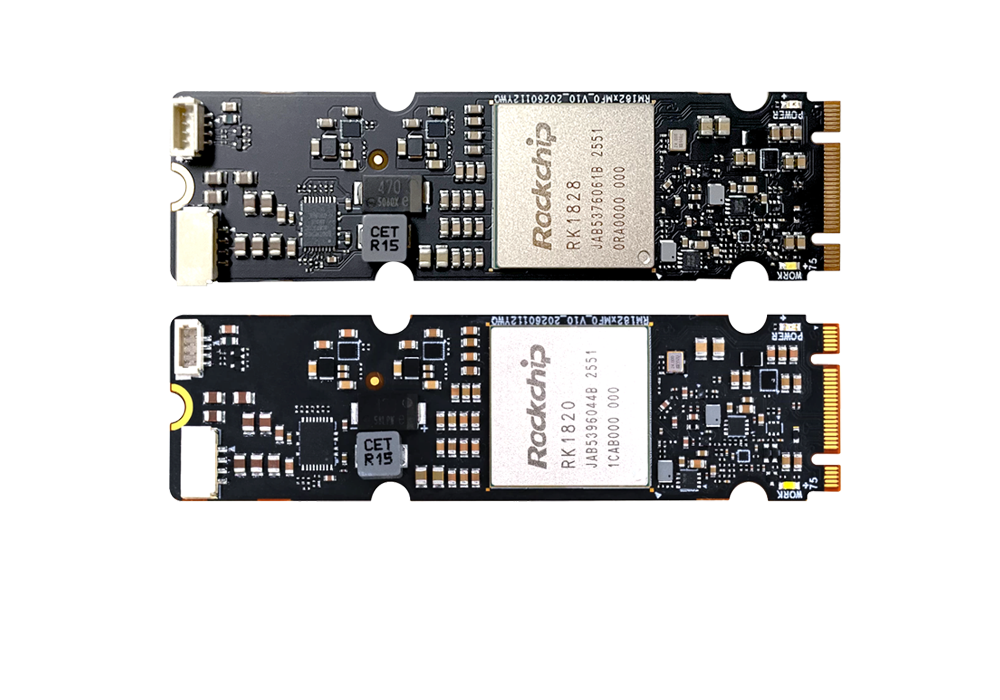
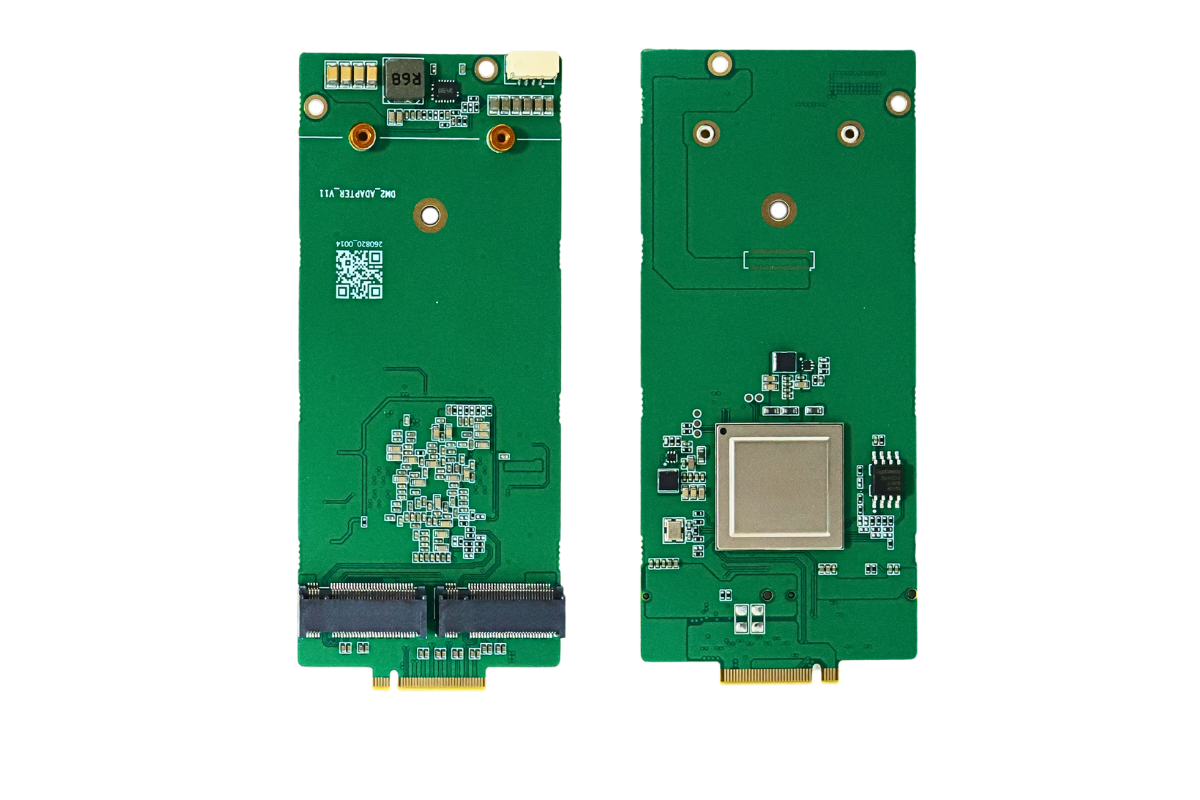
随着边缘 AI 项目规模化落地,算能 BM1684X、瑞芯微 RK1828、力擎 LQ50 系列等多款国产 M.2 形态 PCIe 算力卡,已完成完整 Dock
*










 试用申请
 产品咨询
 在线客服
 回到顶部