
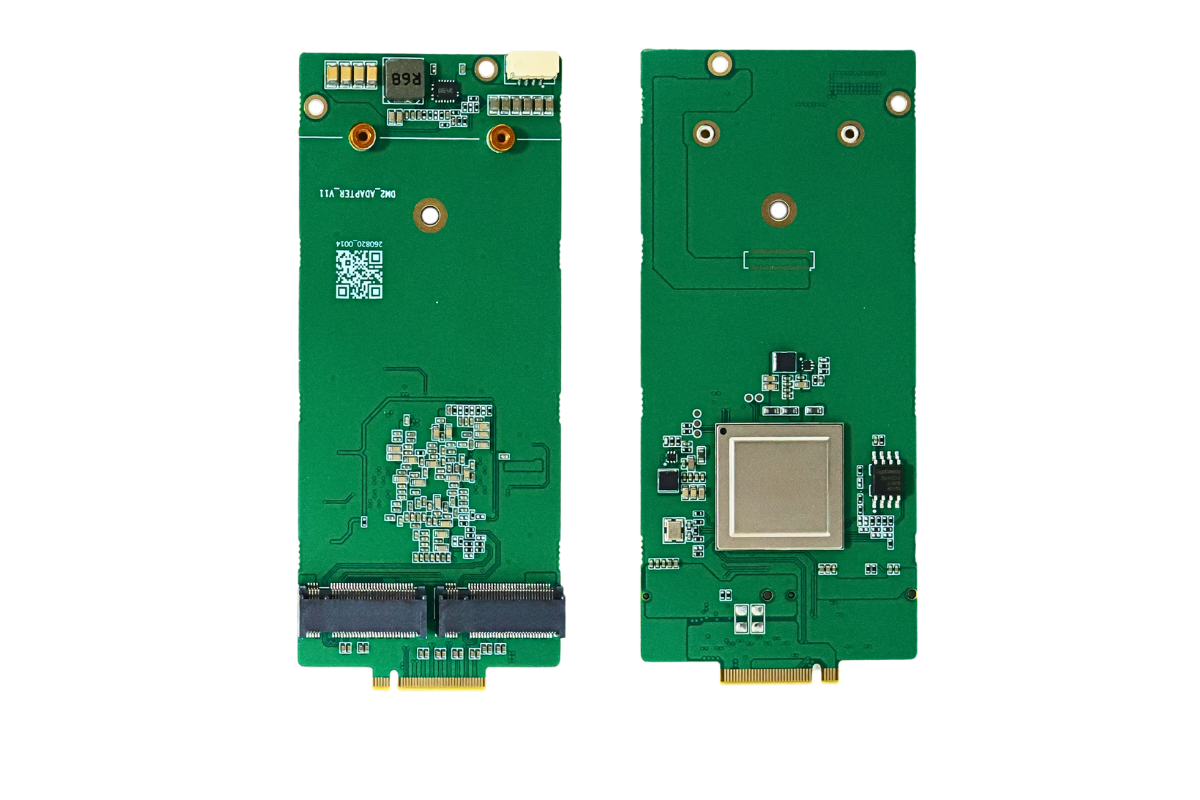


算能正式开源面向 BM1684X M.2 PCIe 算力卡 的 OpenVINO Device Plugin,打通 OpenVINO 推理框架与算能 TPU 硬件的调用链路。开发者可直接使用 OpenVINO 标准 API,将模型推理卸载到 BM1684X M.2 卡,不再强制依赖原生 SophonSDK 完整开发栈,大幅降低跨平台、多硬件混合部署的迁移成本,补齐国产 M.2 AI 算力卡在 OpenVINO 生态的短板。
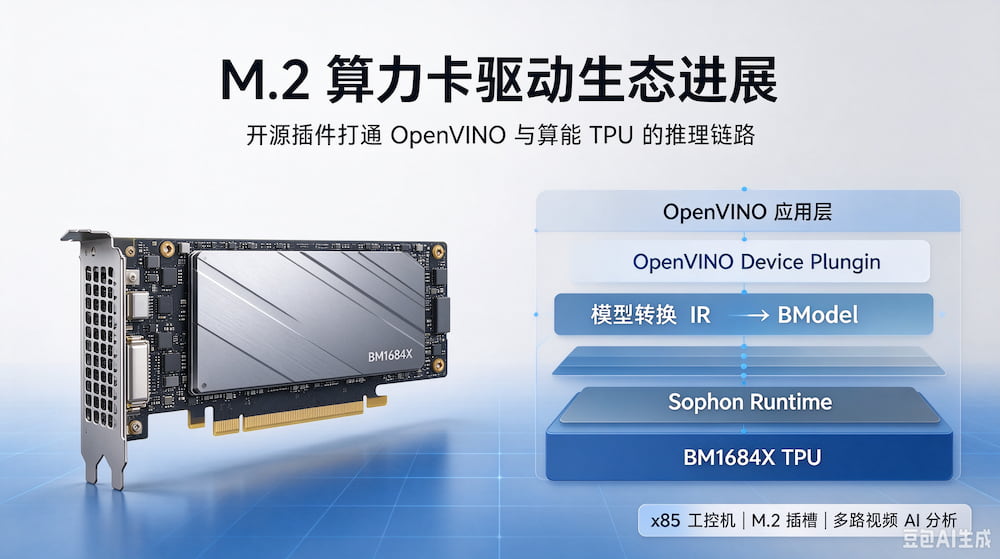
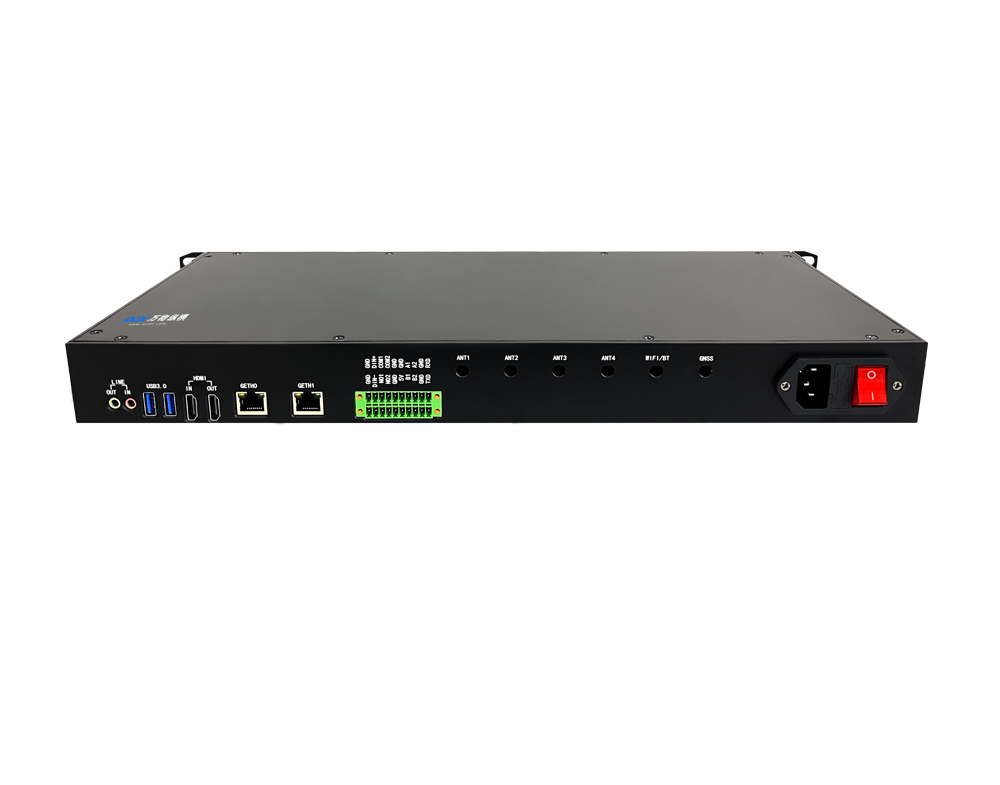
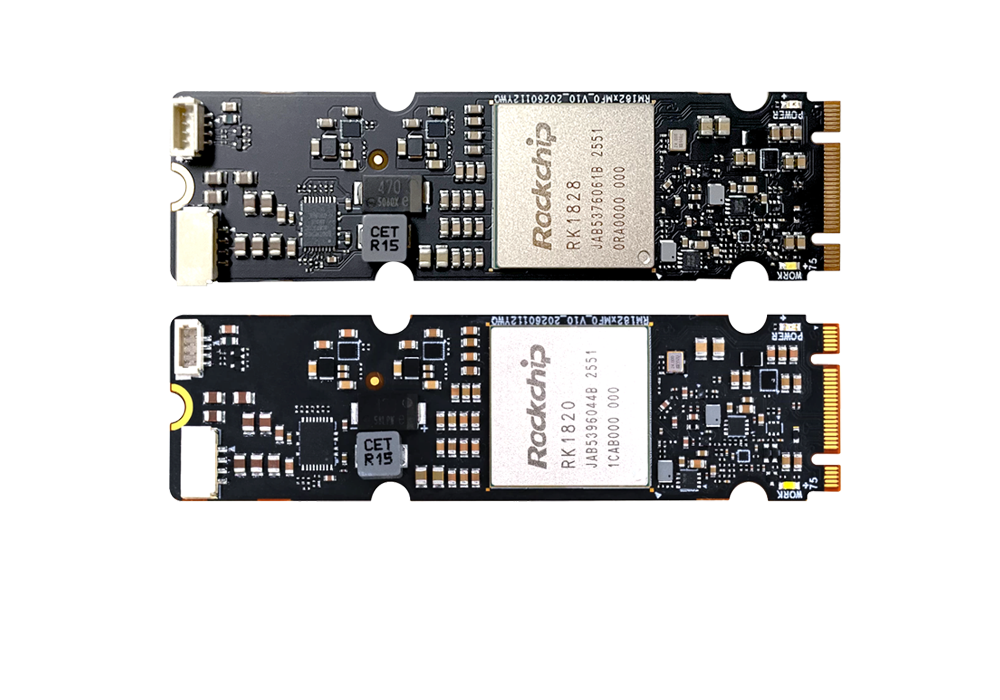
硬件背景:BM1684X M.2 为 PCIe M.2 2280 形态边缘算力卡,INT8 算力 32TOPS,支持 32 路 1080P 硬解码,功耗约 16W,可直接插 PC / 工控机 M.2 插槽,主打明厨亮灶、智慧工地、光伏巡检等多路视频 AI 分析场景。
插件原理
OpenVINO 采用插件化设备架构,新增的 sophon 插件作为 OpenVINO 后端:
1. OpenVINO IR 模型经过插件层,转换为算能 TPU 可识别的 BModel;
2. 底层调用 Sophon Runtime 驱动,调度 BM1684X M.2 硬件完成推理;
3. 保留 OpenVINO 原有 API、异步推理、Batch 调度、AUTO 多硬件自动选卡等能力;
4. 支持在同一套代码里混合调度:CPU+BM1684X M.2、多片 BM1684X M.2 并联推理。
关键价值
1. 降低算法迁移成本
原有方案:算法基于 OpenVINO 开发,部署到 BM1684X 需要重写推理代码、模型转 BModel,学习 SophonSDK;
新方案:一套 OpenVINO 代码,CPU/NPU/BM1684X M.2 多硬件直接切换,算法工程师无需深度熟悉算能原生 SDK。
2. 拓宽 BM1684X M.2 算力卡落地场景
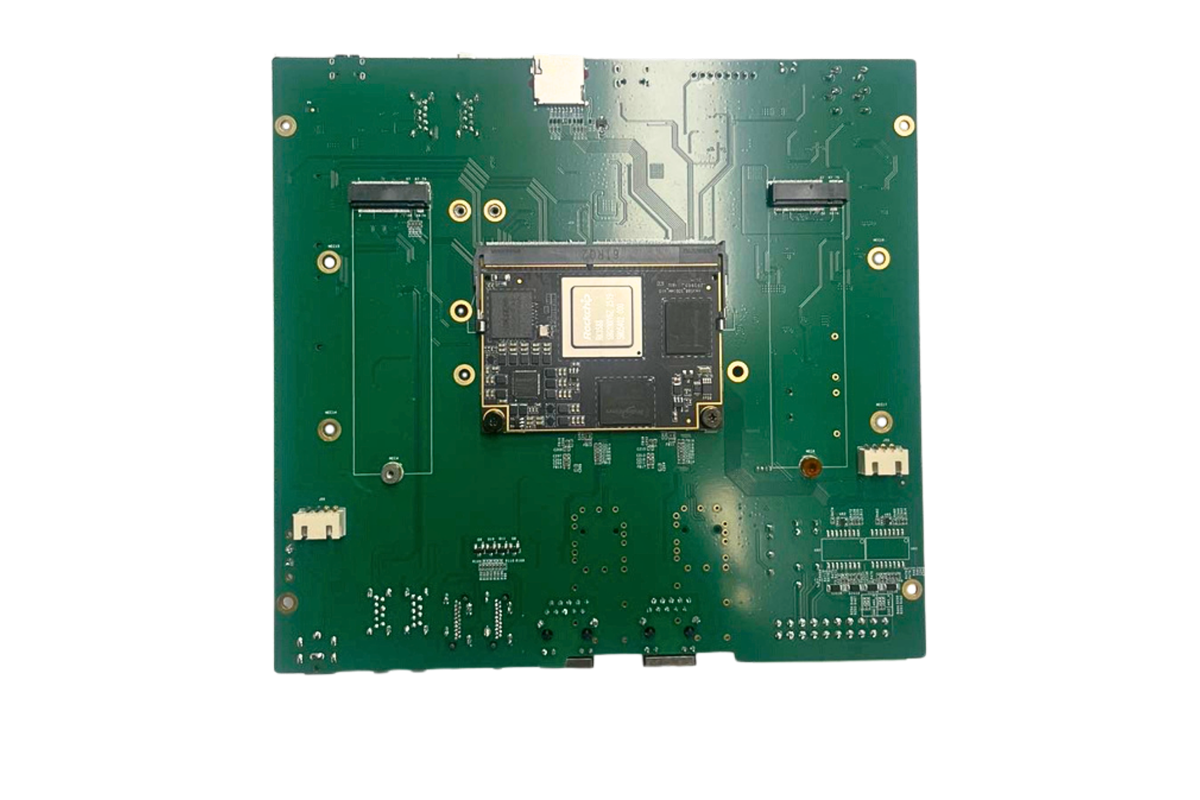
工控机、普通 x86 主机通过 M.2 插槽快速加装 AI 加速卡;
原有基于 OpenVINO 的视频分析项目,可低成本国产化硬件替换;
适配 OpenVINO Model Server(OVMS),快速提供 HTTP/gRPC 推理服务,适合容器化部署。
3. 开源驱动生态,加速社区共建
插件代码开源,开发者可自行二次开发:算子扩展、性能调优、适配更多模型、Windows 驱动适配(原生 SophonSDK 侧重 Linux)。
现状:插件当前优先支持 Linux x86,视觉模型(检测、分类、OCR)优先适配;大模型 VLM 处于持续完善阶段。
能力边界(需要注意)
1. 不是完全替代 SophonSDK:底层依旧依赖 BM1684X 的内核驱动与 TPU Runtime;高性能项目(多路视频硬编解码、极致吞吐)依然推荐原生 SophonSDK 开发;
2. 模型转换链路多一层开销:OpenVINO IR → BModel,复杂算子可能存在兼容性问题;
3. M.2 版本受 PCIe 带宽限制:多卡并发场景性能会低于 PCIe 全高卡版本;
4. 暂未纳入 OpenVINO 官方主线仓库,属于算能维护的第三方 Device Plugin。
对国产 M.2 算力赛道的意义
当前 M.2 AI 算力卡生态:RK1828、BM1684X、摩尔线程花港等国产方案逐步发力,对标 Jetson 系列边缘卡。
之前 OpenVINO 生态基本绑定 Intel 硬件;
BM1684X OpenVINO 插件开源,意味着国产 TPU 开始接入主流跨框架推理生态;
利好集成商:一套算法底座,硬件选型可以在 Intel NPU、BM1684X M.2 之间灵活切换,降低项目硬件锁定风险。
典型部署示例方向
1. x86 工控机 + BM1684X M.2 卡,原有 OpenVINO 视频检测算法,修改 device 名称即可跑在 TPU;
2. OVMS 容器,后端挂载 BM1684X M.2,对外提供统一推理 API;
3. 多卡堆叠:主板多个 M.2 插槽,多张 BM1684X M.2,通过 OpenVINO AUTO 插件做负载均衡。
后续生态展望
持续完善算子库,提升 LLM/VLM 多模态模型支持度;
完善 Windows 平台驱动与 OpenVINO 插件支持;
优化 IR→BModel 转换工具链,减少手动模型调参;
社区贡献:第三方开发者可提交 PR,补充算子、修复 bug。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部