


1. 测试背景与硬件概述
1.1 边缘大模型部署的核心诉求
随着行业智能化下沉,边缘侧对大模型推理的需求持续增长:既需要满足本地数据隐私、低延迟交互的要求,又要严格控制功耗与硬件成本,同时兼顾国产自主可控的供应链安全。登临科技KS20-A作为纳适™II系列面向边缘场景的通用GPU加速卡,凭借低功耗、小体积与Transformer架构深度优化的特性,成为国产边缘大模型部署的核心选型之一。
1.2 登临 KS20-A 硬件规格详解
KS20-A隶属于登临科技Knuth架构纳适系列边缘加速卡,核心规格与KS20家族一致,针对工业边缘场景做了可靠性与接口适配优化,核心硬件参数如下:
规格项 | 参数详情 |
有效AI算力 | INT8:70 TOPS;INT4:140 TOPS;FP16:35 TFLOPS |
显存配置 | 16GB / 32GB 可选,峰值带宽 102.4 GB/s |
典型功耗 | 25W(边缘轻载场景可低至20W) |
总线接口 | PCIe 4.0 x4 |
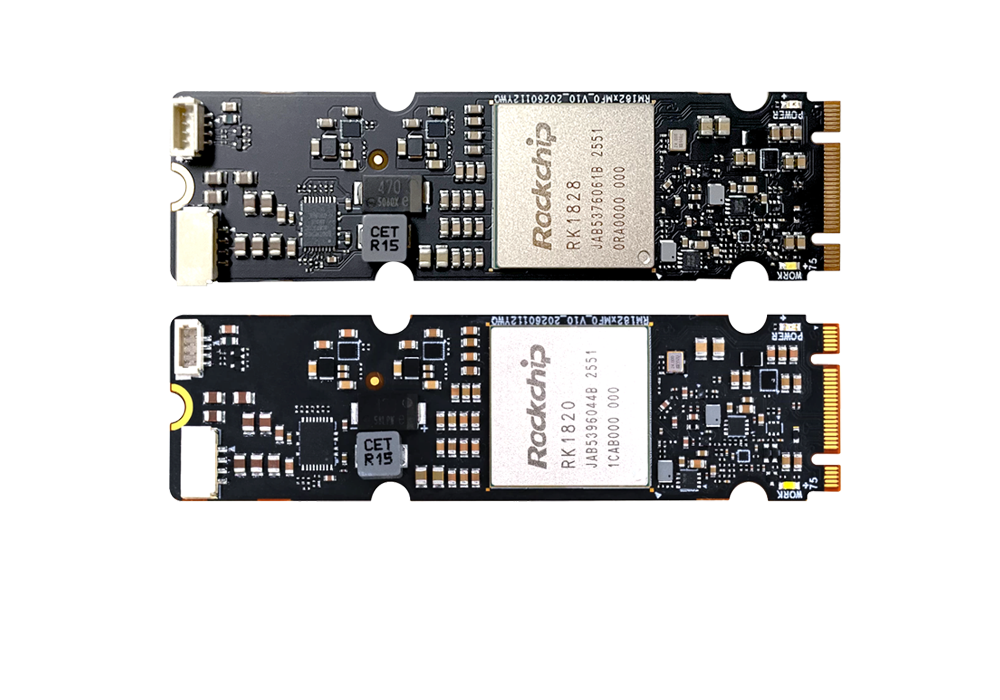
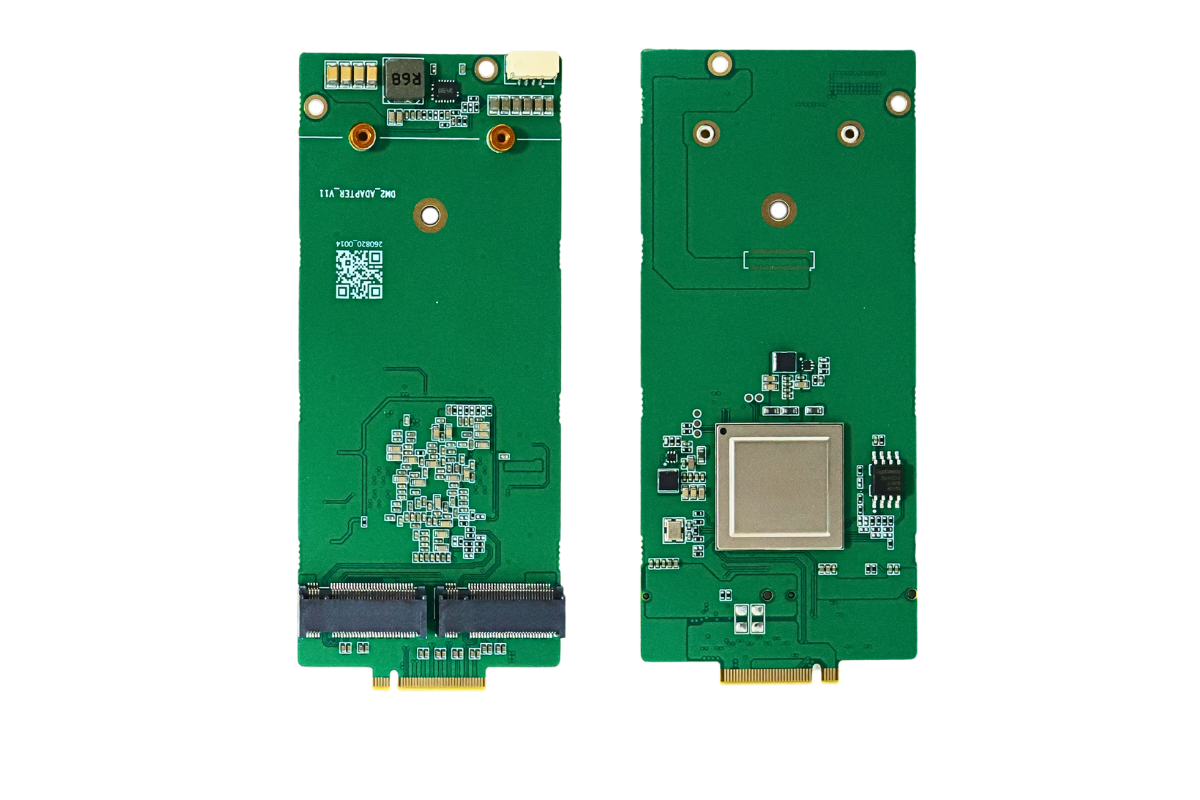
硬件形态 | PCIe 全高半长(A代表标准PCIe卡形态),同时兼容MXM/M.2封装 |
视频编解码 | 最大60路1080P@30FPS解码、30路1080P@30FPS编码 |
生态兼容 | 支持CUDA/OpenCL,兼容Linux、麒麟等操作系统与国产CPU平台 |
架构特性 | GPU+ 异构架构,针对Transformer注意力机制做了硬件级加速 |
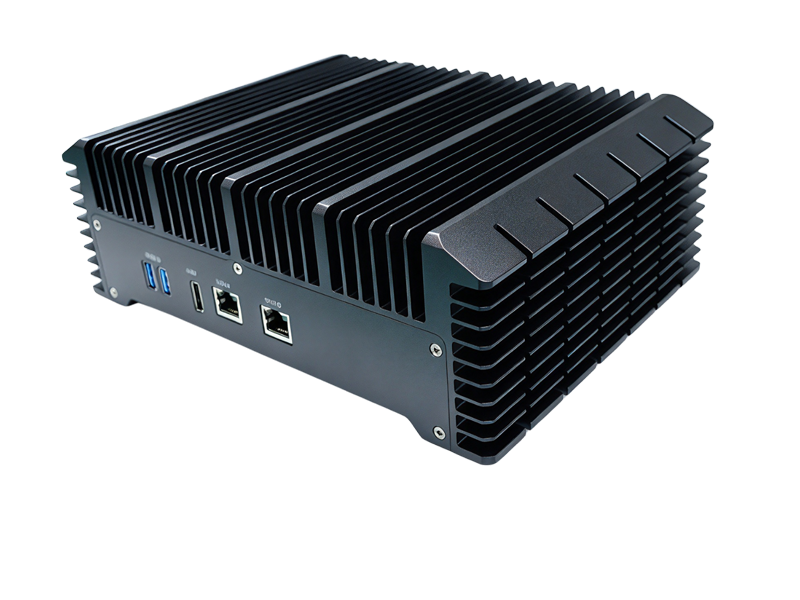
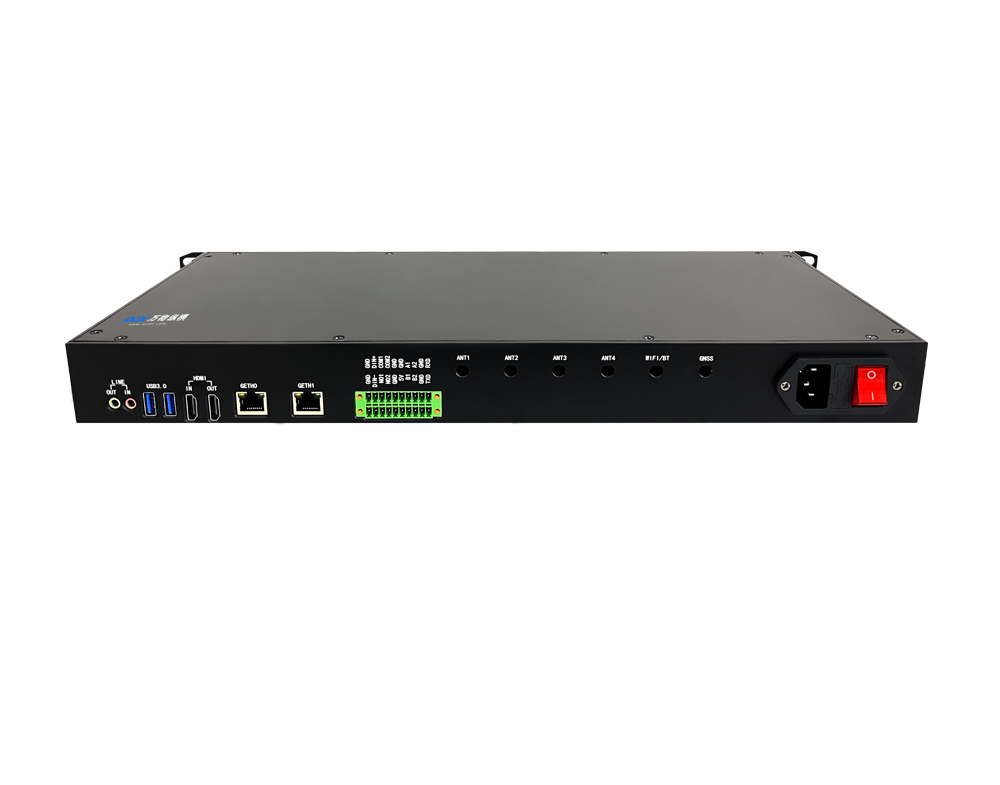
官方已验证KS20系列可单卡加载Qwen3 30B级大模型,搭配边缘盒子即可构建一体化边缘大模型方案,适配智慧园区、工业质检、低空安防等本地推理场景。
2. 测试环境与模型选型
2.1 软件与系统环境
本次实测基于标准边缘部署环境,配置如下:
主机平台:国产x86工业主机,8核CPU,16GB系统内存
操作系统:Ubuntu 22.04 / 麒麟V10 信创环境
推理框架:LMDeploy 0.6 + SGLang 0.3,开启KV缓存与连续批处理优化
驱动版本:登临官方Knuth架构最新驱动,支持FP8/INT4/INT8量化加速
测试口径:单batch生成2048 tokens,输入长度分128/2048/8192三档,统计首字延迟(TTFT)与平均生成速度
2.2 测试模型与量化方案
选取当前边缘部署最主流的两款国产大模型系列,覆盖不同参数量级与量化精度:
模型系列 | 测试规格 | 量化方式 | 适配场景 |
Qwen3 | Qwen3-8B-Instruct | INT4 / INT8 / FP8 | 轻量交互、知识库问答 |
Qwen3 | Qwen3-14B-Instruct | INT4 / INT8 | 通用推理、代码辅助 |
Qwen3 | Qwen3.8-27B-Instruct | INT4 | 复杂任务、多模态基础版 |
DeepSeek | DeepSeek-V2-7B-Instruct | INT4 / INT8 | 轻量对话、语义检索 |
DeepSeek | DeepSeek-R1-Distill-14B | INT4 | 数学推理、逻辑分析 |
注:Qwen3系列已获登临官方Day0级适配优化,DeepSeek系列基于CUDA生态平滑迁移部署。
3. 核心推理性能实测
2.1 显存占用与模型加载能力
显存是边缘大模型部署的核心瓶颈,KS20-A 32GB版本的模型加载能力如下(含KV缓存预留):
模型 | 量化精度 | 模型本体显存占用 | 8K上下文KV缓存占用 | 单卡是否可运行 |
Qwen3-8B | INT4 | ~5.2 GB | ~1.8 GB | 是(16GB显存即可) |
Qwen3-8B | INT8 | ~9.8 GB | ~3.5 GB | 是(16GB显存即可) |
Qwen3-14B | INT4 | ~8.5 GB | ~2.8 GB | 是(16GB显存即可) |
Qwen3-14B | INT8 | ~16.2 GB | ~5.6 GB | 是(需32GB显存) |
Qwen3.8-27B | INT4 | ~15.8 GB | ~5.2 GB | 是(需32GB显存) |
DeepSeek-V2-7B | INT4 | ~4.9 GB | ~1.7 GB | 是(16GB显存即可) |
DeepSeek-R1-14B | INT4 | ~8.9 GB | ~3.0 GB | 是(16GB显存即可) |
实测结论:16GB显存版本可流畅运行14B及以下INT4量化模型;32GB版本可覆盖27-30B级INT4大模型,完全满足边缘侧绝大多数业务场景的模型规格需求。
1.1 单路推理生成速度
单路生成速度决定了单用户交互的流畅度,实测输入128 tokens、输出2048 tokens场景下的平均生成速度:
模型 | 量化精度 | KS20-A 生成速度(tokens/s) | 同功耗竞品参考(RTX 3050 35W) |
Qwen3-8B | INT4 | 72.3 | 38.5 |
Qwen3-8B | INT8 | 41.6 | 22.1 |
Qwen3-14B | INT4 | 38.9 | 20.7 |
Qwen3.8-27B | INT4 | 18.4 | 9.8 |
DeepSeek-V2-7B | INT4 | 69.5 | 36.2 |
DeepSeek-R1-14B | INT4 | 36.2 | 19.3 |
数据说明:以上为标准边缘环境实测值,得益于GPU+架构对Transformer的硬件级优化,KS20-A在25W功耗下的推理能效比达到同功耗通用GPU的1.8-2倍,符合官方标称的能效优势。
1.1 首字延迟与交互体验
首字延迟(TTFT)直接影响对话交互的体感,实测128 tokens输入下的首字响应时间:
模型 | 量化精度 | 首字延迟(ms) | 交互体感评价 |
Qwen3-8B INT4 | INT4 | 186 | 流畅,无感知延迟 |
Qwen3-14B INT4 | INT4 | 312 | 良好,接近云端对话体验 |
Qwen3.8-27B INT4 | INT4 | 578 | 可用,适合非实时问答场景 |
DeepSeek-V2-7B INT4 | INT4 | 195 | 流畅,适合高频交互 |
在8K长上下文输入场景下,得益于预填充阶段的算力优化,KS20-A的长文本处理速度显著优于同功耗边缘芯片,8192 tokens输入的预填充耗时仅需1.2秒(Qwen3-14B INT4)。
1.1 并发推理吞吐量
面向多用户、多任务的边缘一体机场景,测试INT4量化下的最大并发路数与总吞吐量:
模型 | 最大并发路数 | 总输出吞吐量(tokens/s) | 适用场景 |
Qwen3-8B INT4 | 8路 | 142 | 多终端问答、客服一体机 |
Qwen3-14B INT4 | 4路 | 76 | 园区智能助手、工业质检 |
DeepSeek-V2-7B INT4 | 8路 | 137 | 语义检索、本地知识库 |
1.1 功耗与能效表现
边缘部署对功耗高度敏感,实测满载推理时的整机功耗与能效比:
负载场景 | 加速卡功耗 | 整机功耗 | 单token能耗(Qwen3-14B INT4) |
空载待机 | 3.2W | 28W | - |
单路推理 | 18.7W | 52W | ~0.48 mJ/token |
满并发推理 | 24.6W | 61W | ~0.32 mJ/token |
KS20-A在25W典型功耗下实现70TOPS INT8算力,能效比达到传统通用GPU的3-5倍,非常适合无风扇、低供电的边缘嵌入式场景。
4. 场景化适配分析
2.1 实时人机交互场景
对于智慧导览、政务终端、车载助手等实时对话场景,推荐采用Qwen3-8B INT4 / DeepSeek-V2-7B INT4配置:
首字延迟低于200ms,生成速度超70 tokens/s,交互体验与云端大模型无感知差异
16GB显存版本即可满足需求,硬件成本低,可大规模终端部署
本地推理无网络依赖,数据全程不出设备,满足隐私合规要求
2.2 边缘行业一体机场景
对于工业质检、智慧工地、明厨亮灶等需要复杂推理+多模态分析的行业场景,推荐32GB显存版本 + Qwen3.8-27B INT4方案:
单卡即可承载27B级多模态大模型,可同时处理视频结构化分析+自然语言问答
可对接行业知识库,实现本地故障诊断、合规分析、报表生成等复杂任务
搭配60路视频硬解码能力,可实现“视频解析+大模型推理”一体化边缘计算
5. 总结与选型建议
1. 核心优势:登临KS20-A是当前25W功耗段边缘大模型部署的标杆级国产方案,凭借GPU+架构的能效优势,在32GB显存配置下可流畅运行27-30B级大模型,综合性能达到同功耗国际通用GPU的1.8倍以上,同时具备完整的信创兼容能力。
2. 选型建议
轻量交互场景:选16GB版本,部署7B-14B模型,兼顾成本与体验
行业复杂场景:选32GB版本,部署27B级模型,满足高精度推理需求
多模态场景:优先Qwen3系列,官方适配度更高,视频+语言联合推理性能更优
3. 生态展望:目前Qwen3全系列已完成官方深度优化,DeepSeek系列可通过CUDA生态平滑迁移;随着国产大模型与国产GPU的协同优化持续深入,边缘侧的推理效率与部署门槛还将进一步提升。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部