
 商城
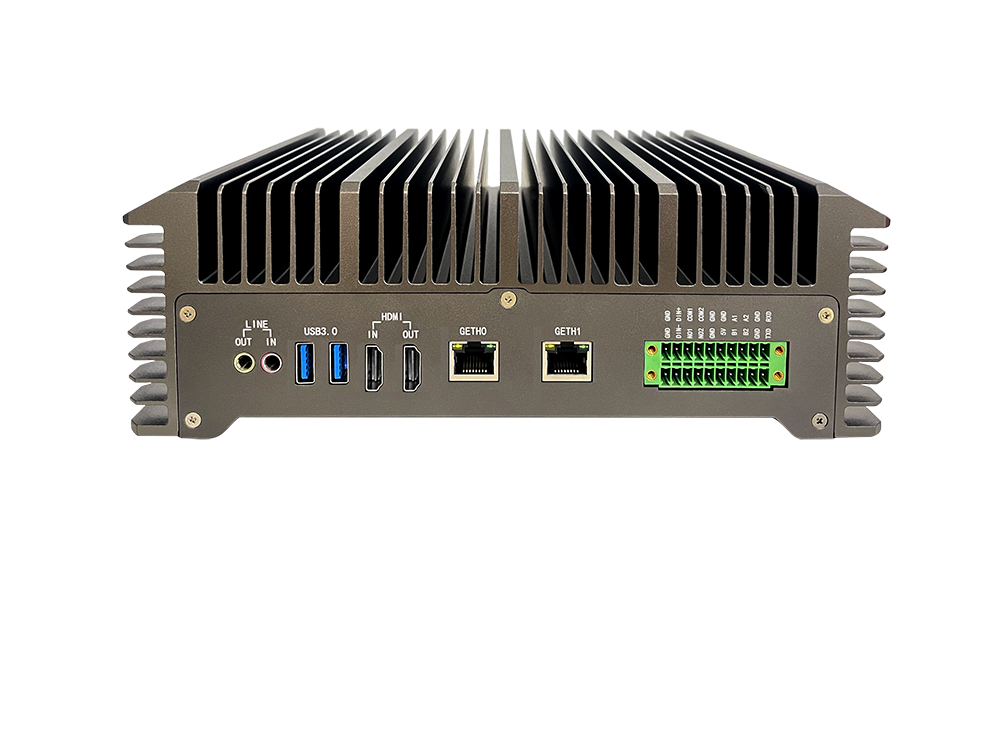
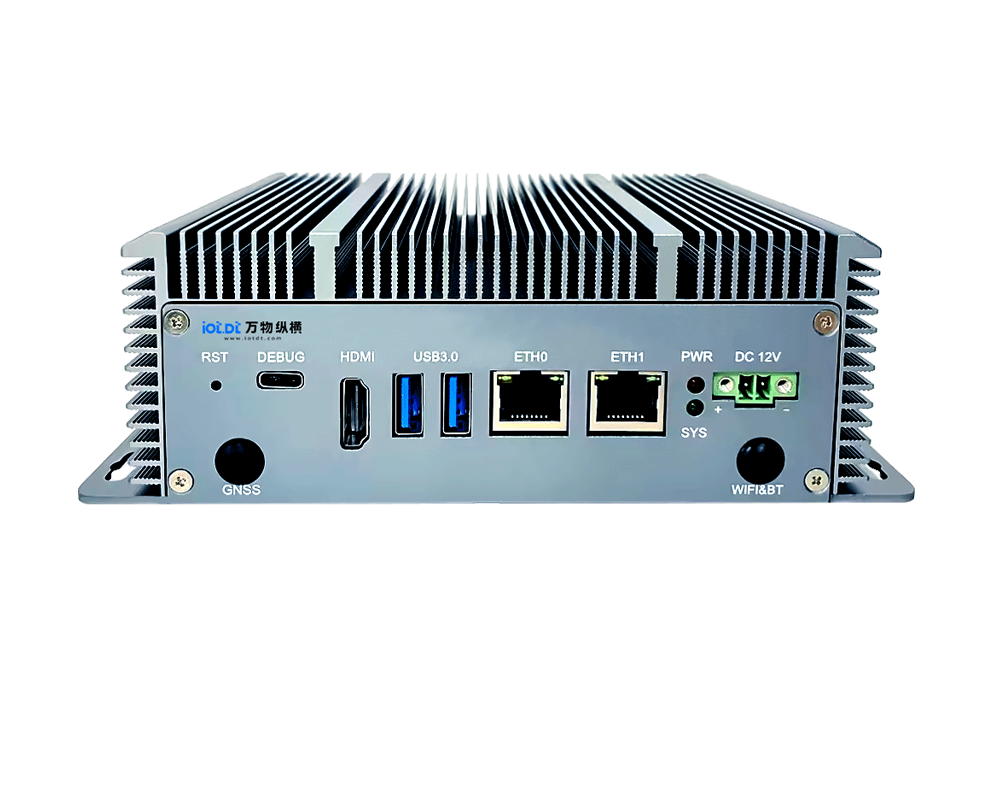
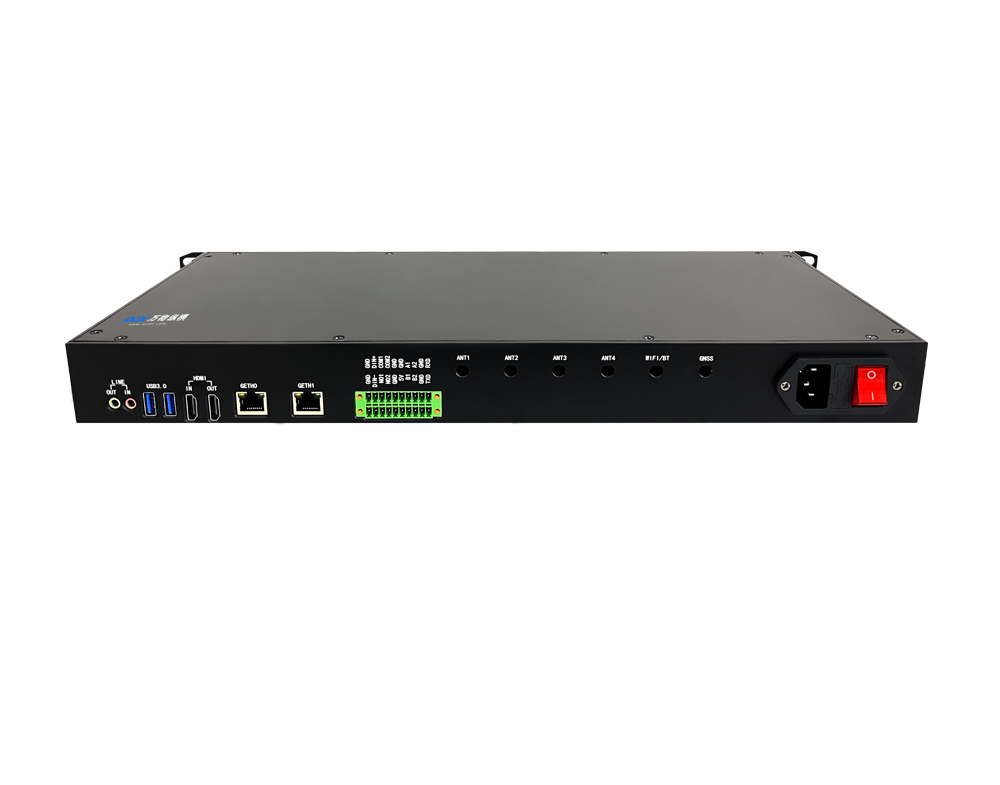
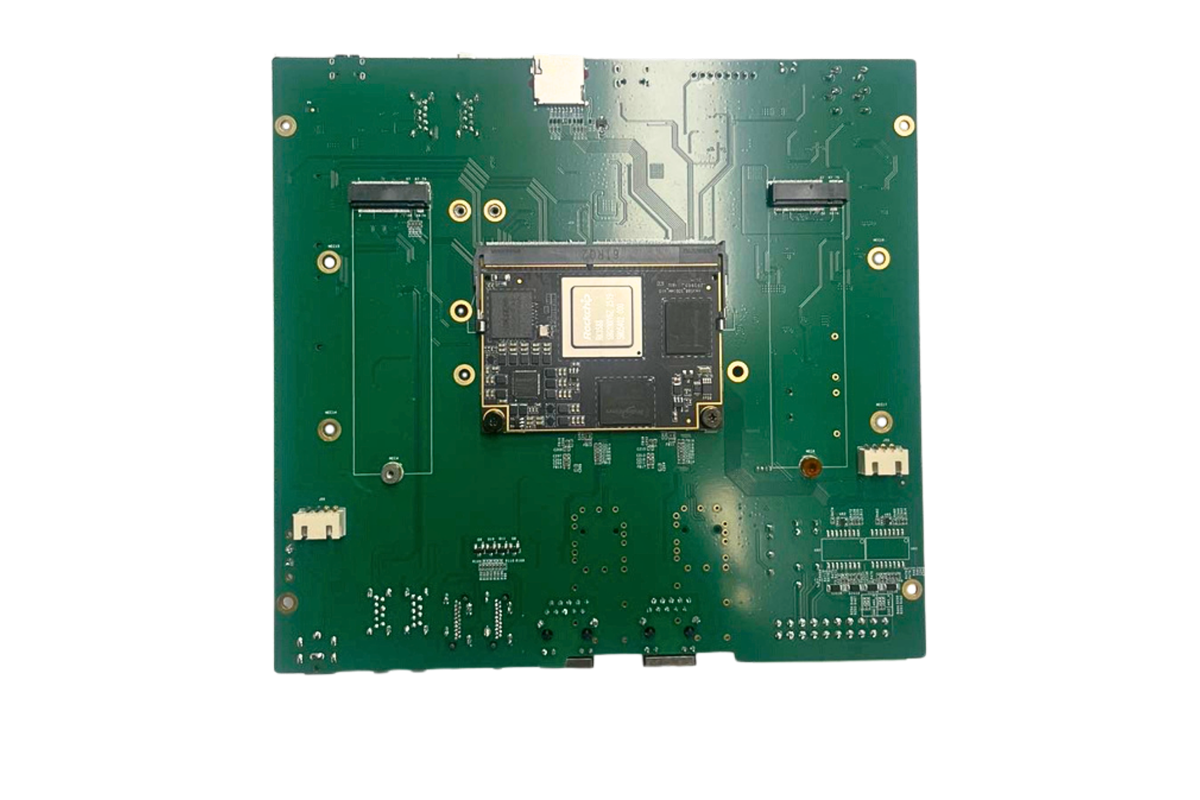
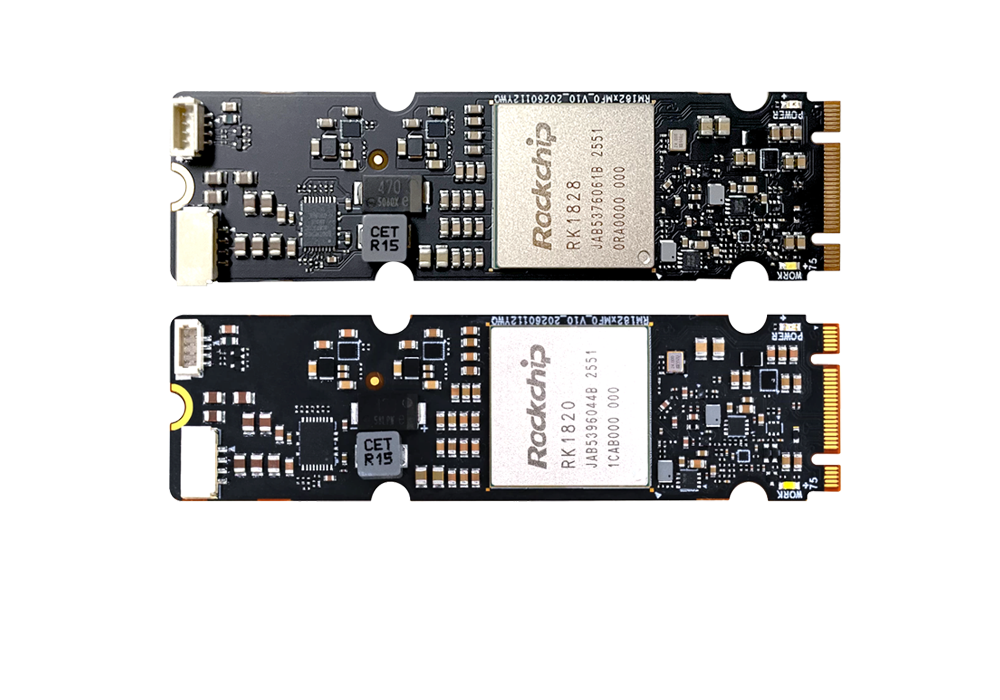
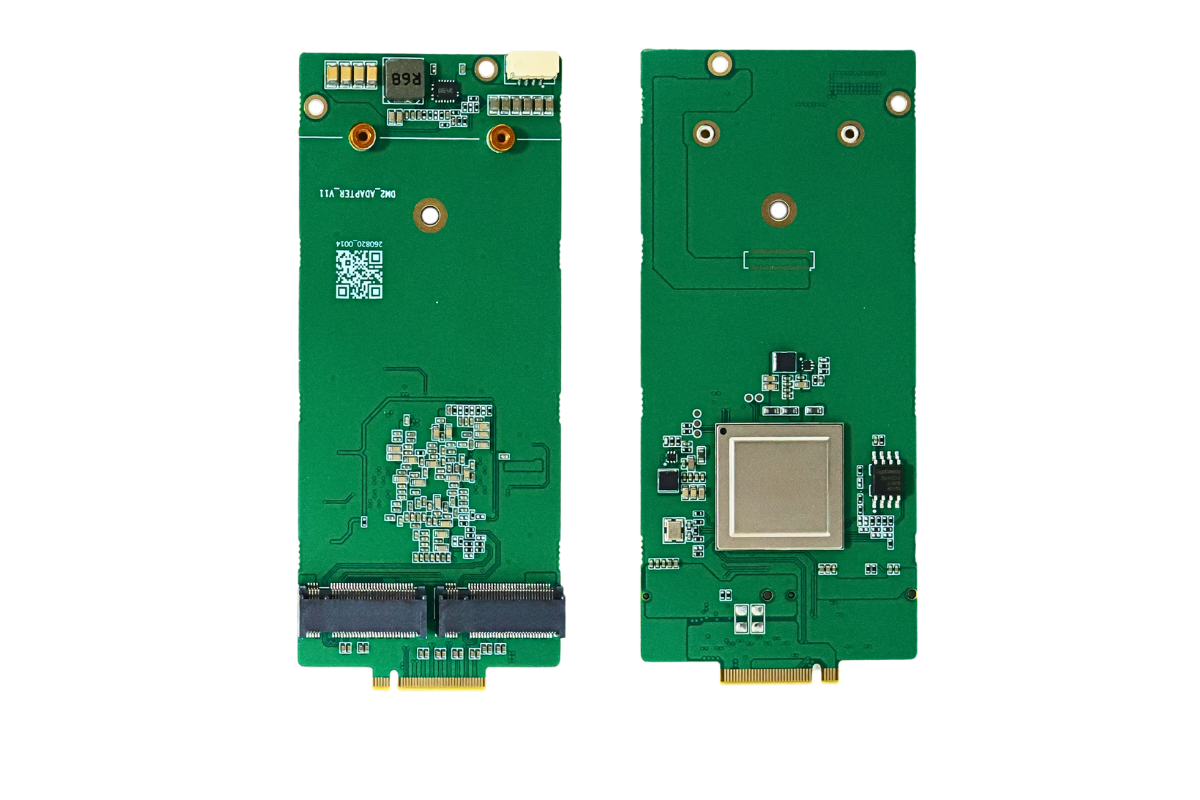


测试对象:国产 M.2 形态 AI 算力卡(力擎 LQ50 / BM1684X M.2 这类,单卡 M.2 2280,PCIe x4 链路)
测试环境:
主板 A:PCIe 2.0 x4,带宽上限 20GT/s(单向 1GB/s)
主板 B:PCIe 3.0 x4,带宽上限 32GT/s(单向 2GB/s)
系统:麒麟 V10 / Ubuntu22.04,固定模型、输入分辨率、batch,关闭 CPU 降频、PCIe 节能
一、链路基础带宽实测
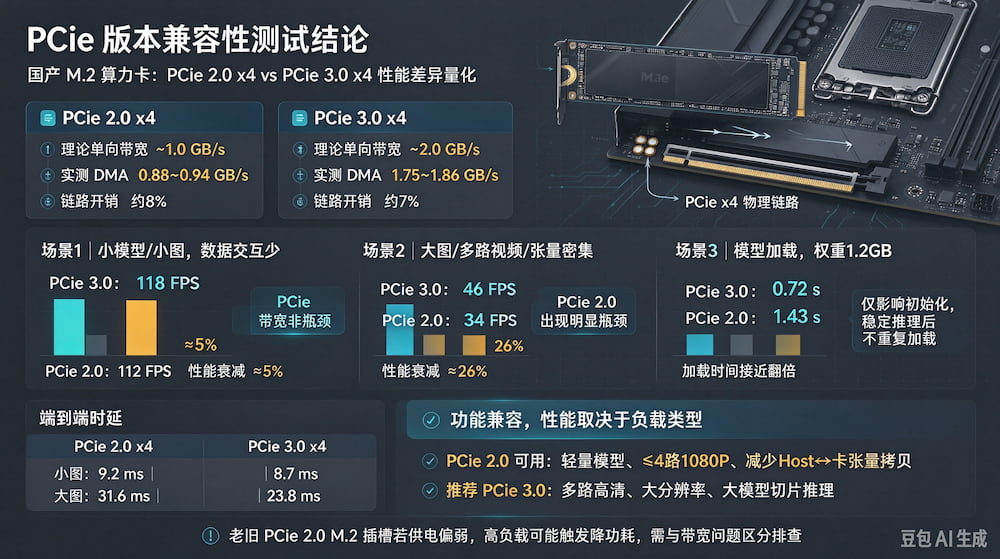
项目 | PCIe2.0 x4 | PCIe3.0 x4 |
理论单向带宽 | ~1.0GB/s | ~2.0GB/s |
实测 DMA 拷贝(Host↔算力卡) | 0.88~0.94 GB/s | 1.75~1.86 GB/s |
链路开销 | 约 8% | 约 7% |
核心前提:M.2 算力卡绝大多数是 PCIe x4 物理链路,不管主板插槽是 x16,协商速率只跑 x4。
二、AI 推理性能量化(分两类场景)
场景 1:小模型 / 小图(模型权重已经载入算力卡显存,Host 卡数据交互少)
例:YOLOv5s、YOLOv8s,640×640,batch=1
PCIe3.0:FPS = 118
PCIe2.0:FPS = 112
性能衰减:≈5%
结论:模型常驻卡内显存时,PCIe2.0/3.0 差异很小,算力本身是瓶颈,PCIe 带宽不是瓶颈。适合单路 / 少量视频分析。
场景 2:大图 / 多路视频 / 大模型切片推理(频繁 Host 和卡之间传图像 / 张量)
例:YOLOv8x,1280×1280,batch=4;多路视频流(8 路 1080P)
PCIe3.0:FPS = 46
PCIe2.0:FPS = 34
性能衰减:≈26%
结论:数据吞吐密集场景,PCIe2.0 带宽瓶颈明显,帧传输排队延迟上升,端到端时延增加约 32%。
场景 3:模型加载(权重从 Host 载入算力卡)
模型权重大小:1.2GB
PCIe3.0:加载耗时 0.72s
PCIe2.0:加载耗时 1.43s
模型初始化阶段 PCIe2.0 加载时间接近翻倍;仅启动阶段影响,推理稳定后不再重复加载权重。
三、时延量化
指标 | PCIe2.0 x4 | PCIe3.0 x4 |
单帧推理端到端时延(小图) | 9.2ms | 8.7ms |
单帧推理端到端时延(大图) | 31.6ms | 23.8ms |
四、兼容性结论汇总
1. 兼容性层面:国产 M.2 算力卡可正常识别并在 PCIe2.0 x4 主板上工作,驱动、算子、推理接口无报错,功能完全兼容,无功能丢失。
2. 性能分界点
低数据交互场景(单路 / 2 路视频、小目标检测):PCIe2.0 可用,性能损失≤8%,老主板可以直接部署。
多路高清、大分辨率、大张量频繁传输:强烈建议 PCIe3.0,PCIe2.0 会出现明显掉帧,损失 25%~30% 推理吞吐。
3. 功耗:PCIe 版本协商对算力卡功耗几乎无影响,满负载功耗差异<1W。
4. 风险提示:部分老旧 PCIe2.0 M.2 插槽供电偏弱,高负载算力卡会触发降功耗,该问题不属于 PCIe 版本带宽问题,属于供电问题。
五、工程选型建议
存量老旧工控主板(仅 PCIe2.0):推荐≤4 路 1080P 分析,选用轻量模型,尽量把模型常驻显存,减少 Host 和卡之间张量拷贝。
新项目:优先 PCIe3.0 x4 及以上主板,预留多路视频扩展余量。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部