
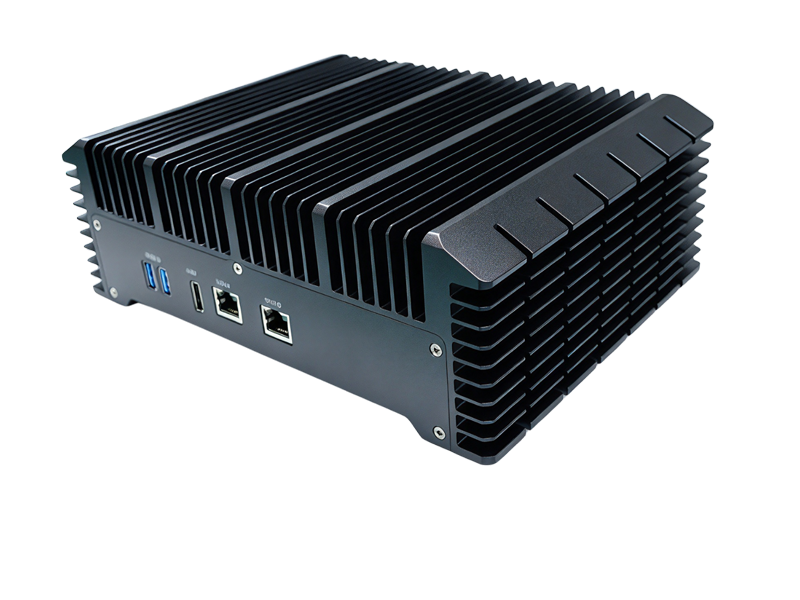
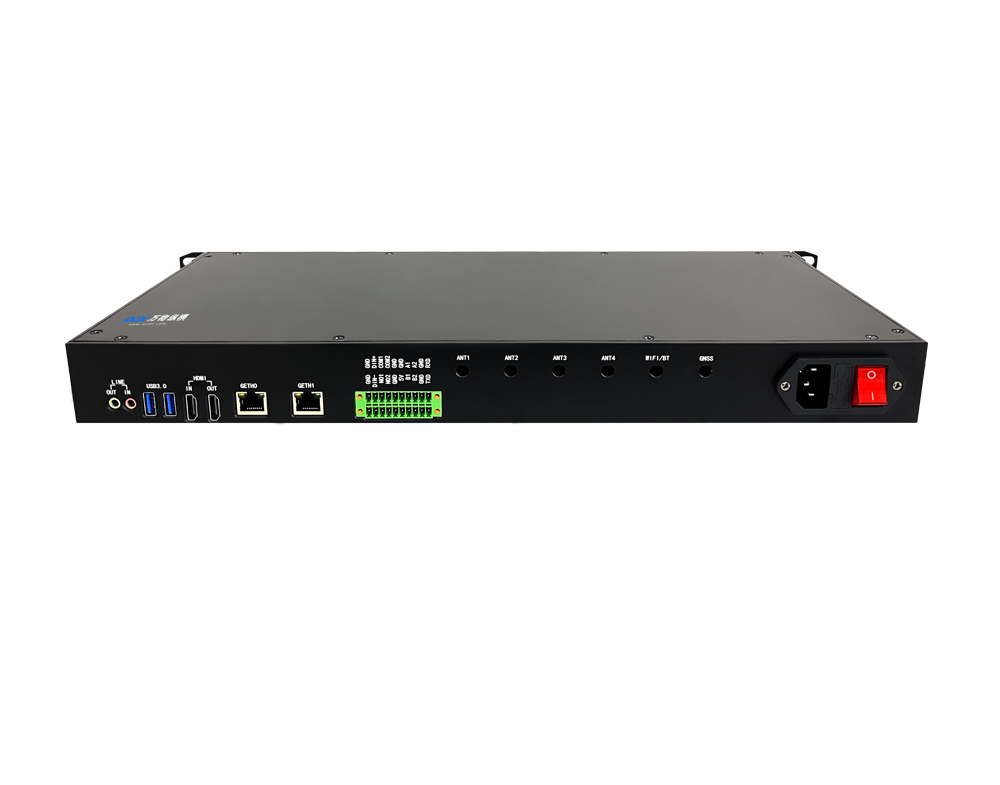
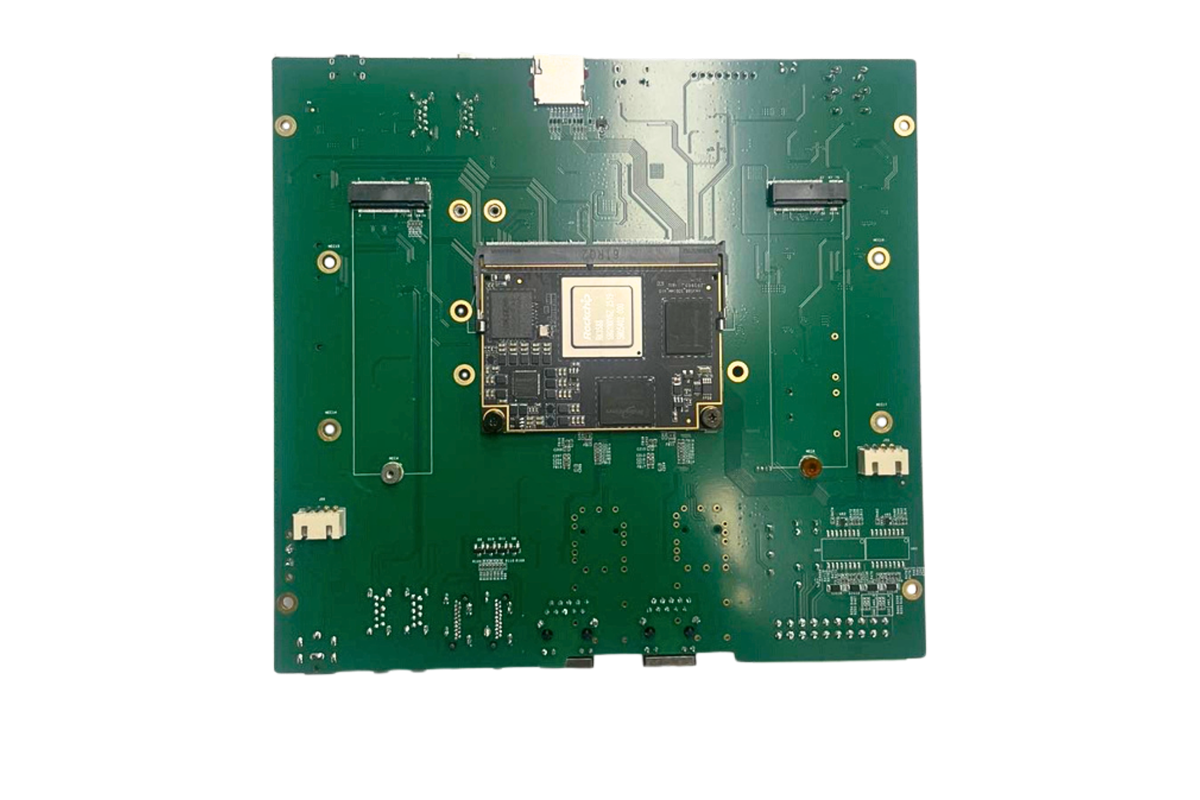
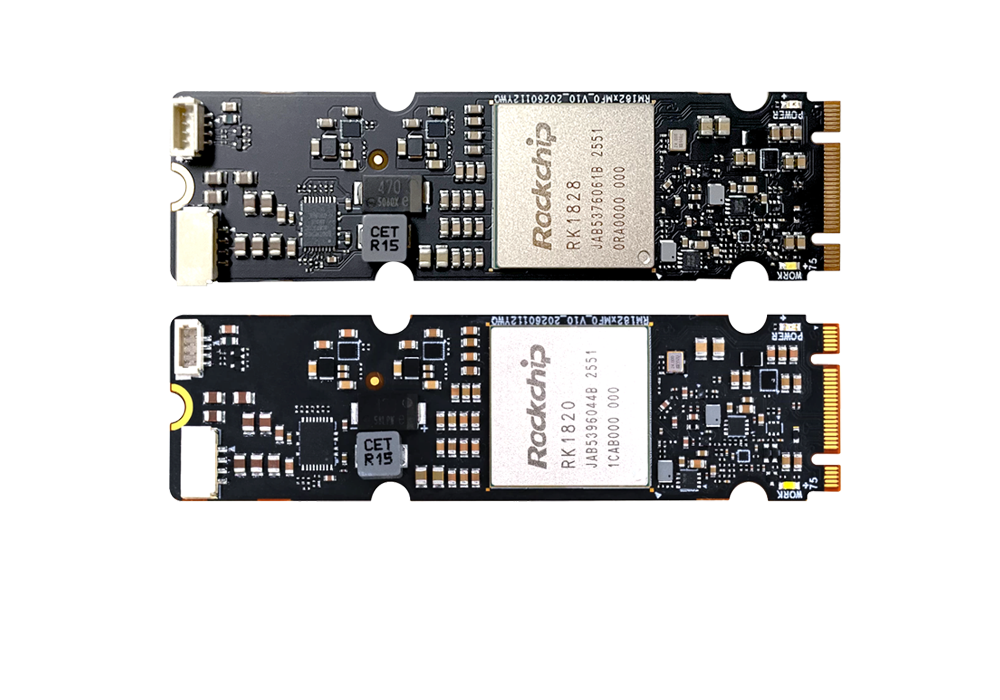
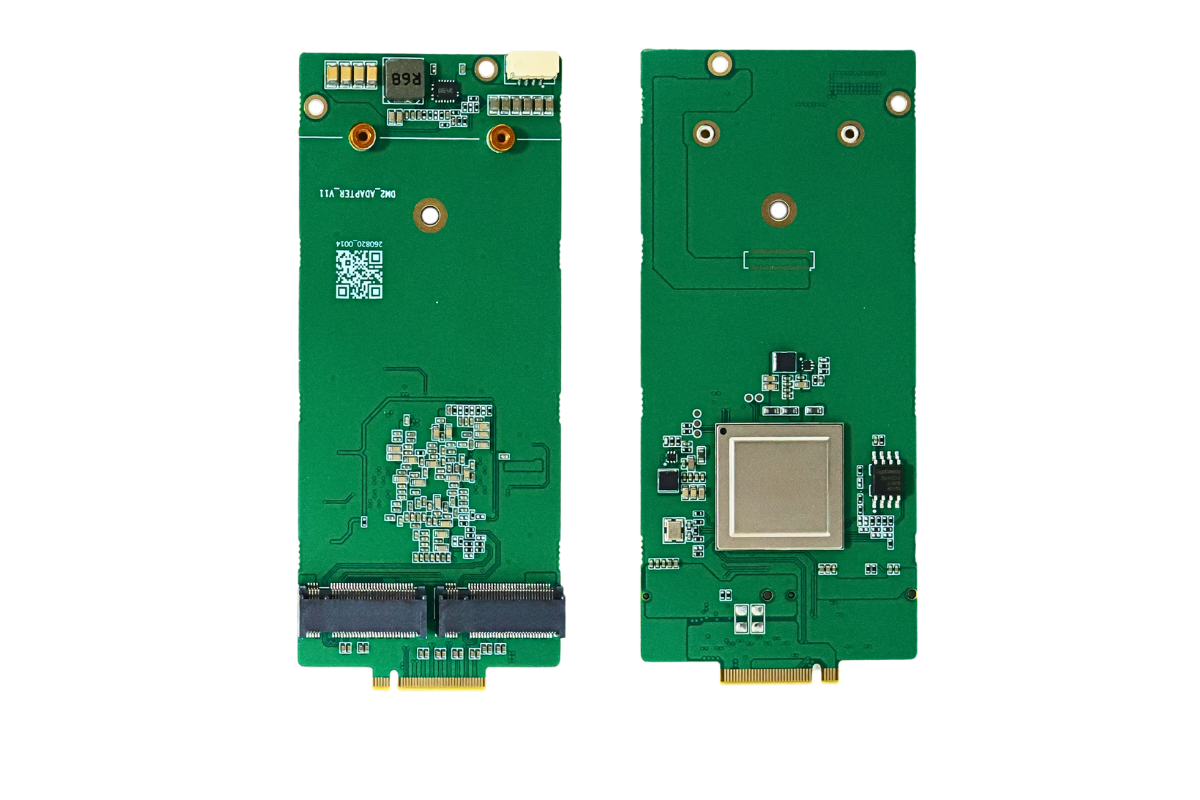


边缘部署大模型,长期面临两大痛点:硬件固定算力,模型升级就要更换整机;定制开发成本高昂,碎片化行业需求难以落地。万物纵横基于RK3588硬件平台,推出RK182X、HM50、DL20三款差异化M.2算力模组,采用"通用主控+专用AI算力"的弹性架构,实现算力按需选配,让边缘大模型部署轻量化、低成本化。
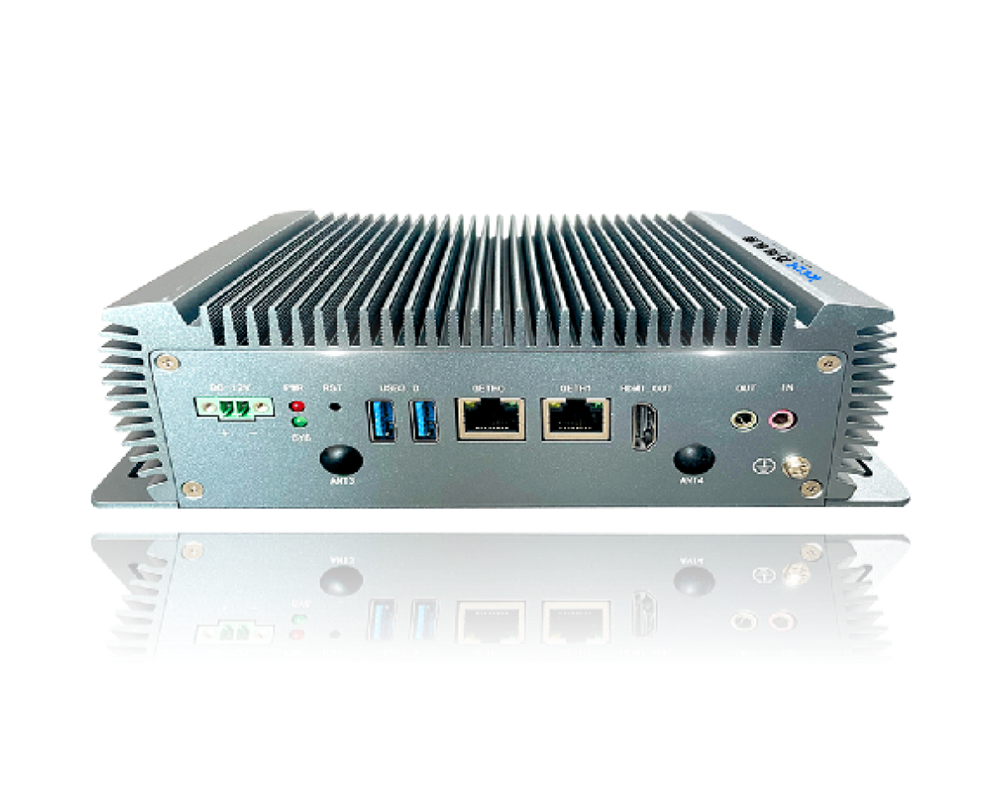
三款算力模组定位清晰,覆盖从轻量多模态到高参数量大模型全谱系:
RK182X模组(20TOPS INT8),高性价比协处理器,5GB高速DRAM,延迟低至0.1s,适配3-7B参数量LLM/VLM模型,例如Qwen2.5-3B、DeepSeek-R1-Distill-7B,适合同声传译、轻量化多模态识别场景,功耗低至6-15W,驱动同源适配,几乎零二次开发成本。
HM50模组(160TOPS INT8),第二代天璇IPU存算一体架构,显存最高48GB,能效比可达16T/W,适配7B-30B大参数量模型,支持Qwen3、ChatGLM、Llama2等主流大模型,作为边缘大模型主力推理引擎,支持多模组扩容,适配多系统环境,面向油田、交通等中大模型业务场景。
DL20模组(60TOPS INT8),Minsky™异构计算平台,支持INT4/BF16多精度运算,可实现32路视频解码,工业级宽温能力,7×24小时不间断稳定运行,适配7B-13B多模态大模型,适合工业现场7*24不间断视频分析业务。
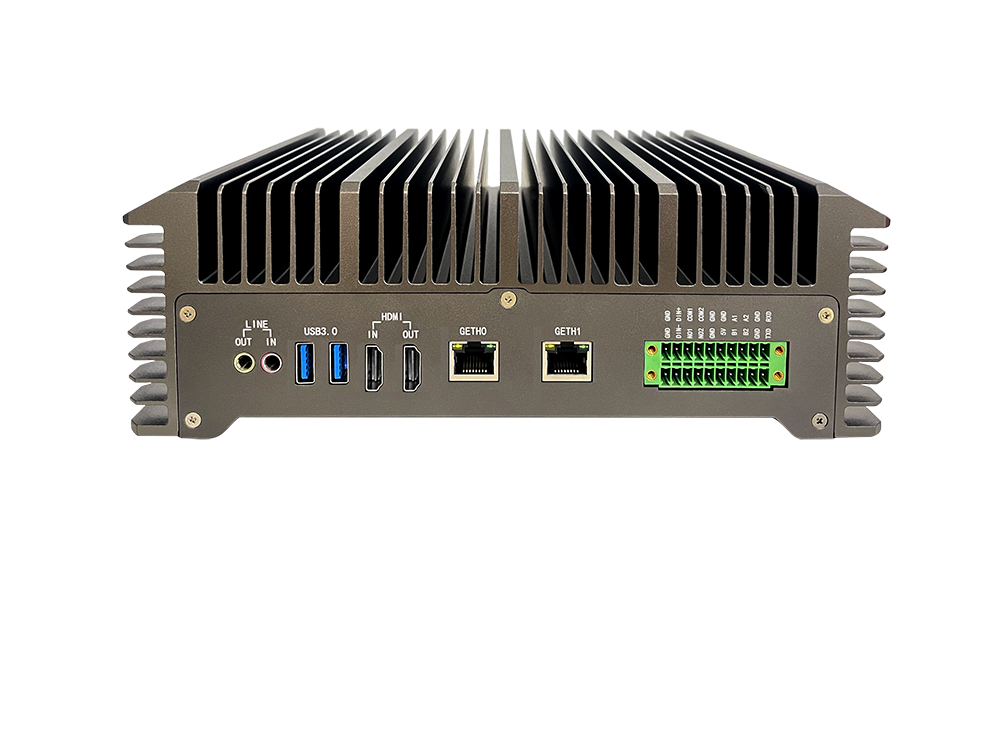
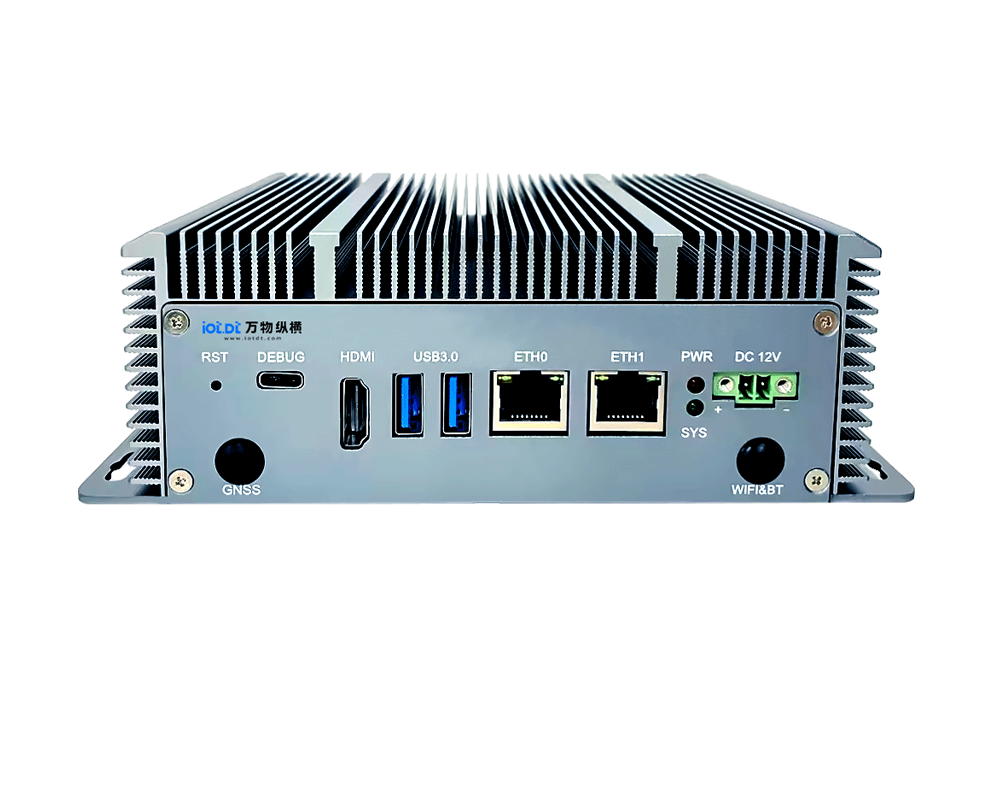
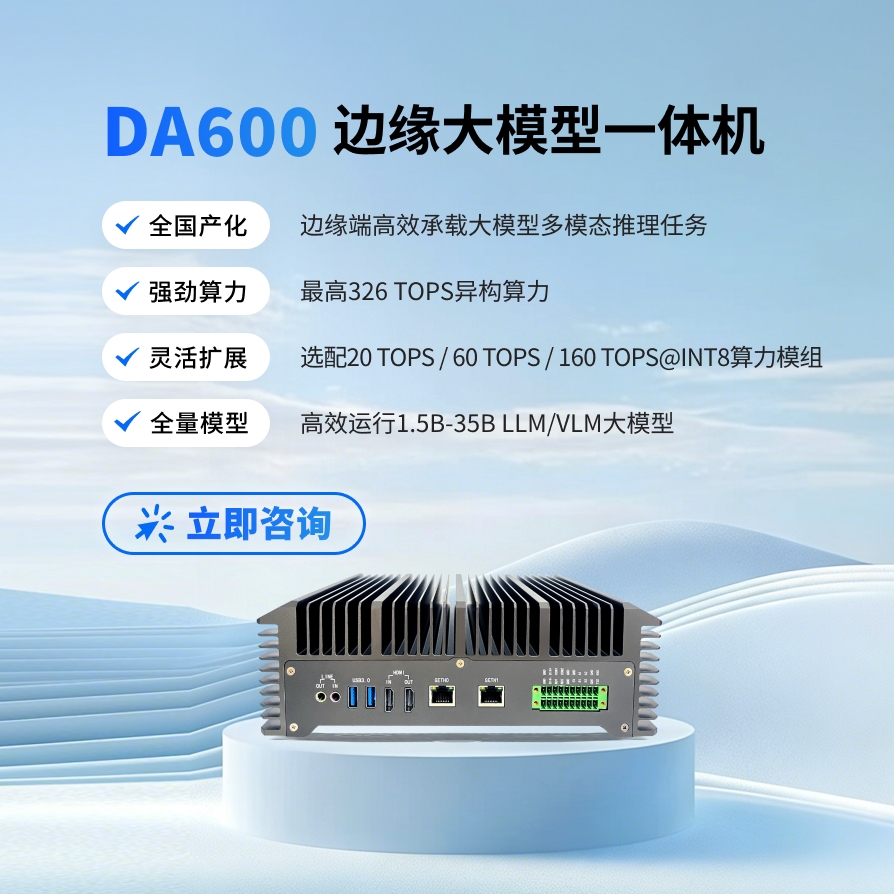
算力模组直接通过设备M.2 PCIe接口即插即用,DA060R支持单模组扩展;DA600支持双模组并行;DS-35R机架服务器最高支持4张模组同时工作,整机算力最高646TOPS@INT8。无需更换主机,根据业务迭代升级算力,极大保护用户硬件投资。
硬件之外,算力模组深度适配Qwen系列、Llama2、Gemma、DeepSeek、InternVL等主流开源大模型,支持文本、图像、视频端到端多模态推理,端到端最低0.1s推理延迟。配合万物纵横AI算法平台,实现大模型10秒生成新算法,摆脱传统百万样本数据标注、数月开发周期,碎片化长尾需求不再需要高昂定制开发费用,把原来十万级的定制开发成本降至近乎零成本,解决非标设备、稀缺样本场景AI落地难题。
这套异构算力方案把大模型真正带到工业现场,兼顾功耗、算力、成本,为智慧工厂、能源、交通、安防提供可落地的边缘生成式AI底座。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部