
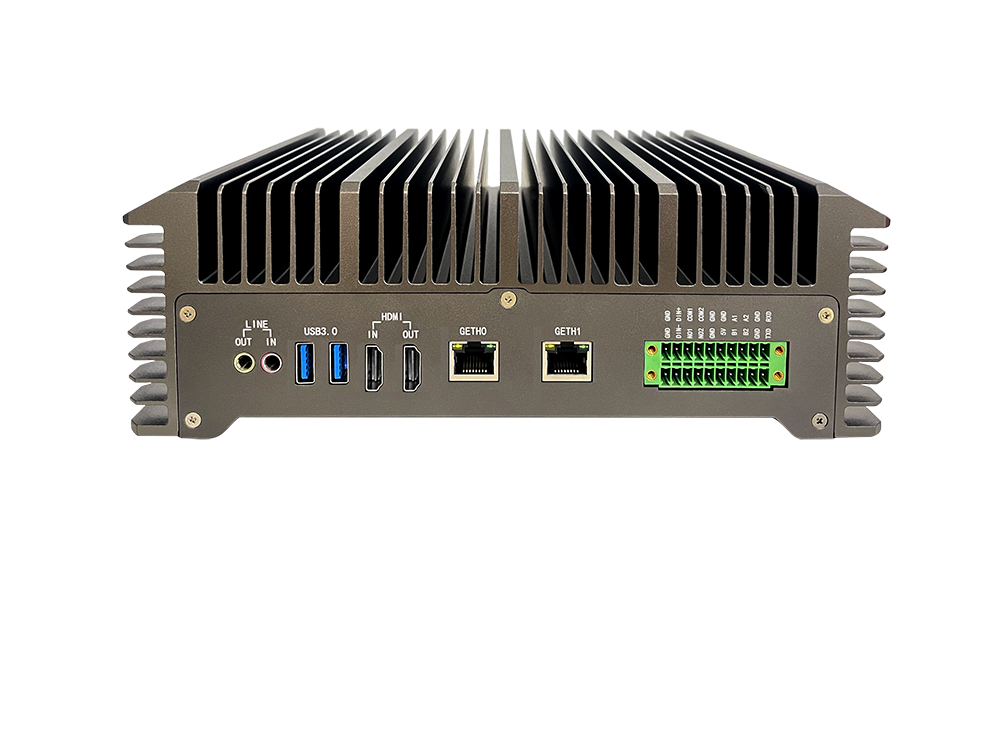
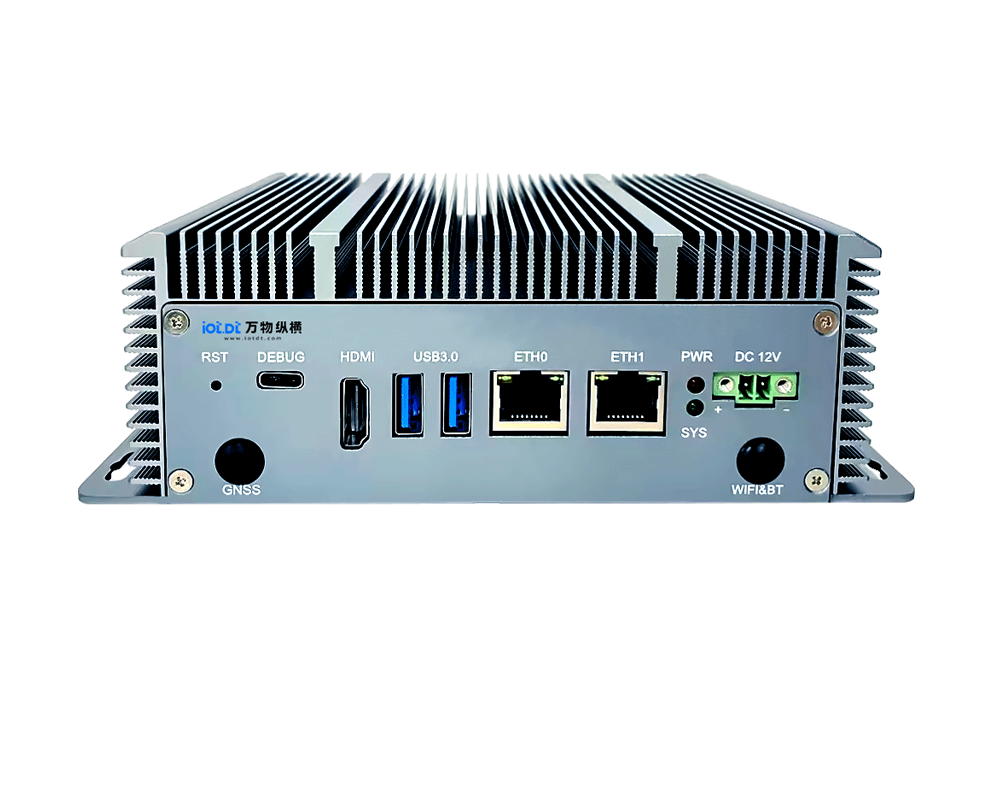
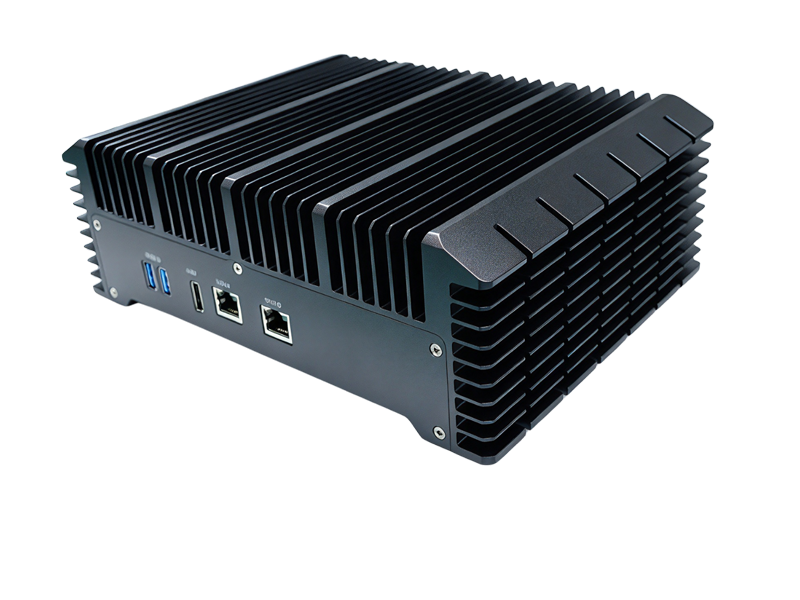
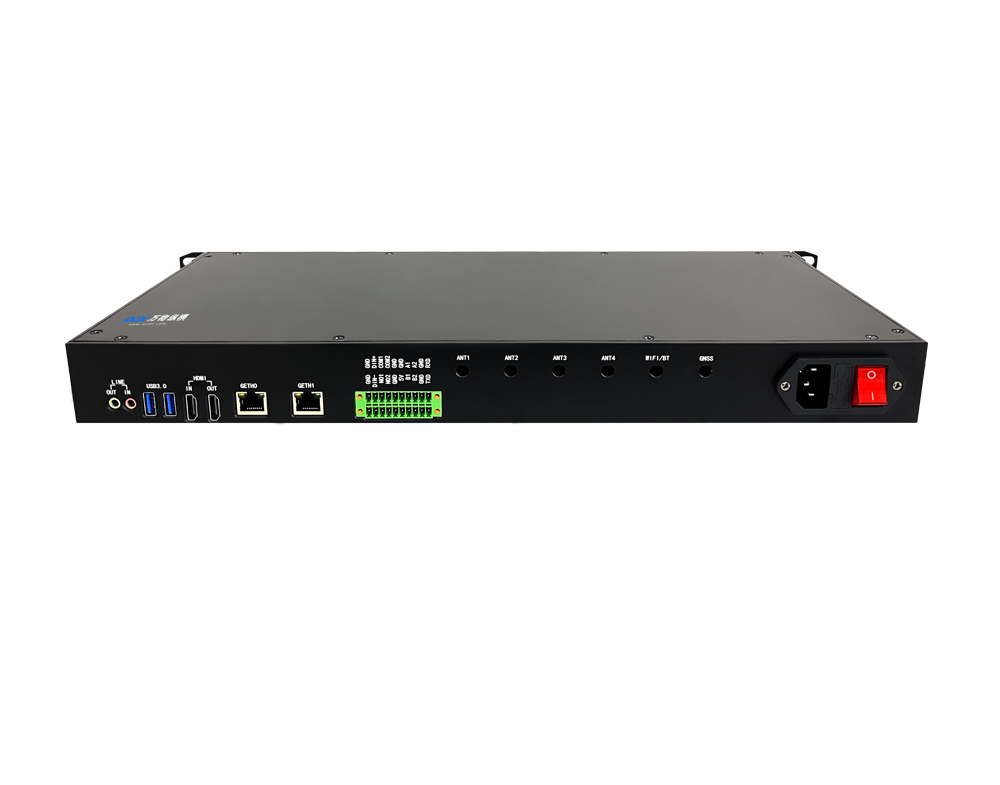
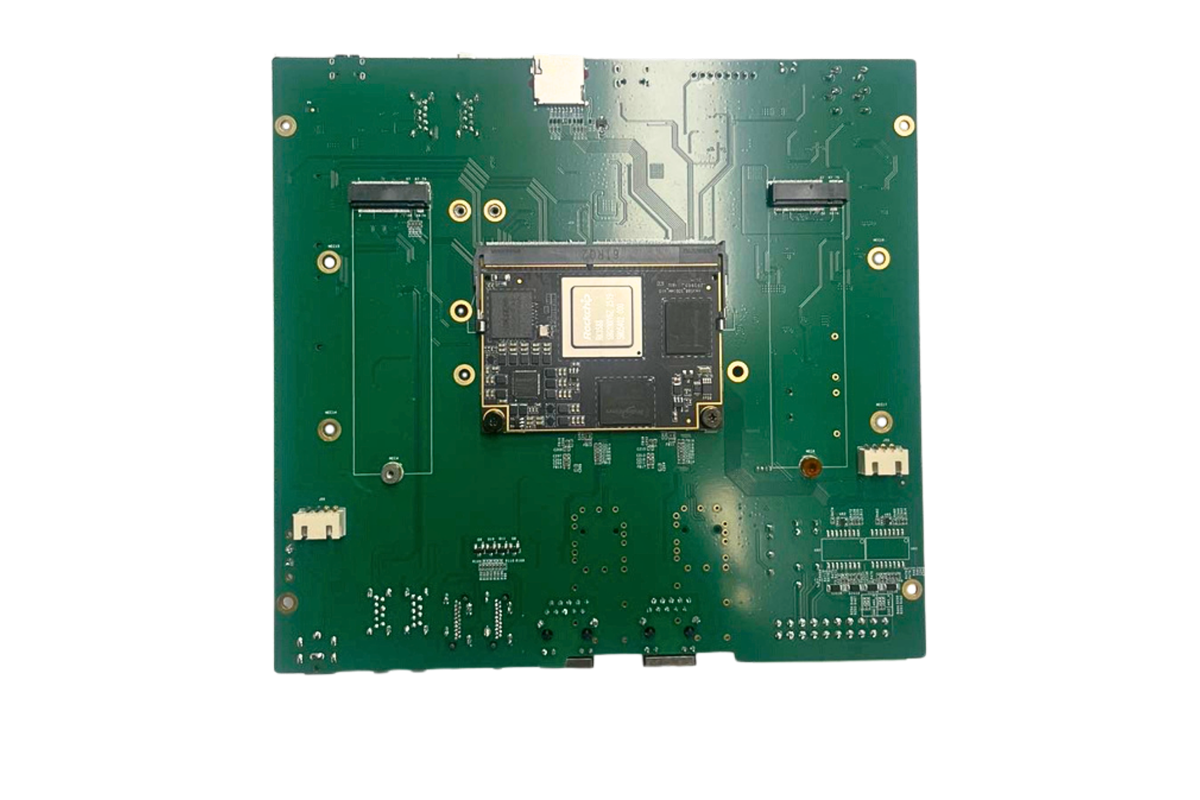
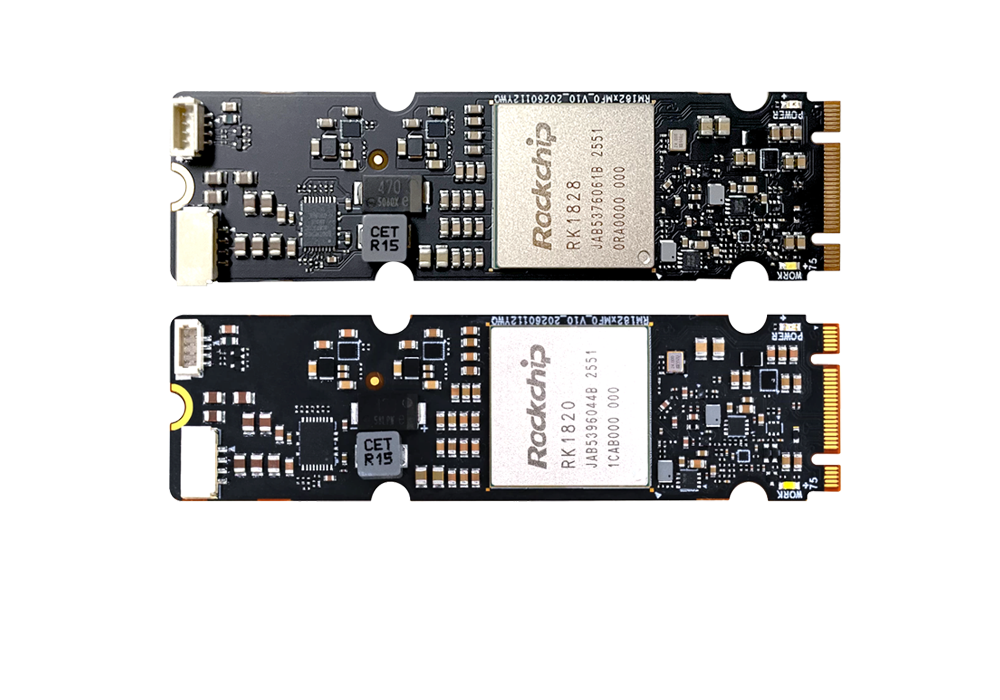
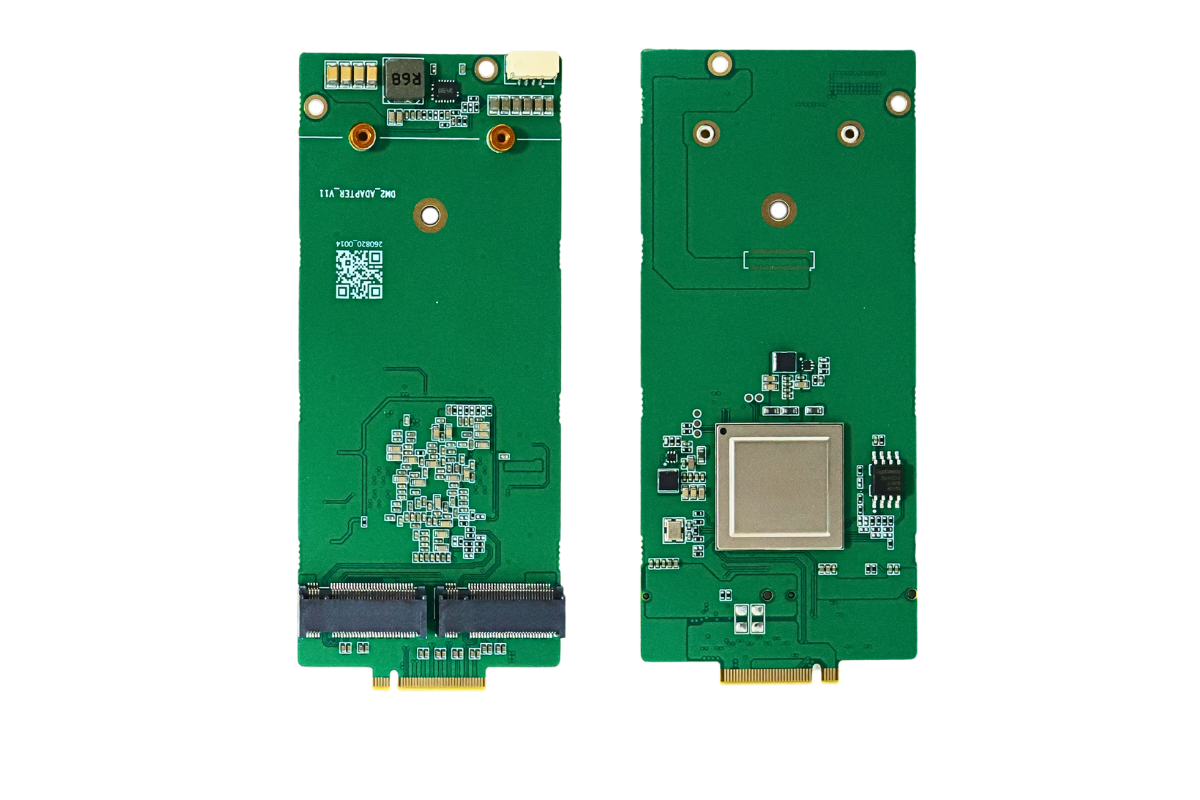


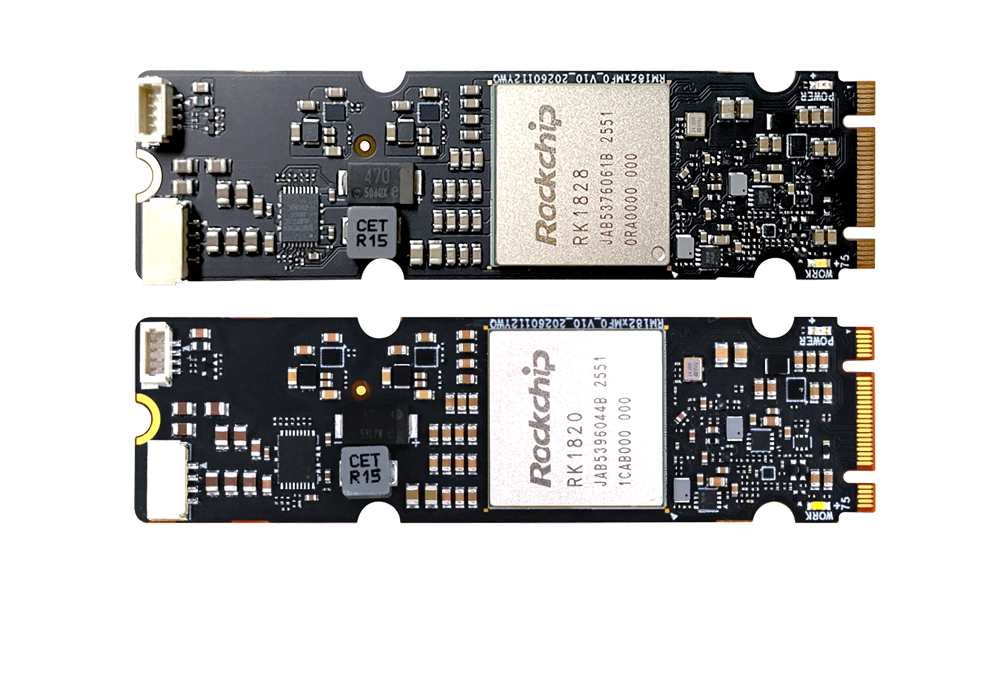
测试基准:OK3588-C 主控 + 4×RK1828 M.2 算力卡,PCIe链路,RKNN3 SDK,流水线并行切分模型,量化方案:W4A16/G32,lm_head W6A16,norm保留FP16;单卡5GB 3D DRAM、20TOPS@INT8,单卡功耗≈10W,4卡满载合计约40W
一、核心实测数据表
模型 | 配置 | 上下文 | 链路 | TTFT首token延迟 | Prefill吞吐TPS | Decode生成TPS |
Qwen3.8-27B | 4×RK1828 | 4K | PCIe | 6.92s | 592.1 | 13.02 |
Qwen3.8-27B | 4×RK1828 | 4K | USB3.0 | 7.15s | 573.2 | 13.02 |
Qwen3.8-27B | 4×RK1828 | 8K | PCIe | 13.67s | 599.4 | 12.74 |
官方标注标称值:Decode稳定约13 token/s,和实测吻合;适合RAG知识库问答、代码生成、多步骤推理,不适合高速流式对话
二、原理:RK1828四卡级联怎么跑27B
采用流水线并行(Pipeline Parallel),把Qwen3.8-27B的Transformer层切成4段,每一段加载到一张RK1828的独立片上DRAM,主控负责调度、KVCache流转、卡间PCIe数据接力;不是张量并行,是层切流水,对PCIe延迟比较敏感
优势:不占用主控内存,全部权重放4卡独立5GB堆叠DRAM,主控RK3588只管调度+业务+视频接入,算力与业务解耦
短板:Prefill串行流水,输入越长,首token等待时间线性拉长;8K上下文TTFT直接冲到13.67s,长文档检索场景体感会明显变慢
三、功耗、散热与硬件门槛
1. 功耗:4卡推理满载≈40W,低功耗是这套方案最大亮点,对比GPU跑27B功耗优势巨大,无强制水冷需求,适合工业盒子、智慧工地、本地RAG机柜
2. 硬件前提:主板需要支持多路M.2 Key-M PCIe(推荐PCIe3.0 x4);USB版本性能略低,卡间传输开销更大
3. 量化取舍:W4混合量化才能塞进4×5GB显存;精度有小幅损失,官方测试在代码、逻辑问答场景下降幅可控,适合私有化内网部署,不能对标FP16满血27B
四、横向对比参考(同生态)
2×RK1828:Qwen3.5-9B,PCIe 8K上下文,Decode≈32 token/s,TTFT 9.73s
单RK1828:原生适配7B级模型,Qwen2.5-7B约70token/s,速度快很多
五、适合&不适合场景
✅ 适合:本地私有化知识库RAG、内网文档解析、工业运维问答、边缘Agent、低功耗无人值守算力盒、数据不出本地项目
❌ 不适合:高并发、低延迟实时对话、需要持续高速流式输出、超长20K+上下文高频调用
六、争议点(网上热帖讨论焦点)
1. 很多网友质疑13token/s偏慢:本质是流水线并行的天然短板,Prefill串行叠加PCIe卡间传输开销,不是芯片NPU算力不够;张量并行方案速度会更高,但RK1828当前SDK优先落地流水线级联
2. USB版和PCIe差距很小?Decode速度几乎一致,差距集中在首token和prefill吞吐,USB链路主要增加预处理等待
3. 对比N卡:速度远低于RTX卡,但功耗、体积、国产化、工业宽温、无持续云服务费是差异化卖点
七、配套已验证模型清单(4卡方案)
Qwen3.5-27B / Qwen3.8-27B / Gemma-4-31B-it
请用手机扫码查看分享内容
 下一篇:LQ50 Duo HM-Link 实测:单向 3.6GB/s、RTT 300ns,14B 推理飙到 54 token/s
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)


 试用申请
 产品咨询
 在线客服
 回到顶部