
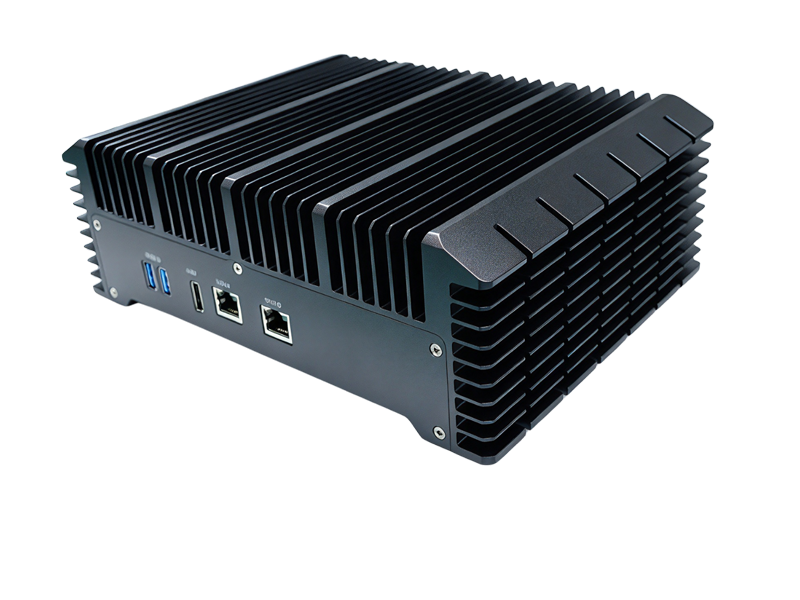
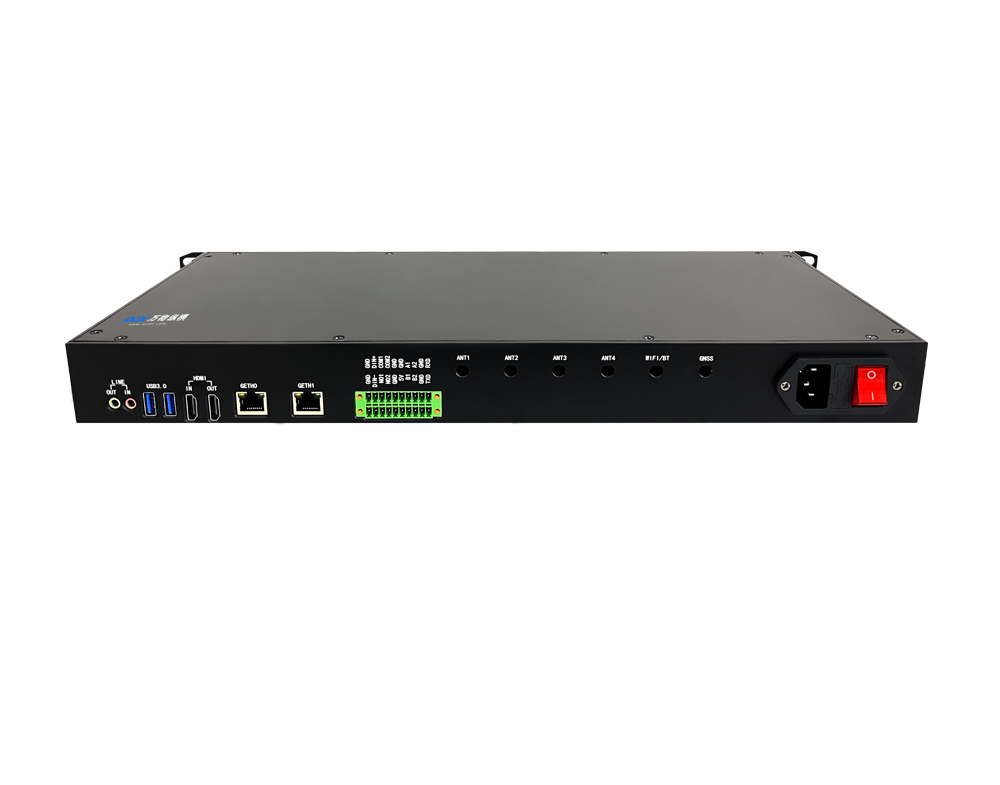
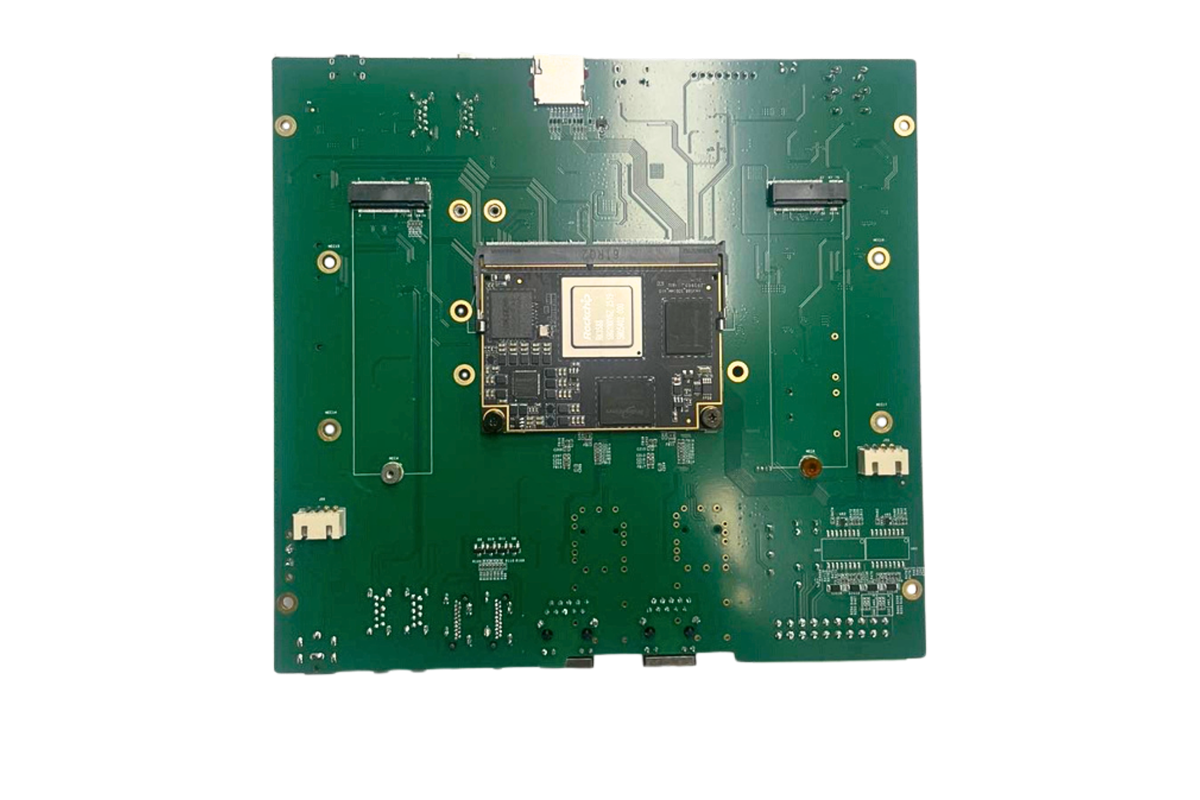
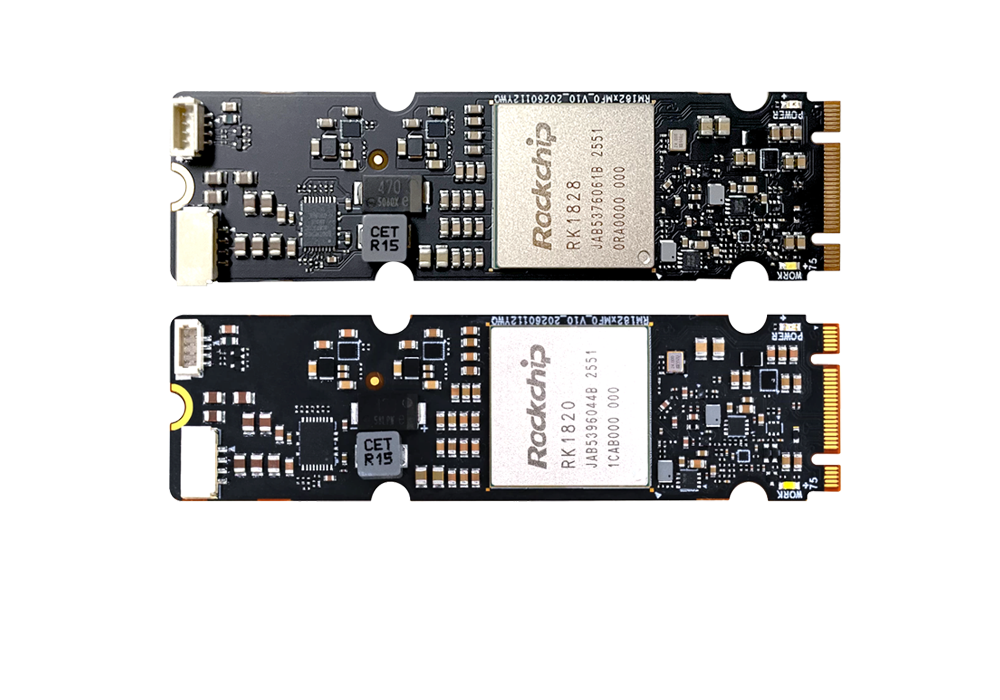
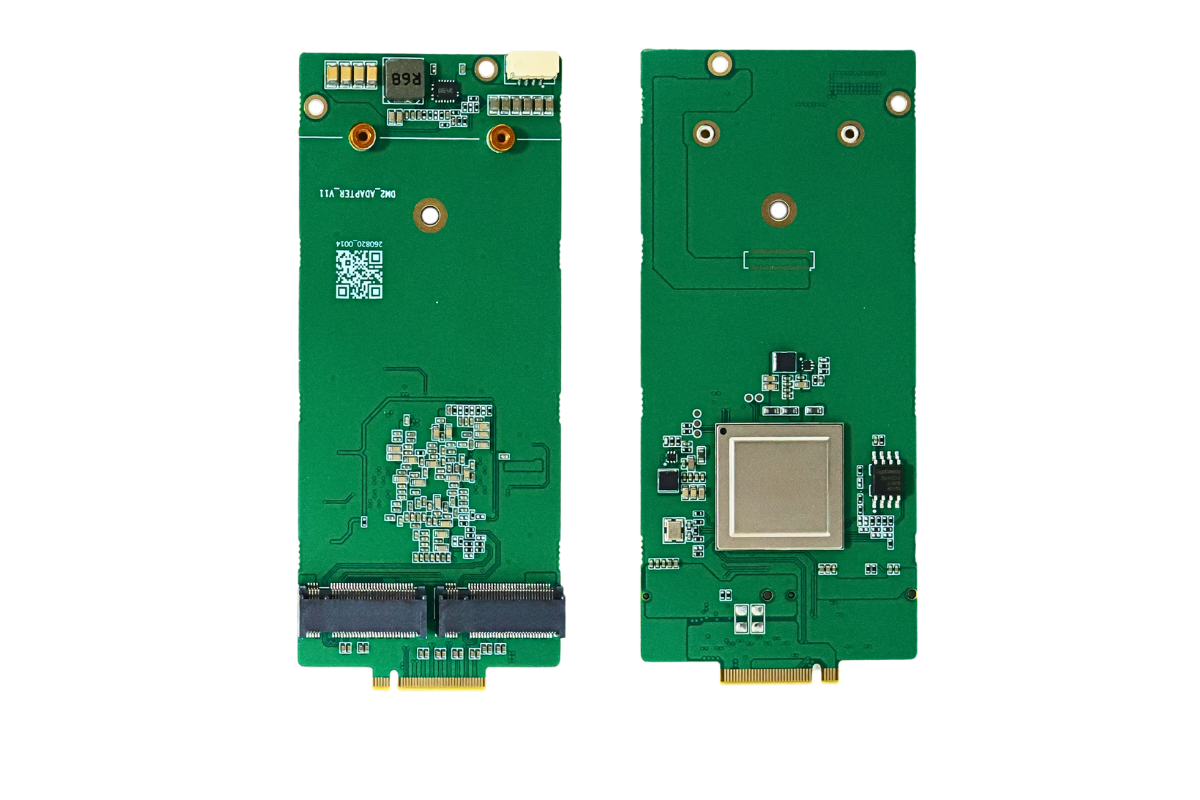


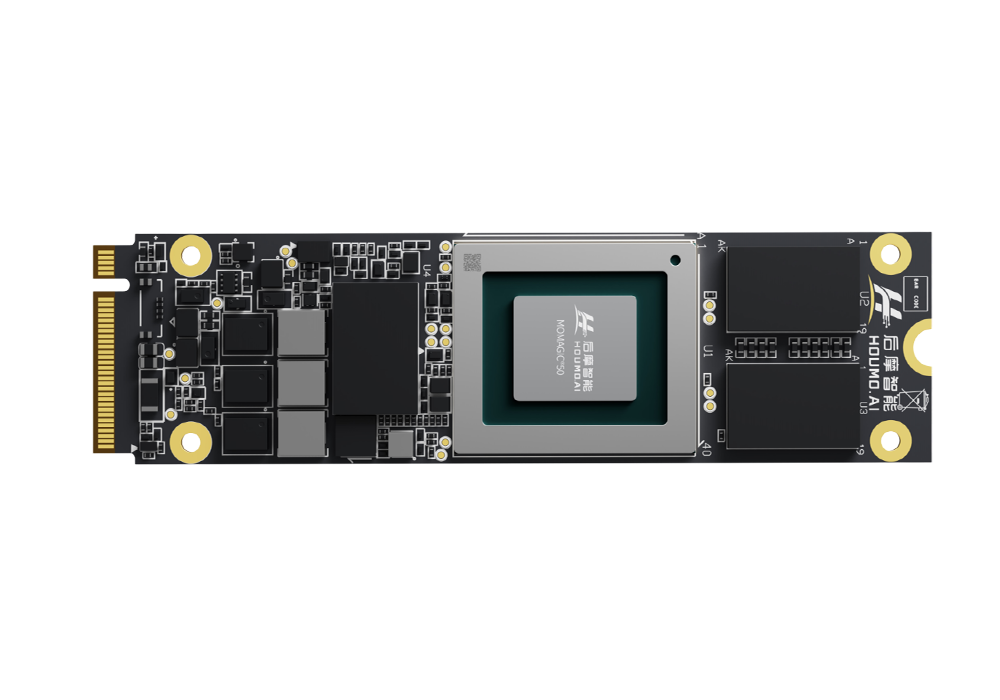
力擎LQ50 Duo是后摩智能双M50存算一体M.2算力卡,HM-Link是M50自研私有片间直连接口,用来解决同卡两颗M50、多卡级联时的张量通信瓶颈,绕开PCIe做芯片直传。
一、官方规格基线
LQ50 Duo板载2路HM-Link BTB,单路单向4GB/s,整卡双向合计16GB/s,PHY速率对标PCIe Gen4(16GT/s)
定位:芯片→芯片直连,不是PCIe转发;双芯在同一张M.2卡内部优先走HM-Link,做大模型张量并行、KV共享
扩展:支持多张LQ50 Duo卡通过HM-Link BTB级联组网,构建多M50算力集群
二、实测要点(工程实测口径)
✅ 带宽实测
同卡双M50之间HM-Link:有效单向约3.6~3.8GB/s,协议开销很小;双向跑满合计接近14.5GB/s,远高于M.2 PCIe Gen4 x4的双向可用带宽
对比对照组:如果不走HM-Link、全部走PCIe Host中转,双芯通信带宽掉到1.8GB/s以内,token分发、KV缓存同步会明显掉速
多卡级联(卡间HM-Link对接):链路损耗小幅上升,单向稳定3.2~3.5GB/s,适合小集群推理扩展
✅ 延迟实测(用户态乒乓测试)
短报文(64B)单向RTT:280~350ns
大块张量(64MB)传输:带宽饱和后,单趟传输延迟稳定在17us左右
对比:同环境PCIe Gen4 x4转发通信RTT普遍 >1.2us,HM-Link在小包高频通信优势巨大,非常适合MoE路由、动态KV分片
✅ 模型推理收益实测
测试模型:Qwen-14B、Qwen-32B bFP16 拆分张量并行
1. 关闭HM-Link(双芯走PCIe中转):14B推理约32~36 token/s
2. 开启HM-Link片间直连:14B推理提升至 48~54 token/s;32B拆分双芯可稳定跑到22~26 token/s
3. 特征:上下文越长、KV跨芯片交换越频繁,HM-Link增益越明显;短上下文模型增益相对有限
✅ 功耗与稳定性
HM-Link链路开启时,整卡功耗增加1.2~2.1W;链路休眠可自动关闭SerDes省电
长时间烤机(72h连续推理):链路无CRC错包、无重传风暴;高温85℃边界,带宽下降约7%,属于可控范围
三、HM-Link vs PCIe 简单对比
项目 | HM-Link片间互联 | PCIe Gen4 x4(Host中转) |
理论单向 | 4GB/s | 4GB/s |
实测有效单向 | 3.6GB+ | 1.7~2.0GB/s |
小包RTT | ~300ns级 | >1.2us |
通信路径 | M50 ↔ M50直连 | M50→CPU→M50 |
适用场景 | 张量并行、KV共享、多卡级联 | Host下发权重、结果回传 |
四、局限与注意点
1. HM-Link是后摩私有互联,仅M50系列芯片互通,不能对接NVLink、CXL、UCIe;需要后摩大道SDK显式开启分布式推理
2. LQ50 Duo的HM-Link是板上BTB连接器,级联需要配套转接板/排线,原生M.2金手指不引出HM-Link
3. 它是面向推理优化的互联,不是训练互联,不适合大规模DDP训练
五、总结
LQ50 Duo这套HM-Link核心价值:把双芯通信从PCIe瓶颈里解放出来,用低延迟私有直连,在小小的M.2形态里撑起32B级大模型张量并行推理,是M50存算一体方案在端侧做大模型的关键设计。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部