
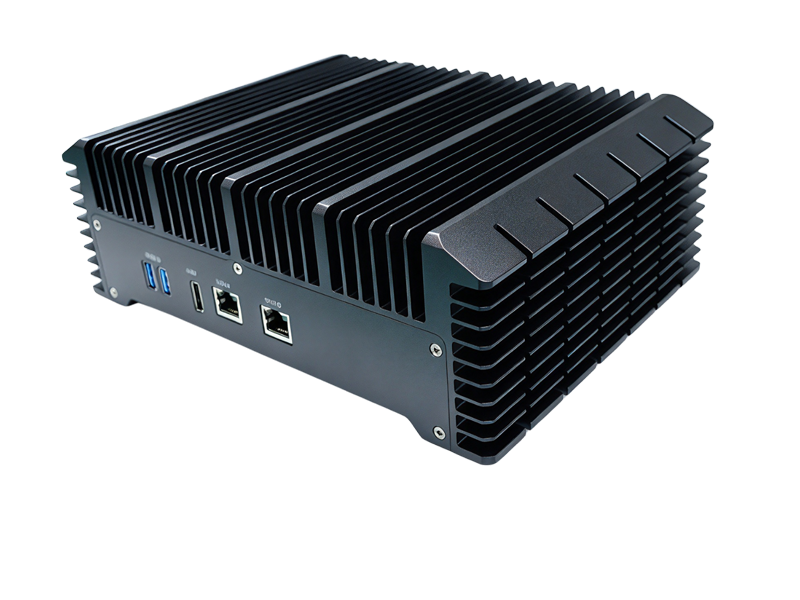
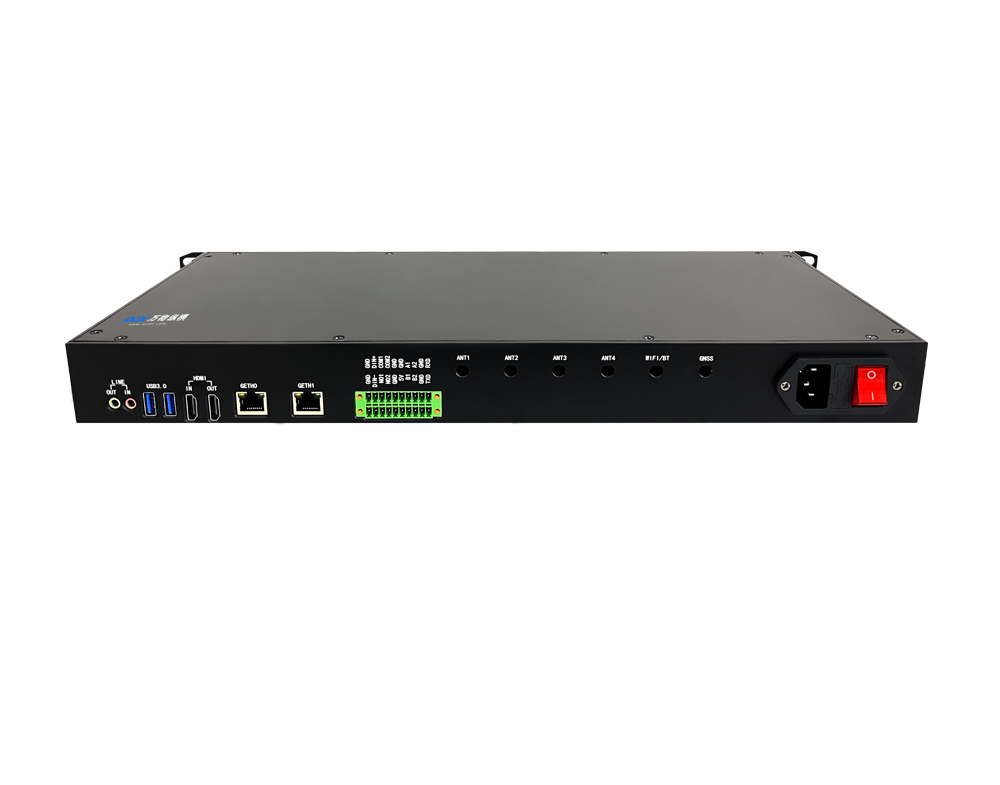
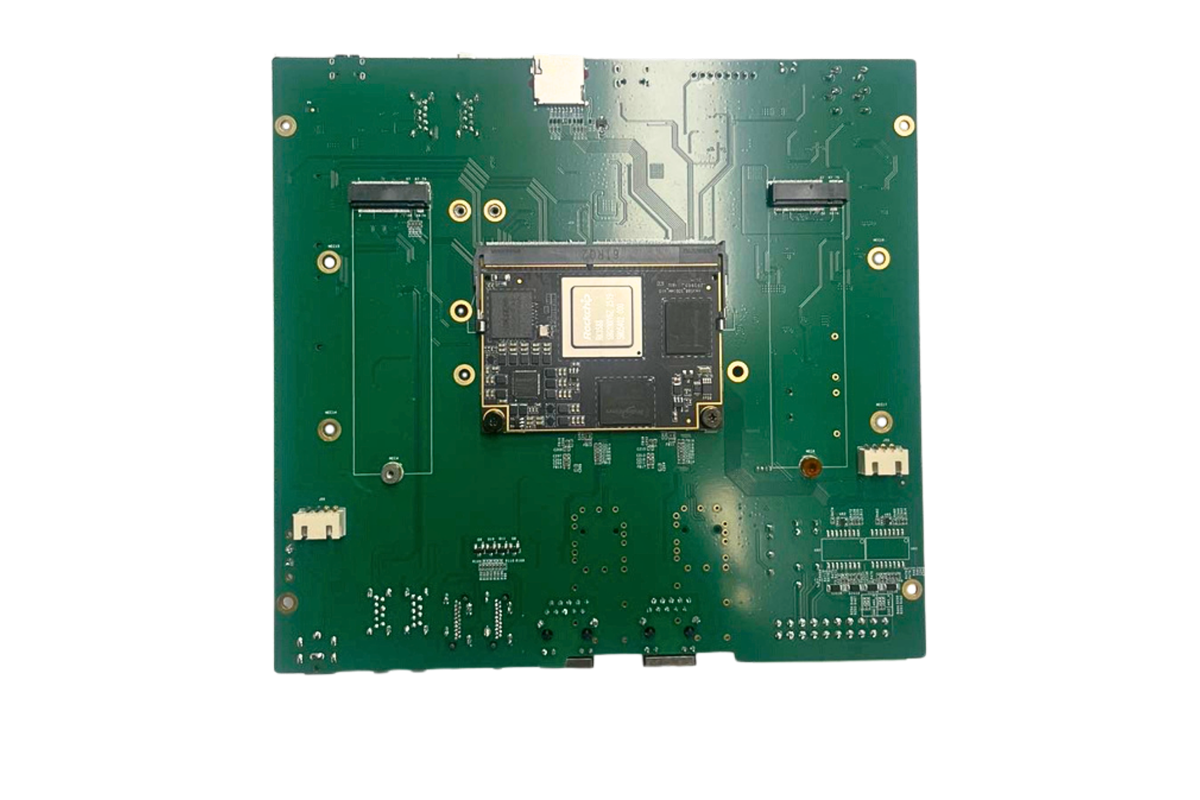


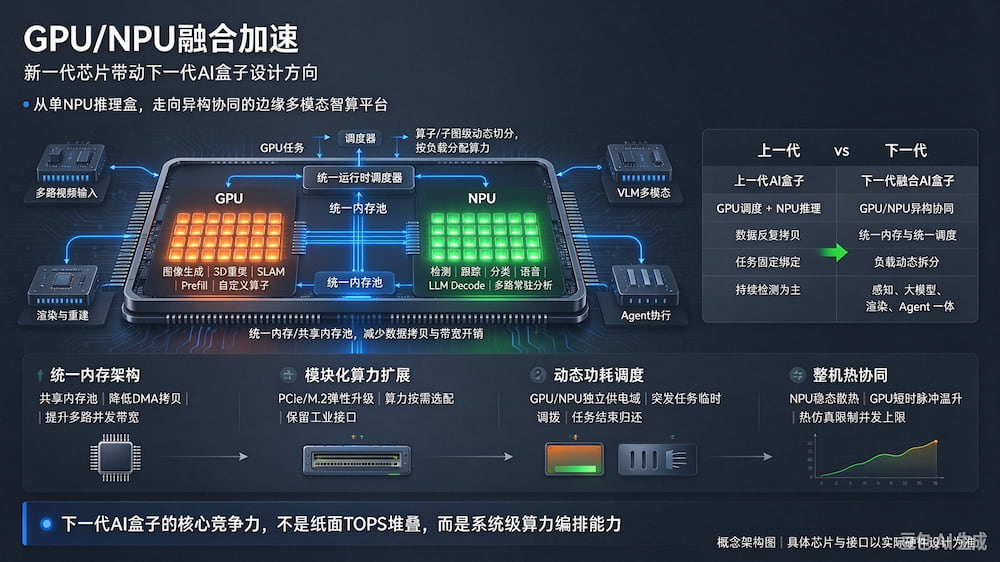
传统AI盒子大多是NPU独立推理+CPU做业务调度的分离架构;随着多模态、Agent、物理AI、本地渲染+推理混合负载普及,下一代AI盒子不再比拼单一TOPS,而是以GPU+NPU异构融合、统一内存/统一调度、负载动态拆分为核心设计主线,在有限功耗、体积、散热预算下,同时承接视觉编解码、3D渲染、VLM大模型、常驻检测、语音多模态流水线。
一、为什么要GPU/NPU融合,而不是分开跑?
NPU优势:张量阵列硬加速,低功耗、持续稳定跑检测、跟踪、语音唤醒、Decode解码等常驻轻/中量推理,适合长时间在线感知任务,能效高;短板是可编程弱、3D重建、图像生成、SLAM、渲染、复杂预处理管线吃力。
GPU优势:高并行通用计算,擅长Prefill填充、图像增强、三维重建、视频前处理、渲染、生成类任务、自定义算子;短板是持续跑小模型推理功耗偏高,长时间多路并发容易撞功耗墙、降频卡顿。
痛点(老架构):GPU、NPU各走独立内存,数据反复拷贝、PCIe来回搬运,带宽开销大、端到端时延高;任务固定绑定,GPU满载时检测流卡顿,NPU闲置时GPU算力又不够用,资源浪费严重。
融合价值:不是简单"一颗SoC里同时放GPU和NPU",而是架构层面打通共享内存池、统一运行时调度器,按算子/子图粒度自动切分负载:大模型Prefill、渲染交给GPU,持续检测、跟踪、Decode交给NPU,并行跑、减少数据搬移,提升整机吞吐、压低平均功耗。
硬件单元 | 擅长任务 | 典型负载 |
GPU | 高并行通用计算、图形渲染、生成类任务 | VLM视觉编码、图像生成、点云/三维重建、SLAM、8K编解码、模型Prefill、自定义CUDA/OpenCL算子 |
NPU | 张量阵列硬加速、低功耗持续推理 | 目标检测、分类、跟踪、异常识别、语音唤醒、LLM Decode、多路低码流常驻分析 |
CPU | 业务调度、协议栈、外设控制 | 协议栈、业务逻辑、外设控制、时间同步、安全管理、Agent规划调度 |
二、新一代芯片给AI盒子带来的架构路线分化
路线1:单SoC原生融合GPU+NPU
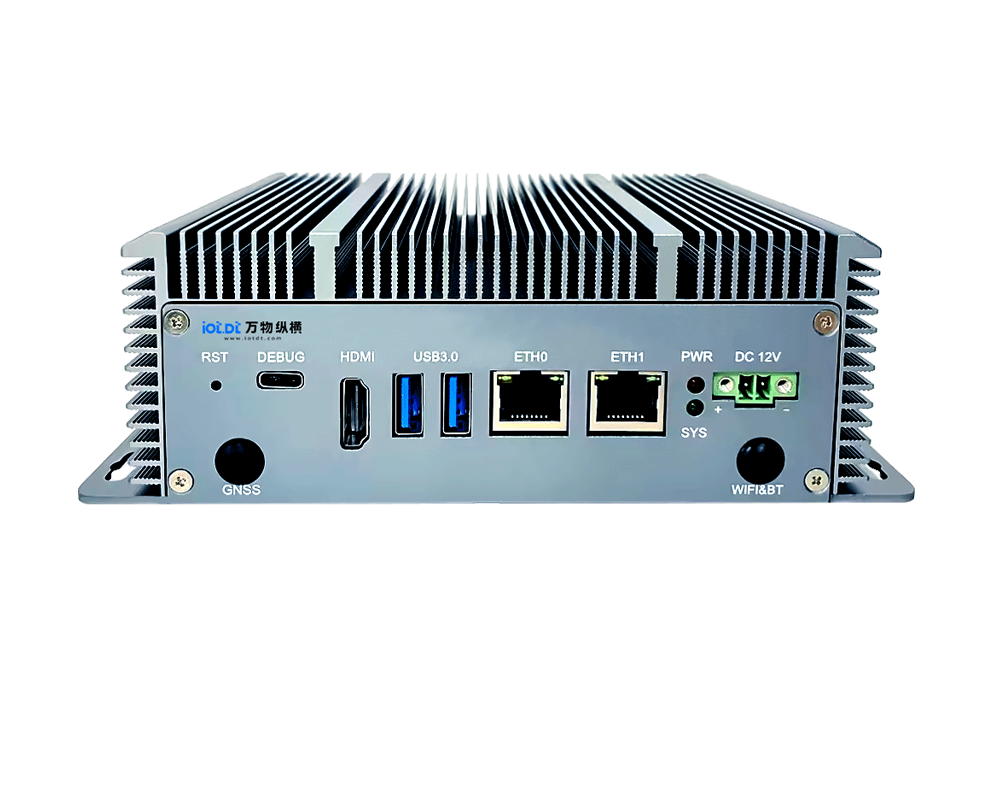
代表厂商:瑞芯微、AMD、Intel、新一代嵌入式SoC。一颗主控集成CPU+GPU+内置NPU,统一片上总线、共享LPDDR。适合小型轻量化AI盒子、本地Agent网关、智慧工位、家用智算盒。
优点:BOM低、结构紧凑、散热简单、开发链路短;
局限:算力上限固定,多路4K+7B/13B大模型并发容易触顶,扩展弱。
路线2:主控GPU + 独立NPU加速卡
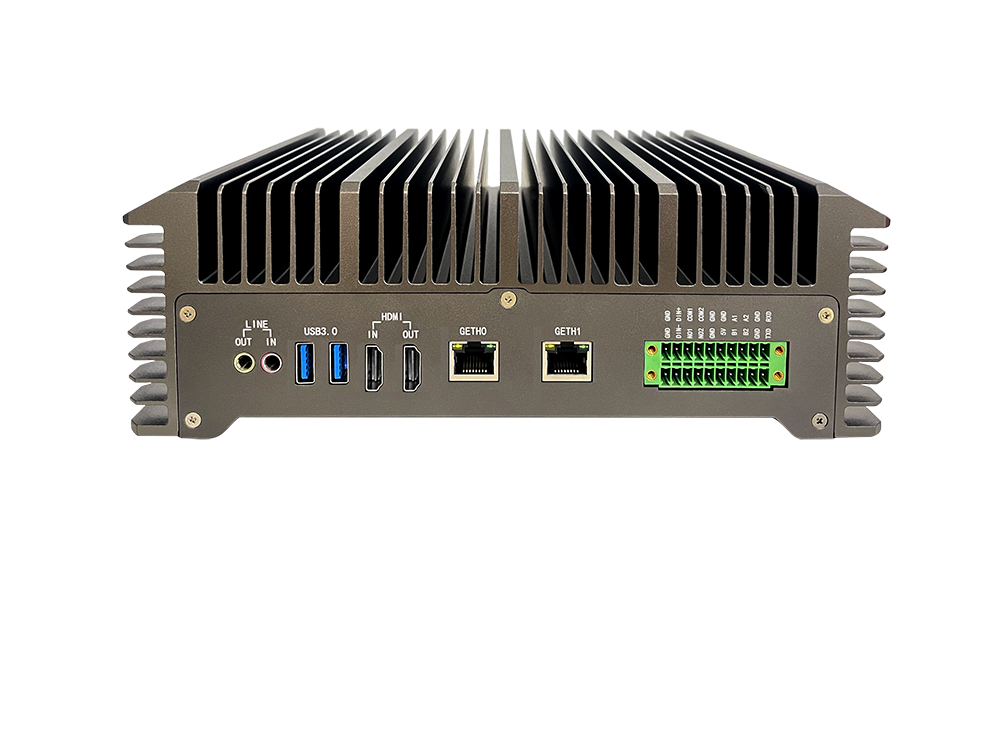
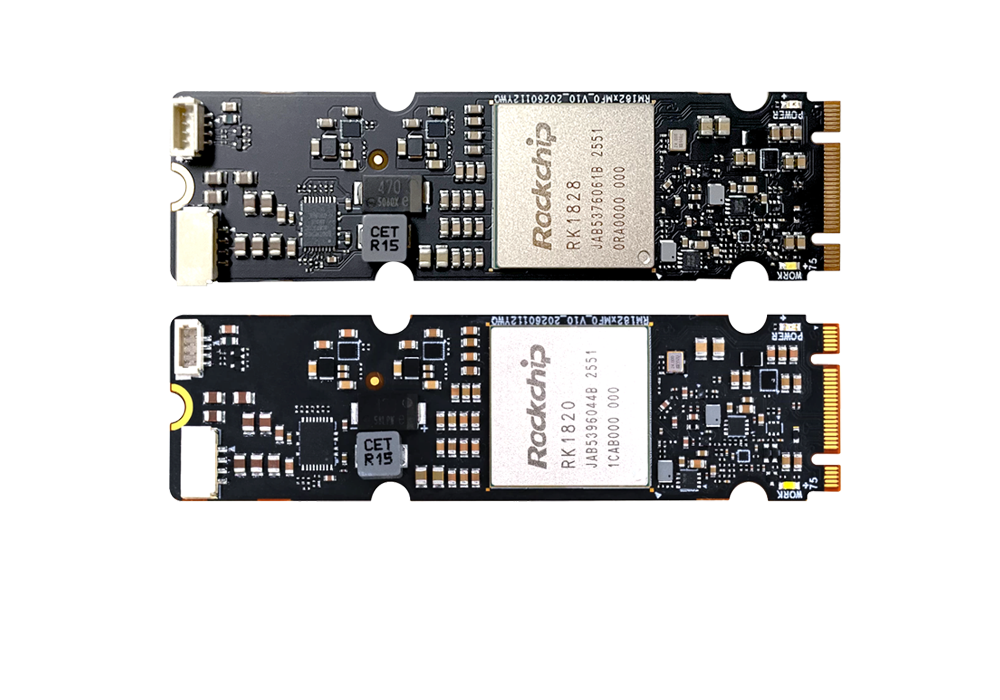
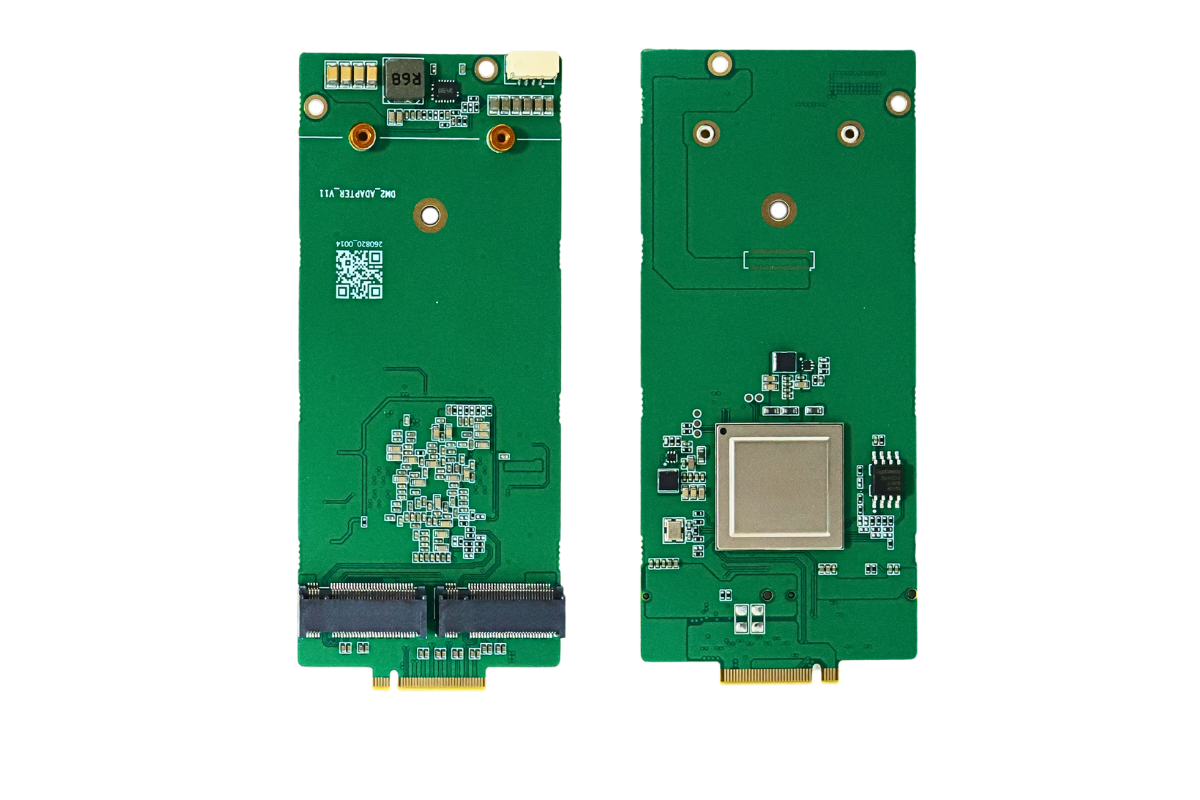
主控SoC自带GPU(Mali等)做视频预处理、渲染、Prefill,通过PCIe Gen4高速挂载独立NPU算力卡(后摩HM50、算能BM系列等),NPU专门承接大模型主推理、多路检测。也是万物纵横算力盒子主流路线。
优点:算力弹性扩展,可单卡/双卡堆叠;GPU与NPU分工清晰,适合工业质检、明厨亮灶、低空安防、智慧工地、私有化行业大模型;可以灵活选配算力,客户按需升级;
设计重点:瓶颈不再是TOPS,而是PCIe带宽、跨芯片数据流转、共享内存同步、电源分区、散热分区,防止互相抢功耗、互相降频。
路线3:GPU内置神经核
代表厂商:Imagination、部分国产GPGPU。GPU管线里直接嵌入Tensor神经单元,图形管线和AI张量单元共享寄存器与带宽,图形渲染、超分、AI推理在同一条流水线完成。面向物理AI、机器人、数字孪生本地节点,适合需要实时画面渲染+实时感知的场景。
三、下一代AI盒子硬件设计方向
1. 内存架构优先统一化,减少分片
优先支持统一内存/共享内存池,避免GPU、NPU、VPU各自独立DDR。多模态流水线(摄像头→预处理→VLM推理→结果输出)中间张量直接在共享内存流转,避免反复DMA拷贝;带宽指标比纸面TOPS更关键,多路4K场景带宽不足会直接拖垮整体延迟。
2. 模块化算力扩展,标准化高速接口
M.2 Key M PCIe4成为主流扩展形态,而不是传统PCIe长卡;盒子底板预留算力插槽,支持客户从单NPU升级到双芯多芯;同时保留工业接口:RS485、CAN、DI/DO、千兆/2.5G网口、PoE,兼顾通用AI与工业现场。
3. 分区电源+智能功耗调度(异构盒子最大坑)
GPU峰值功耗波动极大,NPU适合稳态功耗;电源设计做独立供电域,配合固件动态功耗预算管理器:业务轻时NPU满跑、GPU降频待机;突发生成/重建任务时,动态从NPU配额临时调拨功耗给GPU,任务结束归还;否则会出现"检测稳定,一开渲染就丢帧"。
4. 散热设计从单芯片散热升级为整机热协同
GPU是瞬时热源,NPU是持续热源;外壳、风道、导热垫分区设计,优先保证NPU长时间稳态温度不超限,GPU允许短时脉冲温升;无风扇工业款要做热仿真,限制并发上限。
5. 视频子系统深度和异构算力联动
内置VPU硬编解码和GPU/NPU流水线打通,多路摄像头流直接送异构调度器,不用CPU做中转;支持时间戳对齐,满足低空安防、轨迹追踪、工业质检时序一致性要求。
四、软件栈才是融合加速真正的门槛
很多硬件盒子卡在这一步。下一代AI盒子竞争力不在芯片,而在异构调度框架:
统一推理后端:一套模型自动子图切分,一部分算子落GPU、一部分落NPU,对上层应用透明;
模型流水线编排:支持多模型串联/并联(检测→跟踪→VLM理解→告警),不同子模型绑定最优硬件;
负载监控与QoS:区分实时任务(工业检测、低空跟踪)和尽力型任务(大模型问答、图像生成),优先保障硬时延SLA;
适配国产工具链:RKNN、Tengine、大道SDK、BMNNSDK等跨加速器协同,降低客户二次开发成本;
端边云协同底座:本地异构推理结果轻量化上云,模型热更新、算力池化调度。
传统盒子是"把模型丢给NPU跑";新一代融合盒子是系统级算力编排平台,一个盒子同时是视频网关、本地大模型服务器、3D感知节点、Agent执行单元。
五、核心落地场景变化
场景 | 融合算力需求 |
智慧工地/明厨亮灶 | 多路视频持续检测(NPU常驻)+ 异常画面VLM深度理解(GPU+NPU协同) |
低空安防 | 雷达+摄像头融合感知、点云处理、目标跟踪、轨迹推演 |
工业质检 | 实时图像预处理、缺陷检测、3D重建比对 |
本地Agent/行业私有化大模型 | 7B~34B模型本地跑,对话交互+现场视觉理解一体 |
机器人/物理AI盒子 | SLAM、渲染仿真、实时感知决策同步运行 |
六、总结
上一代 AI 盒子:多路视频检测盒子,主打 NPU、高路数检测、低功耗;
下一代 GPU/NPU 融合 AI 盒子:**边缘多模态智算盒子**,兼顾持续感知、本地大模型、三维渲染生成,面向 Agent 和物理 AI,算力可弹性扩展。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部