
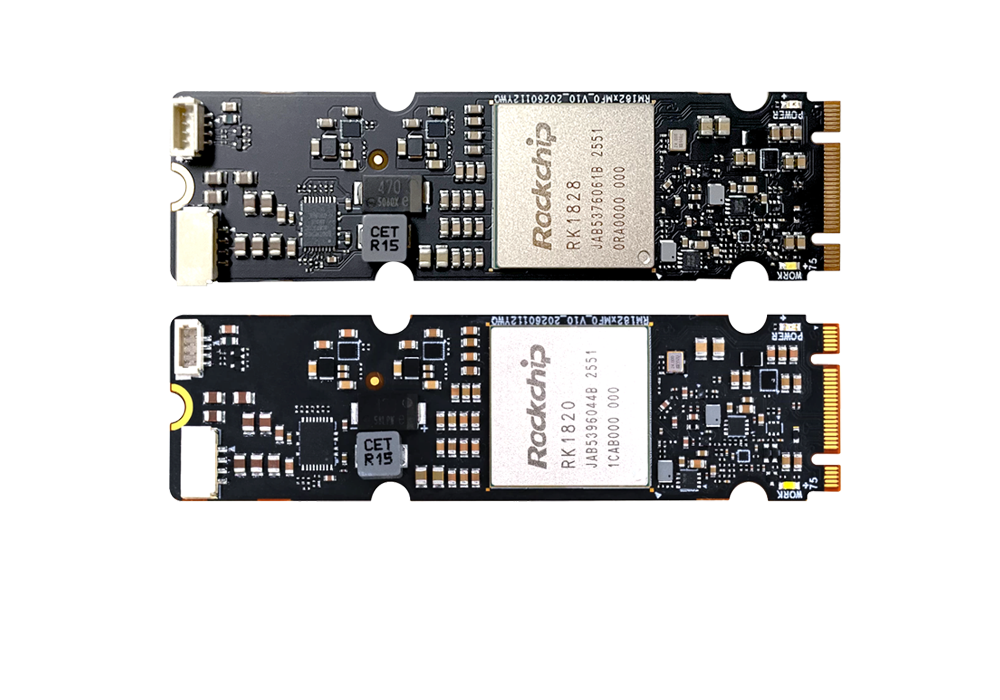
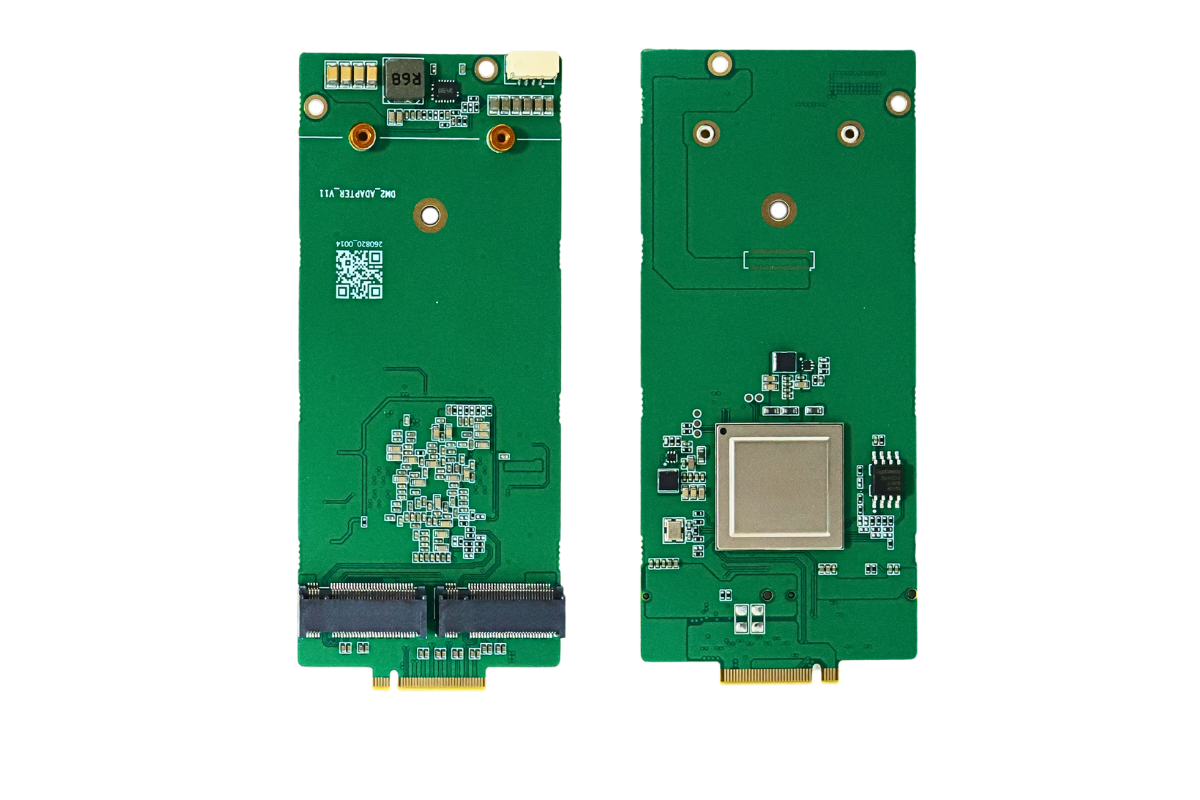


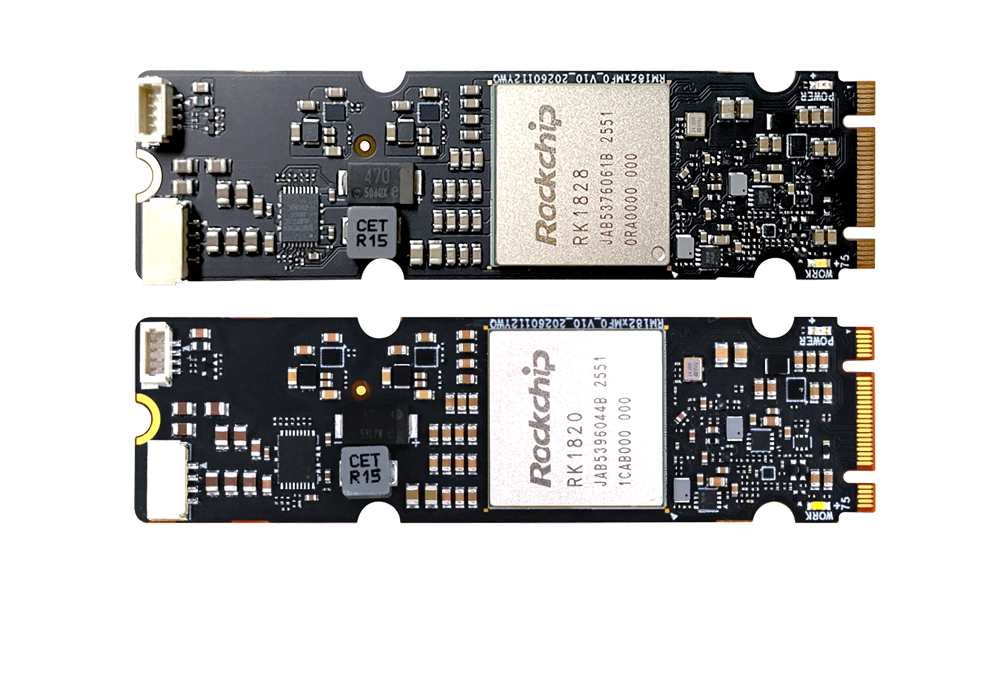
讨论对象:M.2形态国产算力卡(RK1828、LQ50 Duo、BM1688、后摩HM50存算一体等),聚焦L2缓存的定位、分配策略、访存通路、吞吐瓶颈、模型适配差异,区分「传统缓存架构NPU」和「存算一体CIM架构」两套完全不同的访存范式。
一、核心概念边界
1.1 传统NPU(瑞芯微RK1828、算能BM1688、力擎LQ50 Duo)
遵循经典分层存储:寄存器 → L0/SPM(片上私有暂存) → L2 Cache(片上共享二级缓存) → HBM/DDR(片外主存)
L2是标准高速缓存Cache:带Tag、一致性、替换策略(LRU为主)、硬件预取
作用:缓存片外主存热点权重/特征图,降低DDR访问频次、掩盖访存延迟
计算单元(MAC)和存储是分离的:计算在NPU阵列,数据从L2搬运到计算单元
1.2 存算一体CIM(后摩HM50这类M.2存算一体算力卡)
核心:计算嵌入存储阵列内部,没有传统意义上独立的、大容量的L2 Cache
阵列本身就是存储+乘累加单元
片上一般划分为:CIM阵列存储(权重常驻)、少量共享SPM/Buffer、极小的旁路缓存
不存在传统Cache的Tag查表、Cache Miss、缓存替换这套机制
很多文档里提到的"等效L2"是软件视角等效缓存区,不是硬件Cache
一句话本质差异:
✅ 传统NPU:算存分离,L2是搬运缓冲层,用来减少去DDR的次数
✅ 存算一体CIM:算存融合,权重放在计算阵列里,访存瓶颈从权重读取变成特征流吞吐
二、L2缓存策略逐项对比
对比项
| 传统M.2 NPU(RK1828 / BM1688 / LQ50 Duo) | M.2存算一体(HM50) |
硬件L2形态 | 硬件原生L2 Cache,带Tag、缓存一致性、LRU替换 | 无硬件L2 Cache;只有全局共享Buffer/SPM,软件管理 |
L2容量 | 固定硬件规格,比如RK1828大L2共享、BM1688分Bank L2 | 没有Cache容量;SPM一般很小,KB~MB级 |
数据存放偏好 | 热点特征图、频繁复用权重放在L2;冷数据下刷DDR | 权重固化在CIM阵列内;特征图在SPM和片外DDR流转 |
Miss行为 | Cache Miss触发DDR回填,有命中延迟开销 | 不存在Cache Miss;但存在阵列调度冲突、特征流阻塞 |
预取机制 | 硬件自动预取 + 编译器软件预取配合 | 无硬件Cache预取;依靠编译器切片、流水线调度特征流 |
多核心共享 | L2多为多核共享,支持Bank拆分、分区隔离,可静态/动态划分 | CIM阵列按Tile划分,每个Tile独立计算;共享Buffer是全局流缓存 |
调度主体 | 硬件Cache自主管理,编译器做辅助优化(tiling分块适配L2大小) | 完全编译器/驱动显式管理,软件手动切分特征图、控制数据流 |
带宽收益 | L2命中获得极高片上带宽,规避DDR带宽天花板 | 权重读取几乎不消耗外部带宽;瓶颈转移到Feature Map输入输出 |
短板 | 权重反复随机访问容易击穿L2,频繁Miss,性能跳水 | 权重不能动态随机切换;切换权重需要重写CIM阵列,开销很大 |
模型适配偏好 | CNN、LLM、多模态VL,权重动态切换友好 | 适合固定权重推理、视频结构化、YOLO固定部署;动态大模型切换代价高 |
三、访存逻辑深度拆解
3.1 传统NPU访存链路(L2为核心缓冲)
DDR → [L2 Cache] → L0/SPM → MAC阵列计算
工作流程:
1. 编译器对模型做tiling,把特征图、权重切成适配L2容量的块
2. 运行时硬件优先在L2查找数据,命中直接送到计算单元
3. Miss时,DMA从DDR搬运一块数据填充L2,按LRU淘汰旧块
4. L2是透明缓存:算子不用关心缓存,硬件自动维护
工程痛点:
L2容量是硬上限;大模型KV缓存、大分辨率特征很容易打满L2,命中率暴跌
不规则访存(稀疏、动态Shape、LLM随机KV读取)会严重拉低L2命中率
M.2卡普遍配DDR而非HBM,DDR带宽本身不高,L2命中率直接决定整机吞吐
RK1828 / LQ50优化点:支持L2分区锁定(lockdown),把KV、核心权重锁在L2,禁止替换,适合LLM推理。BM1688是多Bank L2,支持并发访问不同Bank降低冲突。
3.2 存算一体HM50访存链路(无L2 Cache范式)
DDR → [共享Feature Buffer(等效软件L2)] → CIM阵列(权重+计算)
工作流程:
1. 部署阶段:把模型权重烧录/写入CIM存储阵列,权重常驻阵列
2. 推理阶段:只需要持续往阵列送输入特征、读出输出特征
3. 权重读取几乎不消耗片外带宽,这是CIM最大优势
4. 那个少量共享Buffer,只缓存特征图,不做自动缓存替换;Buffer满了必须软件阻塞或者分片
核心代价:
权重切换昂贵:换模型、换权重,需要改写CIM阵列,耗时远高于传统NPU从DDR加载权重进L2
不适合权重频繁变化的场景(RAG动态LoRA、在线微调、多模型快速轮询)
特征流成为新瓶颈:如果特征图吞吐跟不上阵列算力,CIM MAC会空转,算力利用率上不去
行业最容易混淆的点:很多厂商白皮书里写的"等效L2",是把这片Feature Buffer类比传统NPU L2,不是硬件Cache。
四、L2策略带来的工程选型差异
场景1:固定场景高吞吐推理(工地AI、明厨亮灶、YOLO、多通道视频分析)
存算一体HM50优势明显
权重固定,一次烧录长期跑;权重带宽开销归零;只要特征流水线跑顺,能效比远超同功耗传统M.2 NPU;不需要操心L2命中率调优。
场景2:大模型、多模态、多模型轮询、动态LoRA、Agent本地推理
传统NPU(RK1828、LQ50 Duo、BM1688)更稳妥
依靠L2缓存+DMA动态加载权重、KV缓存;支持快速切换模型;配合L2 lockdown锁定KV,优化LLM decode;软件生态成熟,Tiling工具链完善。
场景3:混合部署(多路视频 + 按需调用大模型)
折中方案:
视频结构化任务交给CIM卡跑固定YOLO
LLM/VL交给带硬件L2的传统NPU
难点:两套访存模型完全不同,推理框架要分别做算子适配,不能一套tiling逻辑通用
五、容易踩坑的共识误区
误区 | 纠正 |
❌ 存算一体有更大的L2缓存
| ✅ 没有硬件L2 Cache,只有小容量特征Buffer;它省的是权重访存,不是特征访存。 |
❌ CIM不存在访存瓶颈 | ✅ 瓶颈转移,从"权重DDR带宽"变成"特征图输入输出带宽+阵列调度延迟"。 |
❌ 传统NPU L2越大性能一定越强 | ✅ L2命中率优先;如果算子访存模式随机,再大L2命中率也会很低,收益有限。 |
❌ L2 lockdown是CIM技术 | ✅ L2锁定是传统分离式NPU的缓存管理特性,用来阻止关键数据被LRU替换。 |
六、编译器优化方向差异
传统 NPU 编译器(RKNN、Tengine、Sophon SDK):核心目标是提升 L2 命中率,自动 tiling、重排访存顺序、做 L2 锁区、预取调度;
存算一体编译器(后摩工具链):核心目标是特征流流水线打满,做特征分片、乒乓 Buffer、阵列 Tile 映射,尽量减少阵列 idle,权重布局在部署阶段一次性完成。
七、总结
传统M.2 NPU的L2 Cache,是一套硬件自动管理的、兼顾权重+特征的缓冲层,牺牲一部分面积换取访存灵活性,适合动态多变的AI任务;
HM50这类M.2存算一体,直接取消了这套硬件L2缓存机制,把计算下沉到存储阵列,换取极致的权重读取能效,但丧失了动态缓存调度能力,适合固定权重的规模化推理。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部