
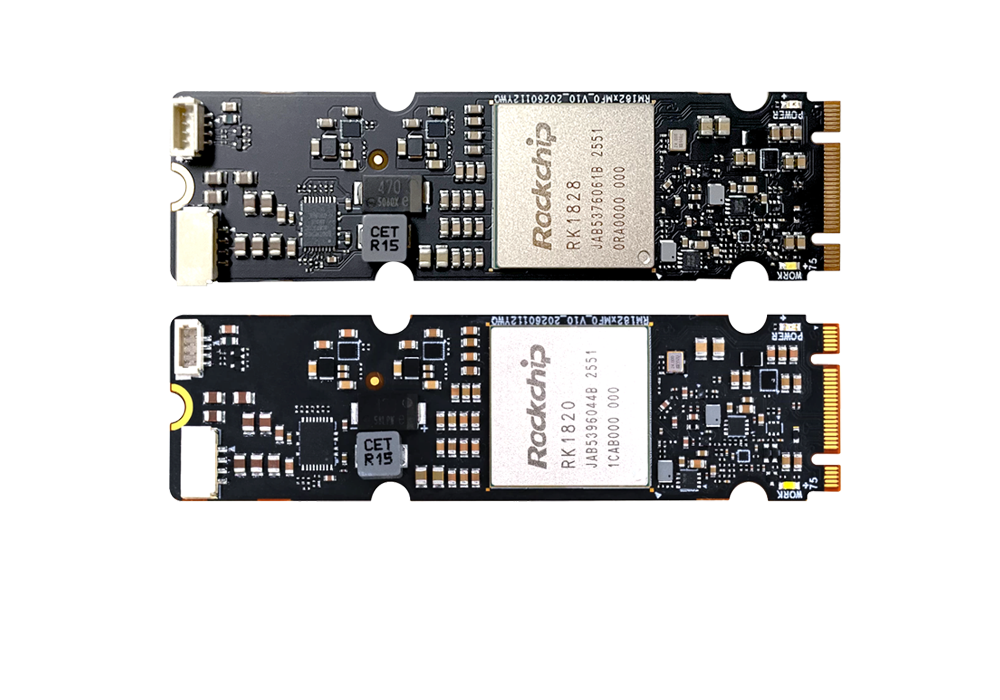
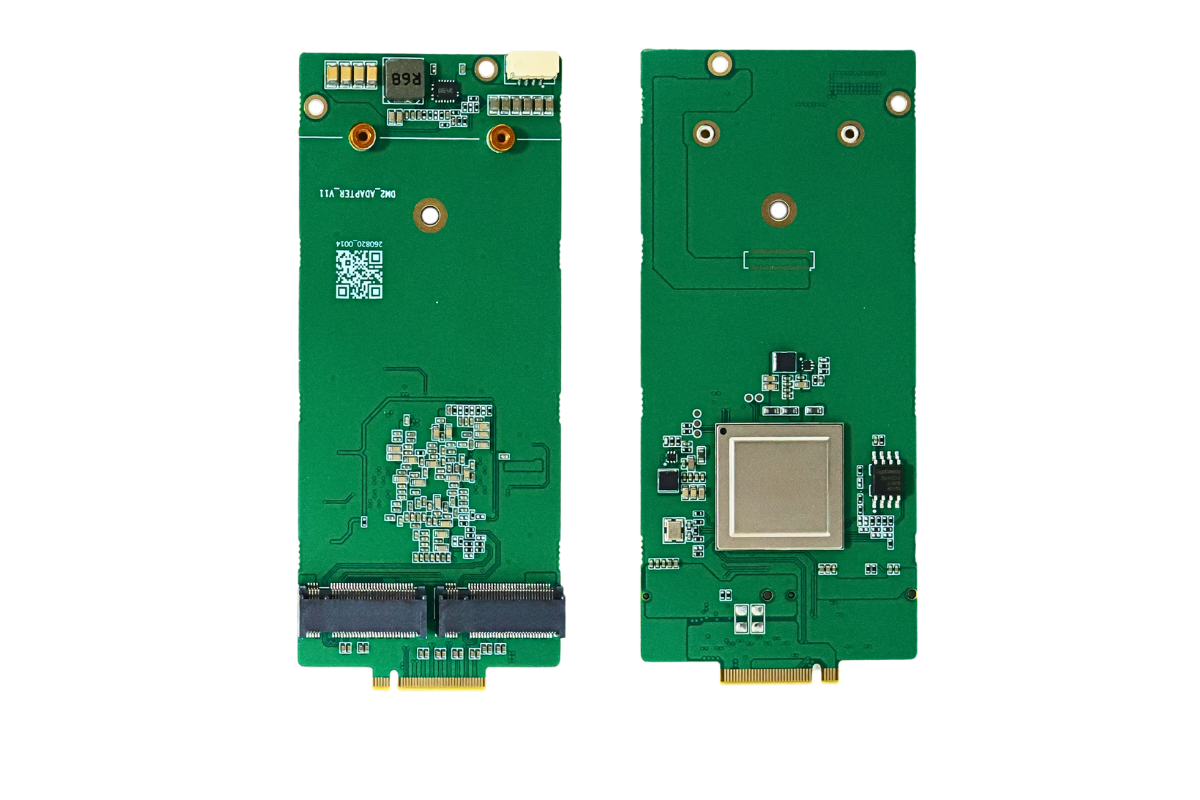


M.2 2280形态的边缘AI算力卡,已经明显走出两条截然不同的商业化路线:瑞芯微RK1828主打"稳、快落地",靠成熟工具链与主控生态抢占量产市场;后摩LQ50 Duo以存算一体原生架构为核心,瞄准高带宽、大显存、长上下文的下一代推理需求,二者不是简单的算力对标,而是底层设计哲学的分叉。
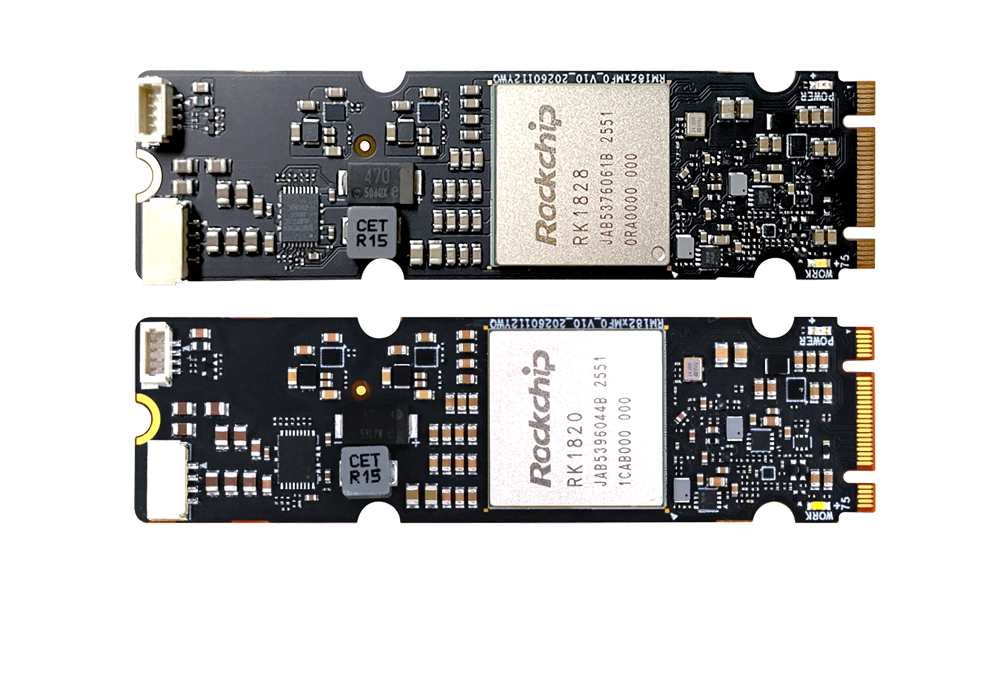
RK1828:协卡定位,生态优先,主打规模化落地
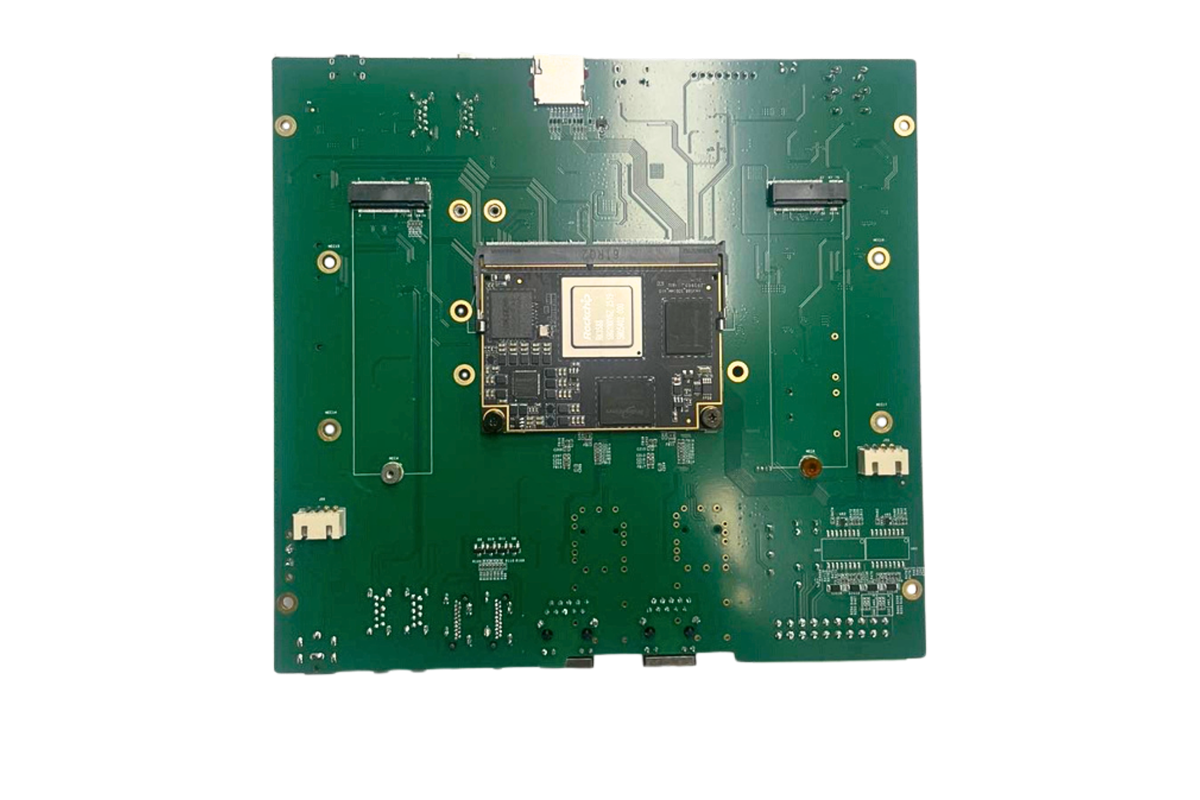
RK1828是主控+协算卡思路下的3D堆叠NPU,M.2 Key-M、PCIe2.0,单卡20TOPS@INT8,板载5GB堆叠片上DRAM、带宽1024GB/s,典型功耗5W,宽温工业规格,适配RK3588/RK3576等瑞芯微SoC做算力补盲,不抢主控CPU/视频编解码资源,推理业务解耦。
软件底座:RKN3 SDK + 丰富Model Zoo,原生适配Qwen、MiniCPM、DeepSeek、GLM Edge等主流LLM/VLM,YOLO系列、语音ASR/TTS、向量Embedding、RAG链路全部打通,支持OpenAI兼容接口、Python API,模型转换、量化、部署链路标准化,大量现成demo与行业方案,开发门槛很低。
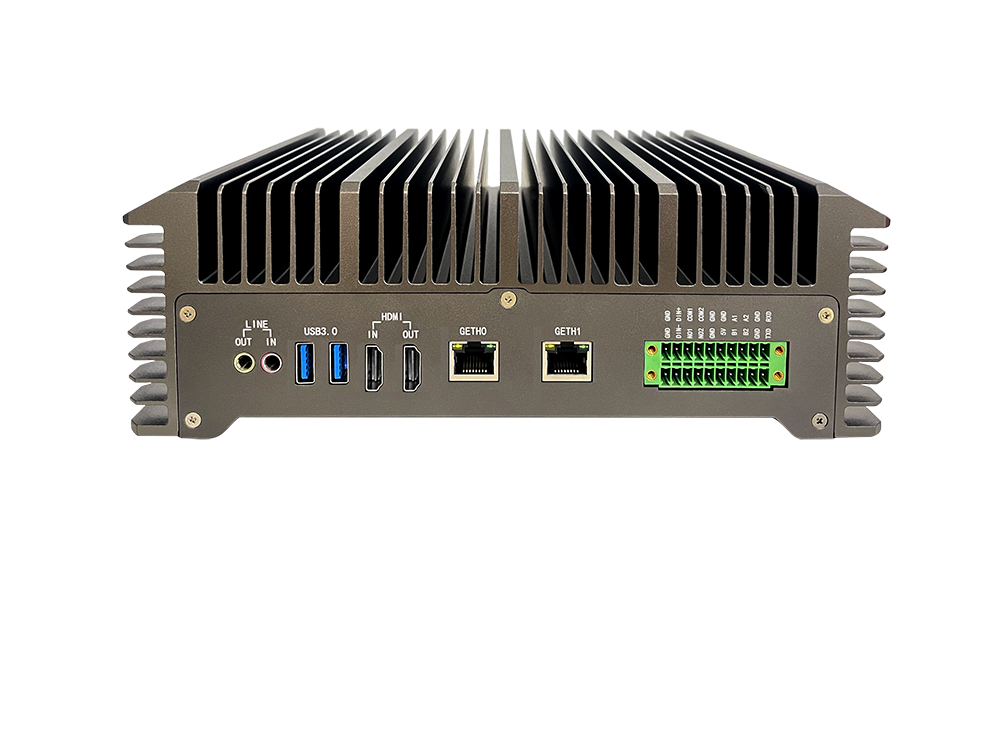
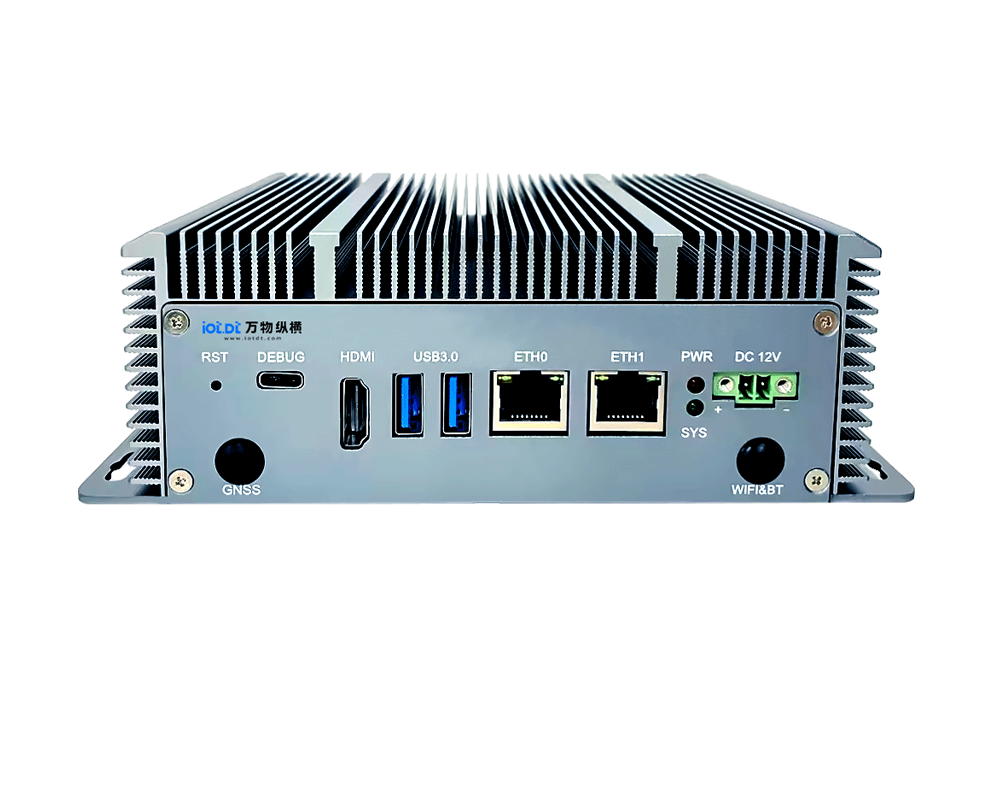
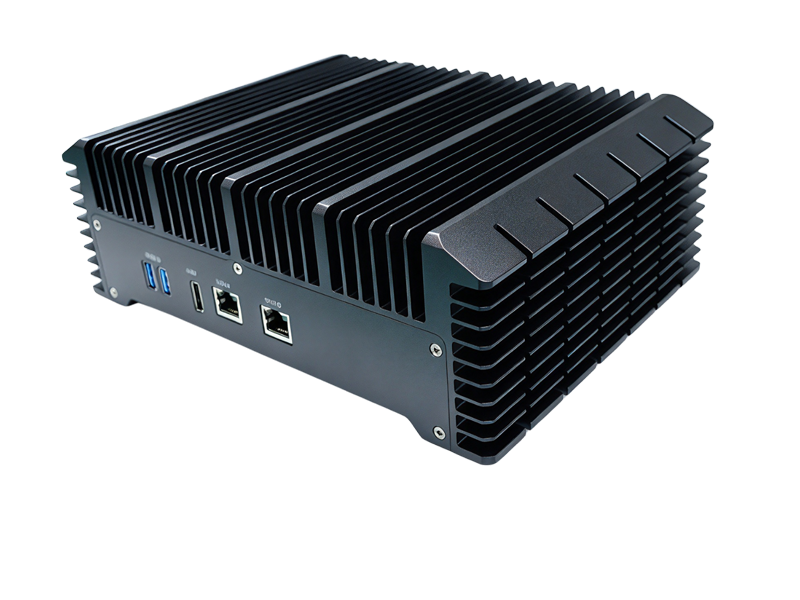
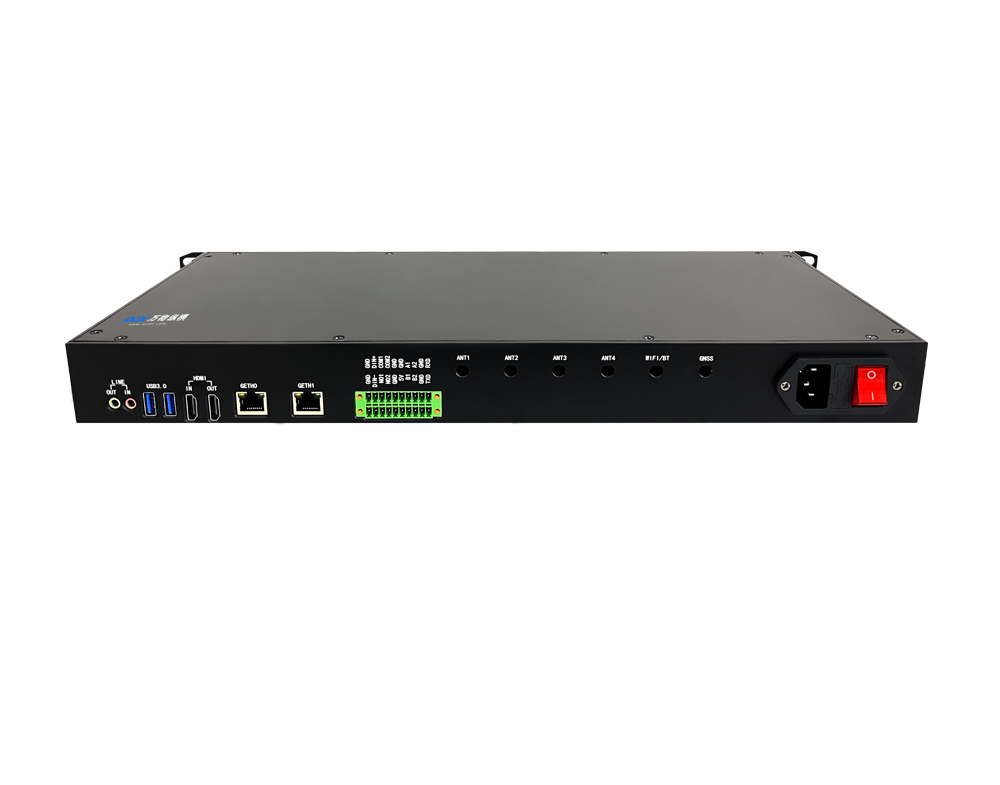
扩展能力:支持双卡、四卡级联,多卡拼接显存与算力,可本地跑7B~27B稠密模型,已经在AI盒子、NAS、巡检机器人、工业质检、私有化会议纪要、数字人场景批量导入,飞凌、Firefly、万物纵横等厂商都有成熟整机方案,客户基数大、供应链稳定、B端交付风险低。
路线取舍:它没有选择颠覆性新架构,而是在成熟NPU范式里把带宽、功耗、兼容性做到最优。优势是交付确定性强;短板是长上下文、超大batch场景下,依然受传统冯诺依曼访存墙约束。
一句话定位:给现有RK主控生态"加算力外挂",优先满足客户快速量产、快速做私有化本地AI的需求。
LQ50 Duo:双芯存算一体,赌访存革命,面向长上下文大推理
LQ50 Duo是后摩M50存算一体IPU的双卡M.2版本,PCIe Gen4,双M50芯片,板载最高48GB大显存,带宽307.2GB/s,典型功耗30W,原生存算一体架构,计算单元嵌入存储阵列,从架构上削减数据搬运开销,核心优势落在长上下文、大KV Cache、大batch多并发推理,这正是传统NPU最吃力的场景。
架构差异:传统NPU是"算存分离,数据来回搬运";存算一体直接在存储阵列里完成乘加,KV Cache、上下文窗口越大,能效优势越容易拉开,适合超长文档RAG、多轮Agent、大分辨率多模态连续输入这类高访存业务。
现状短板:生态还处在建设期,工具链、算子适配、模型调优、行业参考方案远不如RKNN成熟;开发成本、调试门槛更高,对散热、电源设计要求严苛(双热源独立温控),现阶段更适合愿意做底层适配、追求长期能效红利的项目,不适合追求快速上线的标准化产品。
路线取舍:放弃短期通用性红利,押注端侧模型持续变大、上下文越做越长的趋势。当7B/14B模型都普及32K、128K上下文时,访存开销会压倒单纯算力,存算一体的价值才会凸显。
一句话定位:面向下一代大模型推理的架构先行方案,适合愿意投入适配、看重长期能效的高端边缘项目。
核心对比简表
项目 | RK1828(瑞芯微) | LQ50 Duo(后摩) |
核心架构 | 3D堆叠NPU(冯诺依曼) | M50存算一体IPU双芯 |
接口 | M.2 2280 PCIe2.0 | M.2 2280 PCIe Gen4 |
单卡功耗 | 典型5W | 典型30W |
片上显存 | 5GB 3D DRAM | 最高48GB LPDDR5 |
主打场景 | 7B级、标准上下文、工业视觉、标准化AI盒子、机器人、NAS | 长上下文RAG、大KV Cache、多模态大batch推理 |
生态成熟度 | 高,RKNN3,大量落地案例、模型仓库 | 中早期,架构新,适配工作量更大 |
客户选型逻辑 | 优先稳定、快速量产、低成本B端标准化 | 优先极致访存能效、长上下文高端定制项目 |
赛道启示:不是谁替代谁,而是客户按场景二选一
1. 如果你做标准化边缘盒子、安防质检、本地NAS、轻量Agent、RK主控配套升级,优先RK1828:方案现成、工程师上手快、供应链成熟、风险可控,是当下商业主流。
2. 如果你主打私有知识库超长RAG、多轮复杂Agent、持续流式多模态输入,愿意投入软件适配换取更低的长上下文推理功耗,LQ50 Duo的存算一体路线更匹配长期需求。
3. 整个M.2算力卡赛道正在分化:一条走生态复用、兼容、量产优先的渐进路线;一条走架构创新、攻克访存墙的前瞻路线,二者会长期共存,分别收割不同周期、不同预算的边缘AI订单。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部