


核心问题:16TOPS INT8 算力的 BM1688,能否撑起 16 路视频解码与 AI 分析的高并发场景?
结论成立:1080P@25–30fps、单一轻量检测模型、INT8 量化、全硬件流水线四个条件同时满足时,可以跑满 16 路,这也是算能及生态厂商的统一标称口径。
硬约束在解码:解码上限 1080P@480fps 恰好等于 16×30fps,几乎没有冗余;编码只有 10 路,需要回传或录像时会出现新的上限。
变量在算法:换成中型模型、单路叠加多算法或改用 FP16,可用路数按倍数下降,工程经验区间约 4–8 路。
评估边界:路数与模型、帧率、分辨率强相关,本文给出的路数为工程估算而非实测,正式选型应以实际模型压测为准。
1. 硬件基线:解码带宽与算力都按 16 路规模设计
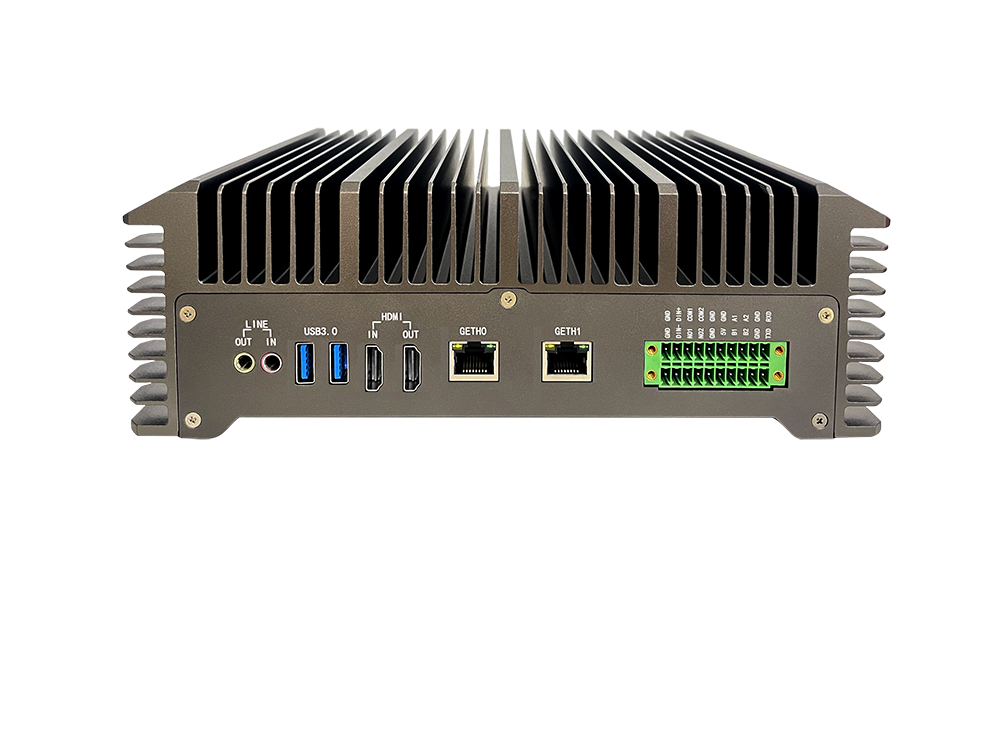
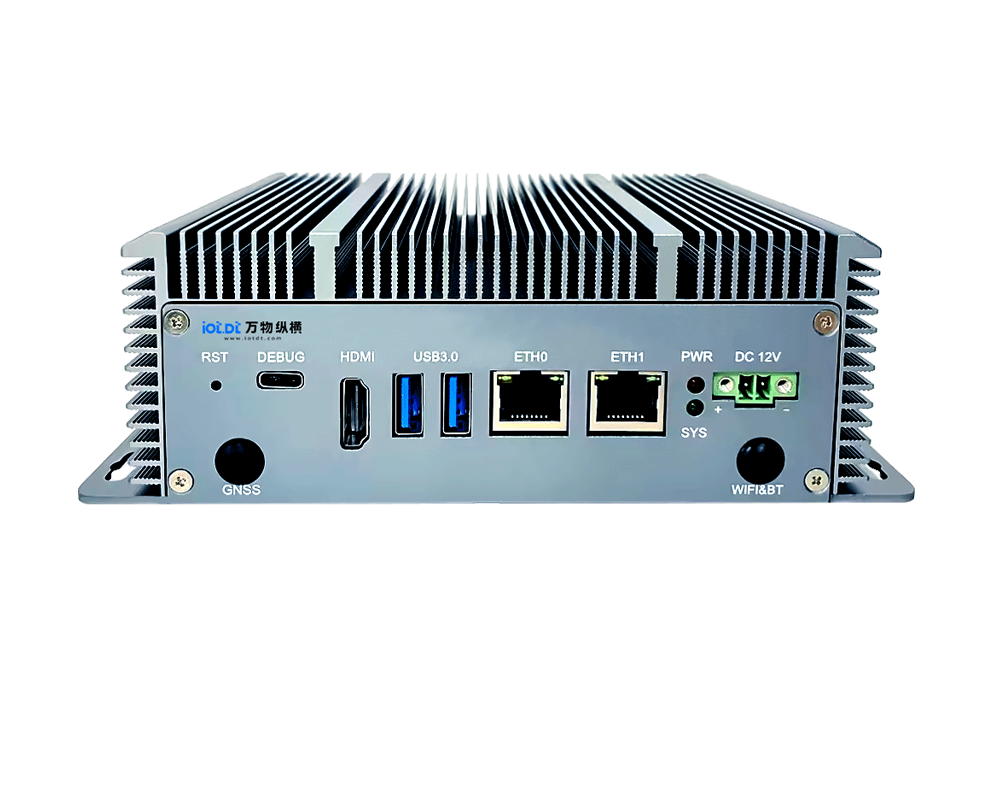
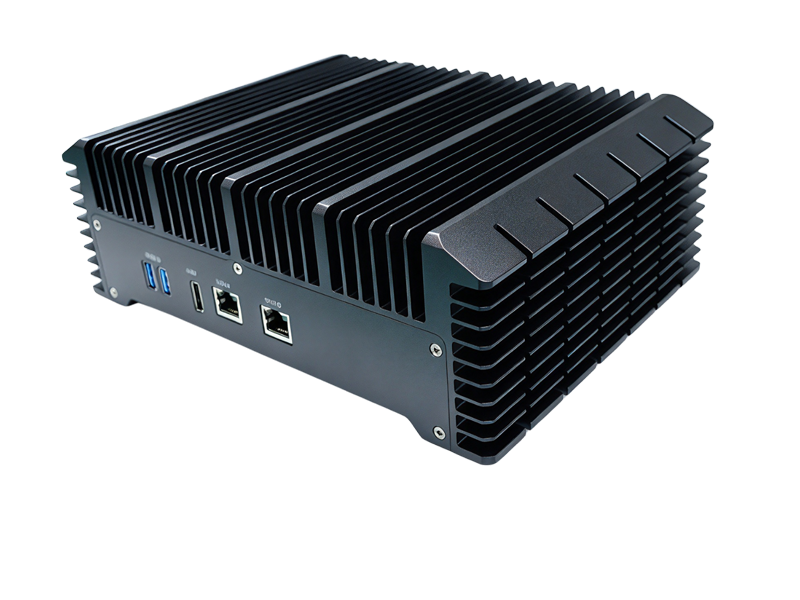
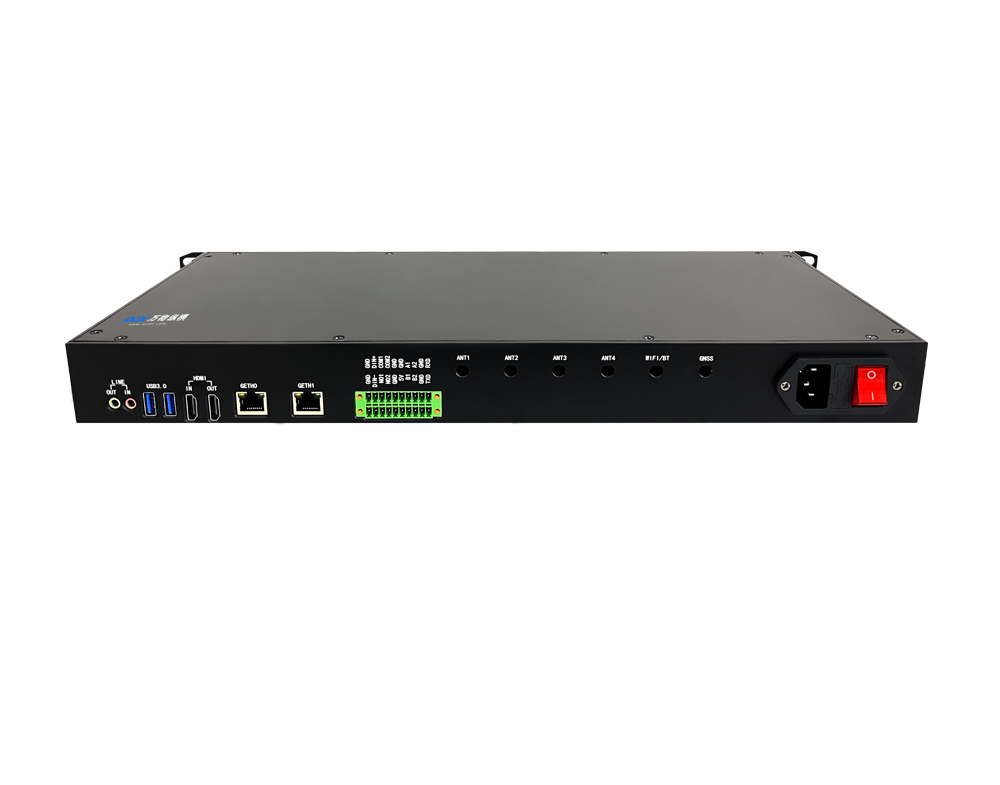
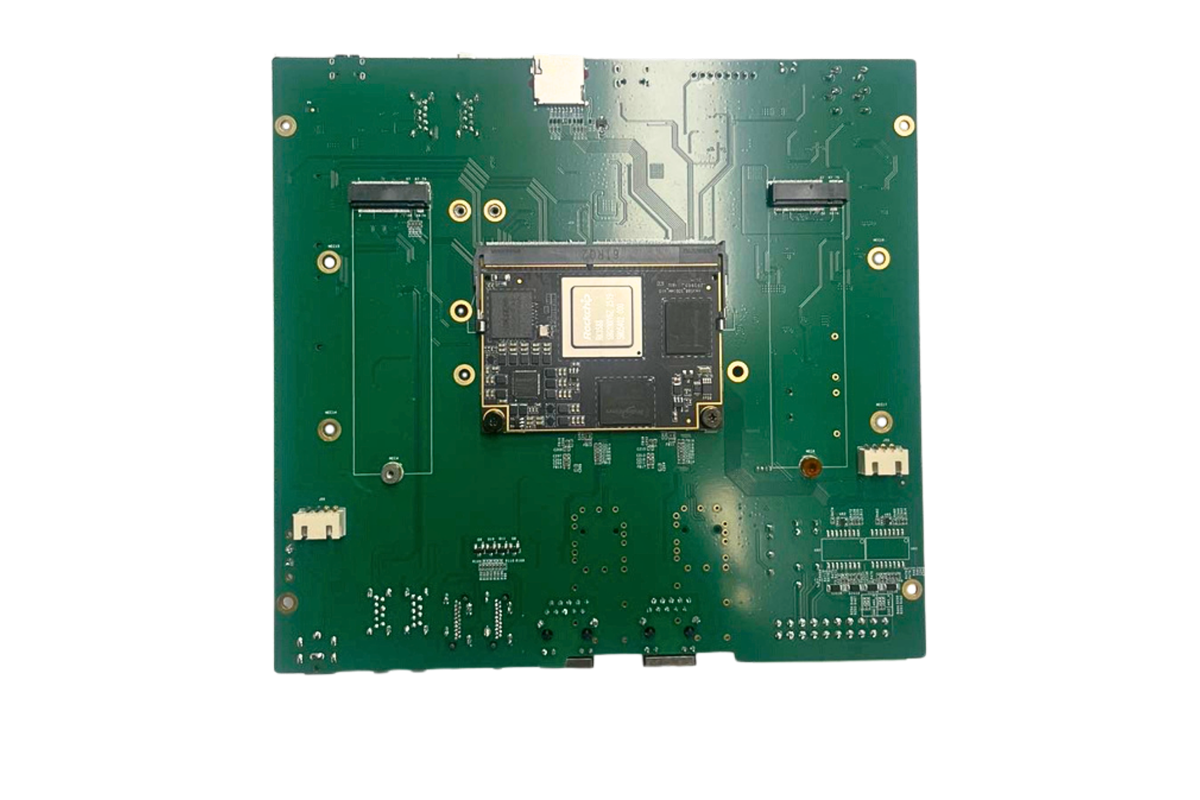
BM1688 的产品定位本身就是"按 16 路 1080P 全流程设计"的边缘视觉处理器,而不是先有算力、再倒推能跑几路的通用 SoC。算能在 SE9 微服务器、SM9 智算模组,以及 Firefly 的 AIBOX-1688、Core-1688JD4 核心板等整机与模组产品上,统一标注"支持 16 路高清视频智能分析,16 路全高清硬件解码与 10 路编码"[1][4],这意味着 16 路能力在硬件层面已有明确出处,不是第三方估算。
维度 | 官方规格 | 对 16 路并发的含义 |
主控 CPU | 8 核 ARM Cortex-A53 @1.6GHz | 算力之外最容易被忽视的瓶颈。图像缩放、归一化、后处理若放在 CPU 上做,8 核 A53 会先于 TPU 饱和。 |
TPU 算力 | 32T@INT4、16T@INT8、4T@FP16/BF16、0.5T@FP32 | INT8 是唯一能承载 16 路的精度档位;FP16 算力仅为 INT8 的四分之一。 |
视频解码 | H.264/H.265,最高 1080P@480fps 或 4K@120fps;16 路 1080P@30fps | 480fps 与 16 路×30fps 严格相等,解码端是"刚好够"而非"有富余"。 |
视频编码 | 1080P@300fps 或 4K@75fps;10 路 1080P@30fps | 若全量回传或本地录像,编码路数会先于分析路数触顶。 |
ISP 与 CV 加速 | 最多 6 路 sensor 输入;内置 IVE/VPSS、双目深度 DPU、图像拼接 Stitch、鱼眼展开 Dewarp | 网络摄像机走解码通路,不受 6 路 ISP 限制;只有 MIPI 直连多摄像头的方案要另算。 |
内存 | 8GB / 16GB LPDDR4,64bit 4266Mbps | 16 路缓冲队列与模型常驻同时占用,16 路场景建议选 16GB 版本。 |
解码没有冗余,是第一个需要警惕的地方。1080P@480fps 对应 16 路 30fps 正好用满,一旦业务还需要抽帧加密、双路码流、智能编码或叠加前端 4K 视频,就会先撞上解码墙,而不是算力墙。4K 侧同样如此:最高 4K@120fps,等价于 4 路 4K@30fps。
1. 能否跑满 16 路,取决于单路负载而非标称路数
官方"16 路"并不是"任意算法都能跑满"的承诺,它对应的是一个简单的不等式:单路算力占用×路数 ≤ 可用算力。因此判断具体项目能否落地,应先把单路每帧推理耗时折算成算力占用,再看总算力是否留有余量。只看 16TOPS 这个数字,很容易得出与实际相反的结论。
精度是第一道折算关口。TPU 在 INT8 下为 16TOPS,FP16/BF16 只有 4TOPS,同一模型改用 FP16 部署,可用路数直接降到约四分之一,这正是"账面 16 路、实测 4 路"案例最常见的成因[3]。第二道关口是模型规模:以轻量检测为基准,中型检测、分割、姿态等任务每帧耗时按倍数上升,路数随之成比例下降。下表按这两条折算给出常见配置的估算区间。
算法配置
| 精度 | 相对单路基准占用 | 可支撑 1080P@25fps 路数 | 主要约束 |
轻量单检测(YOLOv5s、YOLOv8n 一类) | INT8 | 1.0×(基准) | 16 | 解码带宽与 CPU 调度 |
中型检测(YOLOv8m 级 backbone) | INT8 | 约 2–2.5× | 6–8 | TPU 算力 |
实例分割、姿态估计 | INT8 | 约 2–4× | 4–6 | 算力与后处理双重占用 |
单路叠加 3 种算法(检测+抓拍+行为分析) | INT8 | 约 2.5–3× | 5–6 | 多模型算力线性叠加 |
轻量单检测 | FP16 | 约 4× | 4 | FP16 仅 4TOPS |
4K 输入、下采样至 1080P 推理 | INT8 | 约 1.0× | 4 | 受解码 4K@120fps 上限约束 |
表中"相对单路基准占用"是以 1080P@25fps 单路轻量检测为 1.0 的归一化估算,用于横向比较不同配置的算力压力,不代表具体模型的实测耗时;路数同样为按比例折算的工程估算。实际项目应对候选模型跑一轮 TPU 侧的单帧耗时测试(bmrt_test),再用"可用算力÷单路占用"复核,误差通常来自后处理与内存搬运,而非 TPU 本身。
1. 可稳定跑满 16 路的场景特征
官方标称口径对应的算法档位是"人、车、非机动车、物品识别,视频结构化,轨迹行为分析"[1],落到具体业务上,能够稳定跑满 16 路的情形有共同特征:单路只跑一种轻量模型,输入为标准 1080P,帧率不超过 30fps。
单种轻量目标检测:人车物检测、入侵检测、越界报警等基础安防任务,模型参数量小、推理耗时低,是全流程流水线下最容易跑满 16 路的档位。
小模型特征识别:人脸检测、车牌识别、安全帽/反光衣检测等单任务识别,通常与检测模型串联,但只要模型足够小,仍在 16 路能力范围内。
基础视频结构化:提取人车属性、颜色、方向、轨迹,属于官方明确列出的能力项,单路仅运行一种结构化算法时算力占用可控。
只解码不分析的纯转发:不做 AI 推理时,16 路解码本身没有算力压力,瓶颈转移到网络与编码;这类场景不构成对 16TOPS 的考验。
反过来说,只要出现"单路两种以上算法"或"模型换到中型以上"中的任意一项,就已经离开了 16 路的保证区间,应按上表的折算逻辑重新评估,而不是继续沿用厂商的 16 路标称。
2. 会先掉路数的四类变量
实际部署中,路数下降几乎都由以下四类变量触发,它们的共同点是都会改变"单路算力占用"这一项,而不是直接削弱硬件。
算法复杂度上移:从中型检测到实例分割、姿态估计、行为分析,单帧耗时成倍增加,16 路会迅速降到 4–8 路。这是最常见、也最难通过调优挽回的降容原因。
单路多算法叠加:同一路视频同时跑人体检测、人脸抓拍、行为分析,开销近似线性叠加。参照同架构产品在单路三算法下的表现,总路数会落到 5–6 路水平。
分辨率与帧率提升:4K 输入使单路像素量为 1080P 的四倍,解码侧先触顶(仅 4 路 4K@30fps);即便下采样后推理,路数仍受解码限制而非算力限制。
非 INT8 部署:使用 FP16/BF16 精度时 TPU 算力降到 4TOPS,可用路数约等于 INT8 的四分之一,量化没做好就上线,是"算力明明够却跑不动"的典型场景。
3. 让 16 路跑稳的五个工程动作
在上述条件已经满足、需要把 16 路稳定跑住的场景中,以下五项动作按优先级排列,前两项决定能否达到标称,后三项决定能否长期稳定。
必须使用 INT8 量化模型:通过 SOPHON SDK 的 TPU-MLIR 完成量化与编译,尽量采用对称量化与多核并行编译,把算力利用率拉到可接受区间。
预处理全部卸载到硬件:图像缩放、裁剪、颜色空间转换交给 VPSS/IVE,不要用 CPU 做 OpenCV 式处理,否则 8 核 A53 会成为先饱和的部件。
采用流水线而非串行调度:用 sophon-stream 一类框架把解码、预处理、推理、后处理拆成多线程流水线,避免各阶段互相等待造成空转。
预留 10%–15% 算力余量:网络收发、业务逻辑、日志与告警推送都会占用 CPU 与内存带宽,把 TPU 打满到 100% 反而会放大抖动。
按需选择编码路数:编码上限为 10 路 1080P@30fps,若业务要求 16 路全量回传,需要在前端或后端另配编码资源,不能指望 BM1688 自身完成。
4. 结论与适用边界
结论:BM1688 能撑起 16 路视频分析的高并发,但这个结论带四个前提——1080P 分辨率、25–30fps 帧率、单路单一轻量检测模型、INT8 量化并配合硬件预处理与流水线调度。四者齐备时,16 路属于官方标称范围内的正常使用;缺任何一项,可用路数都会明显低于 16。
边界:本文的路数区间由官方规格与算力比例折算得出,属于工程估算,未包含具体模型的实测耗时,也未考虑算法侧的算子适配情况;TPU 实际利用率受模型结构、量化方案、batch 设置影响,可能与理论折算存在偏差。同时,解码 480fps 与 16×30fps 严格相等,意味着没有任何冗余留给码流异常、重连风暴或突发补帧。
待验证事项:
正式选型前建议完成三项压测:一是候选模型在 TPU 上的单帧耗时与端到端帧率;二是 16 路满并发下的 CPU 占用、内存带宽与温度表现;三是断流重连、码流抖动等异常工况下的恢复能力。三项数据齐备后,再决定是否需要上探到 BM1684X 一类更高算力平台。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部