


核心问题:2026 年做国产边缘算力盒子选型,算能 BM1688与瑞芯微 RK3588 该如何取舍。
路线差异:BM1688 走专用 TPU,INT8 16 TOPS,约为 RK3588 三核 NPU(6 TOPS)的 2.67 倍,单位算力功耗也更优。
通用反向:RK3588 的 A76 大小核、Mali-G610 GPU 与 8K 编解码,在业务系统、显示交互和超高清场景明显更强。
生态定速度:RKNN/RKLLM 的社区资料与开源方案数量远超算能 SOPHON SDK,端侧大模型落地更成熟。
选型分水岭:8 路以上纯视觉分析选 BM1688;6 TOPS 以内、要跑业务系统或大模型原型选 RK3588。
两者代表了国产边缘计算的两条典型路线:算能 BM1688 是"专用 AI 算力"路线,把算力密度、编解码与 ISP 做到极致;瑞芯微 RK3588 是"通用 SoC + NPU"路线,用一颗芯片同时承担 AI、通用计算与多媒体。选型的关键不在于谁算力更高,而在于业务里"AI 推理"和"通用计算"各自占多大比重。
1. 核心参数:算力领先与通用能力领先各占一半
先把两套方案的硬件底子摊开对比。可以看到 BM1688 只在 AI 算力、编解码路数和 ISP 安防能力上占优,而 RK3588 在 CPU、GPU、制程、内存容量与多媒体格式上全面领先——这个"互有胜负"的格局,决定了后续所有场景判断。
参数维度 | 算能 BM1688 | 瑞芯微 RK3588 |
CPU 架构 | 8 核 ARM Cortex-A53 @ 1.6GHz | 4 核 Cortex-A76 @ 2.4GHz + 4 核 Cortex-A55 @ 1.8GHz |
AI 算力(INT8) | 16 TOPS(TPU) | 6 TOPS(三核 NPU) |
AI 算力(INT4) | 32 TOPS | 12 TOPS |
FP16 / BF16 算力 | 4 TFLOPS | 支持,未标称峰值 |
GPU | 无独立 GPU | ARM Mali-G610 MC4 |
制程工艺 | 未公开(推算 12nm 级) | 8nm |
视频解码 | 16 路 1080P@30fps 或 4K@120fps | 8K@60fps,最多 16 路 1080P 解码 |
视频编码 | 10 路 1080P@30fps 或 4K@75fps | 8K@30fps 编码 |
典型功耗 | 7.2W | 4.8W |
峰值功耗 | 14.4W | 15—20W |
内存支持 | 最高 16GB LPDDR4 | 最高 32GB LPDDR4X / LPDDR5 |
ISP 能力 | 专业安防级 ISP,支持双目深度、鱼眼展开 | 48MP ISP,支持多摄像头输入 |
1. AI 推理:BM1688 峰值算力是 RK3588 的 2.67 倍
1.1 峰值算力差距直接决定并发路数
BM1688 作为专用 TPU 架构,INT8 峰值 16 TOPS,是 RK3588(6 TOPS)的 2.67 倍;到 INT4 下差距进一步拉大到 32 TOPS 对 12 TOPS。在纯视觉推理任务里,这个倍数关系基本等价于可并发的视频路数倍数,而不是纸面参数差异。
1.2 目标检测实测:16 路 vs 8 路的真实分界线
BM1688:官方标称支持 16 路 1080P 实时智能分析。YOLO 系列模型下单路可达 30fps 以上,16 路并发时每路仍能维持 15fps 以上的稳定帧率。
RK3588:实测 YOLO11n(640×640)下 8 路 1080P 同时运行,总推理速度约 62 帧/秒,平均每路 7—8 帧;单路运行时可稳定 30fps。换成更重的 YOLOv8s,路数会掉到 4 路左右。
这组数据的实际含义是:如果项目需求是"十几路摄像头都要做实时检测",RK3588 在模型变重时会出现明显的帧率塌陷,而 BM1688 的余量更足;如果只需要 4—8 路轻量模型,两者差距不影响交付。
1.3 精度支持:都能跑混合精度,低精度效率有差
两者均支持 INT4/INT8/FP16/BF16/FP32 混合精度计算。差别在于 BM1688 的 TPU 在低精度量化下效率提升更明显,INT4 相对 INT8 算力直接翻倍;RK3588 的 NPU 同样支持多精度,但极低精度下的能效比略逊一筹。
2. CPU 与通用计算:RK3588 全面领先,是最大的能力落差
这是两者最容易被低估的差距。BM1688 采用全 A53 架构、主频仅 1.6GHz,CPU 只承担控制调度,重计算交给 TPU;RK3588 则是 A76 大小核异构,单核性能约为 A53 的 2—3 倍。
大核性能:Cortex-A76 主频 2.4GHz,单核性能约为 A53 的 2—3 倍,编译、加解密、协议解析类任务差距明显。
多核调度:大小核异构可按负载动态调配,轻任务走小核省电、重任务走大核提效,长时间低负载运行更省。
GPU 加速:集成 Mali-G610 MC4,支持 OpenGL、OpenCL、Vulkan,可用于图形渲染、部分并行计算与 UI 界面展示。
结论很直接:BM1688 在"纯视觉推理"场景下 CPU 够用,但一旦要在盒子上跑 Web 服务、数据库、复杂业务逻辑或图形界面,A53 集群会先成为瓶颈,而不是 AI 算力。
3. 视频编解码:安防多路看 BM1688,8K 与显示看 RK3588
3.1 BM1688:为安防场景深度优化
解码能力:H.264/H.265 解码总带宽达 1080P@480fps,恰好对应 16 路 1080P@30fps 满负荷运行。
编码能力:1080P@300fps 编码,支持 10 路实时编码回传,适合本地留档与上云回传同时进行。
专业 ISP:集成 4Kp60 安防级 ISP,硬件支持双目深度计算、图像拼接、鱼眼展开、去雾、3D 降噪,无需外挂 ISP 芯片。
3.2 RK3588:高分辨率与格式兼容性占优
8K 能力:支持 8K@60fps 解码、8K@30fps 编码,在超高清显示与大屏场景优势明显。
解码路数:理论解码总带宽同样支持 16 路 1080P,但受 NPU 算力限制,实际可做 AI 分析的路数约 8 路。
格式兼容:支持 AV1、VP9、AVS2 等更多编码格式,面对多源异构视频流时兼容性更广。
这一节的判断是:编解码的"硬件路数"两者接近,真正的差距在"能同时分析多少路",而这又回到 NPU 算力。纯安防多路分析选 BM1688;需要 8K、多媒体播放、多屏显示输出则选 RK3588。
4. 功耗与散热:BM1688 能效比更优,RK3588 待机更省
工作状态 | BM1688(以 AIBOX-1688 为例) | RK3588(以 Kiwi Box 5 为例) |
待机空闲 | 约 3—4W | 约 1.35W |
典型负载 | 7.2W | 4.8W |
满负荷峰值 | 14.4W | 15—20W |
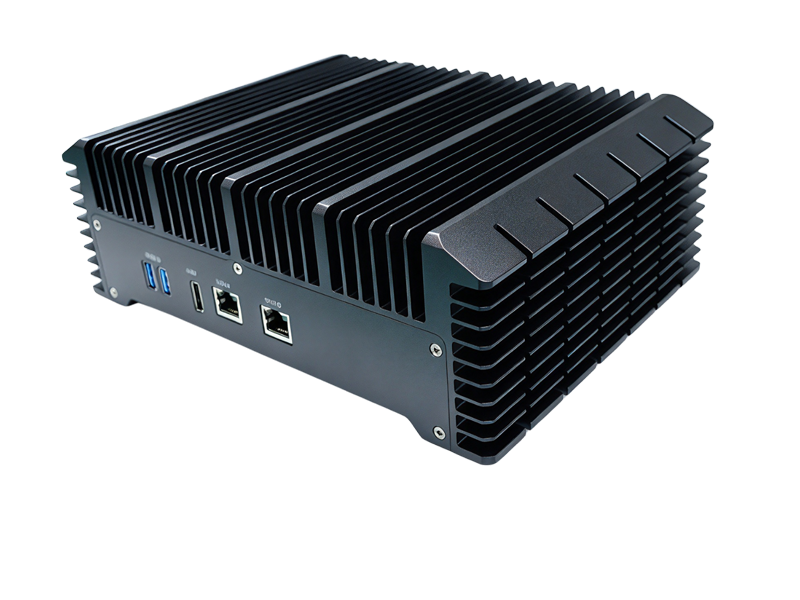
散热设计差异:BM1688 全 A53 架构发热均匀,多数成品采用被动散热即可满足 7×24 小时运行,部分高负载型号配低转速风扇;RK3588 虽为 8nm 制程,但 A76 大核满载时发热集中,实测无主动散热情况下 10—15 分钟即出现降频,满载温度可达 85—90℃,工业级应用必须配主动散热或大面积散热片。
能效比:按单位算力计算,BM1688 约 1.11 TOPS/W(16 TOPS / 14.4W),RK3588 约 0.4 TOPS/W,前者约为后者的 2.7 倍。但低负载场景下 RK3588 待机功耗更低,若设备大部分时间空转,电费与散热余量反而更友好。
5. 大模型部署:RK3588 生态成熟,BM1688 算力余量更足
5.1 RK3588:端侧 LLM 的主流平台
经过 2025—2026 年的生态建设,RK3588 已成为端侧大模型部署最成熟的国产平台之一。
支持模型:Qwen2.5-7B、Qwen3 系列 2B 级多模态、TinyLlama、Phi 系列等均可部署。
实测性能:Qwen3 2B(W8A8 量化)纯文本推理首字延迟约 0.38 秒,短回答 0.7—1.4 秒完成;2B 级多模态模型图文问答全程约 5.5 秒。
并发能力:可同时运行 3 个不同规模模型,并与 8 路视频检测任务共存,实现"视觉 + 语言"双模态边缘处理。
工具链:RKLLM 工具链持续迭代,覆盖模型量化、编译、部署全流程。
5.2 BM1688:算力潜力大,开箱方案偏少
算力潜力:16 TOPS INT8 理论上可流畅运行 7B 级量化模型,且可与多路视频分析共用 TPU,CPU 压力小。
支持情况:算能 SOPHON SDK 已支持主流大模型部署,但社区案例与开箱即用方案少于 RK3588,需要更多自研投入。
优势场景:"大模型 + 多路视频分析"的复合负载,TPU 可同时承担视觉推理与 LLM 推理。
落在判断上:纯大模型语言推理两者都能跑,RK3588 生态完善、资料多、试错成本低;若是"大模型 + 多路视频"的复合场景,BM1688 的算力冗余更能撑住并发。
6. 开发工具与生态:决定落地速度,而非性能上限
6.1 算能 SOPHON SDK:专业但门槛偏高
定位:面向 AI 推理优化的专业深度学习 SDK。
组件:BMCV 图像处理库、BMRuntime 推理引擎、SOPHON-FFmpeg / OpenCV 硬件加速库。
框架支持:PyTorch、TensorFlow、PaddlePaddle、ONNX 等主流框架。
门槛与文档:需要熟悉 TPU 编程模型,开发门槛中等偏高,适合有算法部署经验的团队;官方文档完整,有迁移指南与示例代码。
6.2 瑞芯微 RKNN + RKLLM:社区资源压倒性领先
定位:覆盖视觉与大模型的通用 AI 工具链。
社区生态:GitHub 上大量开源项目、教程与预编译模型,第三方教程、视频、技术博客数量远超算能。
门槛:入门示例多,问题容易找到解决方案;Android、Linux、Debian、Ubuntu 系统支持完善。
生态不改变芯片性能,但直接改变项目周期与人力成本。团队有 AI 部署经验、追求算力密度,可承担 BM1688 的学习成本;团队人少、要快速落地、依赖社区排障,RK3588 更稳。
7. 价格与性价比:每 TOPS 成本 BM1688 更低
产品形态 | BM1688 方案 | RK3588 方案 |
核心板 / 开发板 | 约 1500—2500 元 | 约 1100—1800 元 |
成品边缘盒子(8G+32G) | 约 3000—4500 元 | 约 2500—4000 元 |
工业级整机 | 约 4000—6000 元 | 约 3500—5500 元 |
每 TOPS 成本:BM1688 约 200—280 元/TOPS,RK3588 约 400—600 元/TOPS,纯算力采购前者更划算。
综合功能成本:RK3588 集成 GPU、更强 CPU、8K 显示,按"单台设备能做的事"折算,单位功能成本更优。
开发成本:RK3588 生态成熟、人力投入少;BM1688 学习成本高,但批量部署后硬件差价可覆盖前期投入。
8. 适用场景:按"AI 占比"而非"算力大小"做选择
8.1 优先选 BM1688
安防监控:8 路以上高清视频智能分析,如智慧工地、明厨亮灶、园区安防。
纯视觉推理:视频结构化、行为分析、人脸识别等并发量大的场景。
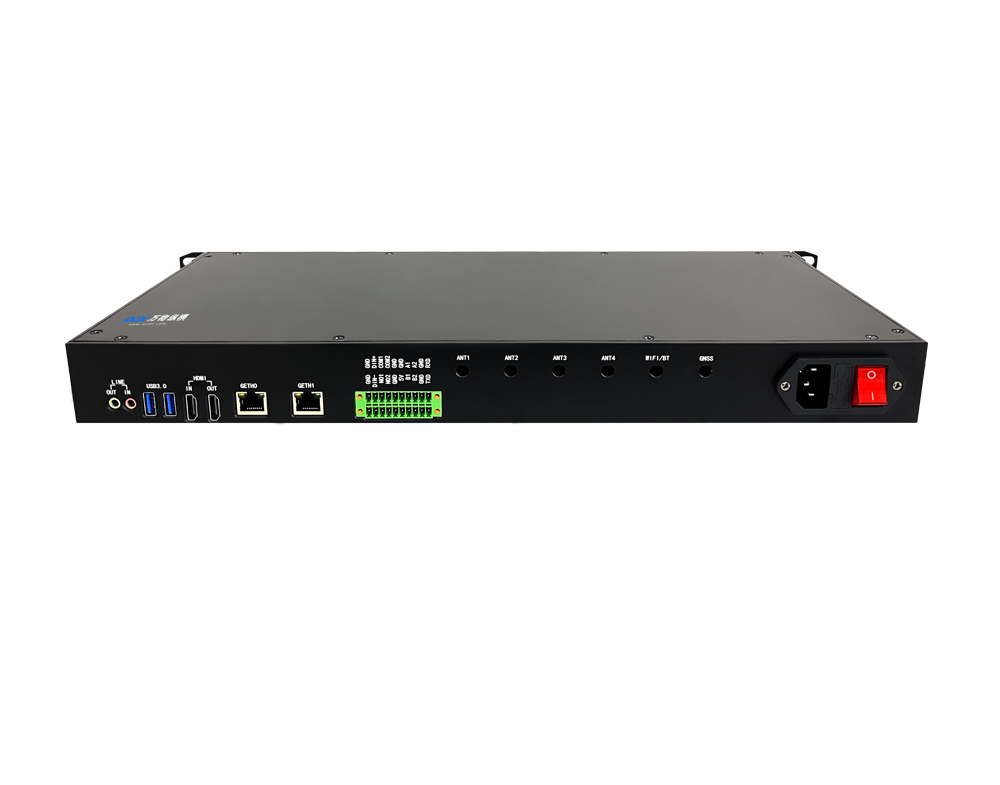
无人值守:7×24 小时运行,被动散热即可稳定工作,故障点少。
算力密度敏感:安装空间有限、需要单设备高算力的边缘节点。
技术栈统一:已有 BM1684X 等算能产品,希望沿用一套 SOPHON SDK。
8.2 优先选 RK3588
通用边缘计算:既要 AI 推理,又要跑业务系统、Web 服务、数据库。
多媒体与显示:8K 播放、多屏异显、UI 交互的智能终端。
大模型原型:快速验证端侧 LLM 与多模态方案,社区资源丰富。
机器人与工控:需要 GPU 加速、实时控制、丰富外设接口。
预算敏感:单设备算力需求在 6 TOPS 以内,且希望降低开发人力成本。
安卓需求:需要运行 Android 应用的智能设备。
9. 结论:算力密度选 BM1688,通用与生态选 RK3588
算能 BM1688 是"术业有专攻"的专用 AI 算力芯片。16 TOPS INT8 在同功耗级别下领先明显,视频编解码与安防 ISP 深度优化,是安防与纯视觉边缘计算的性价比之选;代价是 CPU 偏弱、通用计算受限、生态丰富度不及瑞芯微。
瑞芯微 RK3588 是"全能型选手"。8nm 制程、大小核 CPU、GPU、NPU 一体化,既能跑 AI 又能担纲通用计算,8K 多媒体与显示能力突出,生态成熟、开发门槛低;短板是 AI 算力有限,多路视频分析能力不如专用 TPU 方案。
可执行的选型规则:
16 路以上视频分析、追求算力密度:选 BM1688。
8 路以内 AI + 通用业务 + 显示交互:选 RK3588。
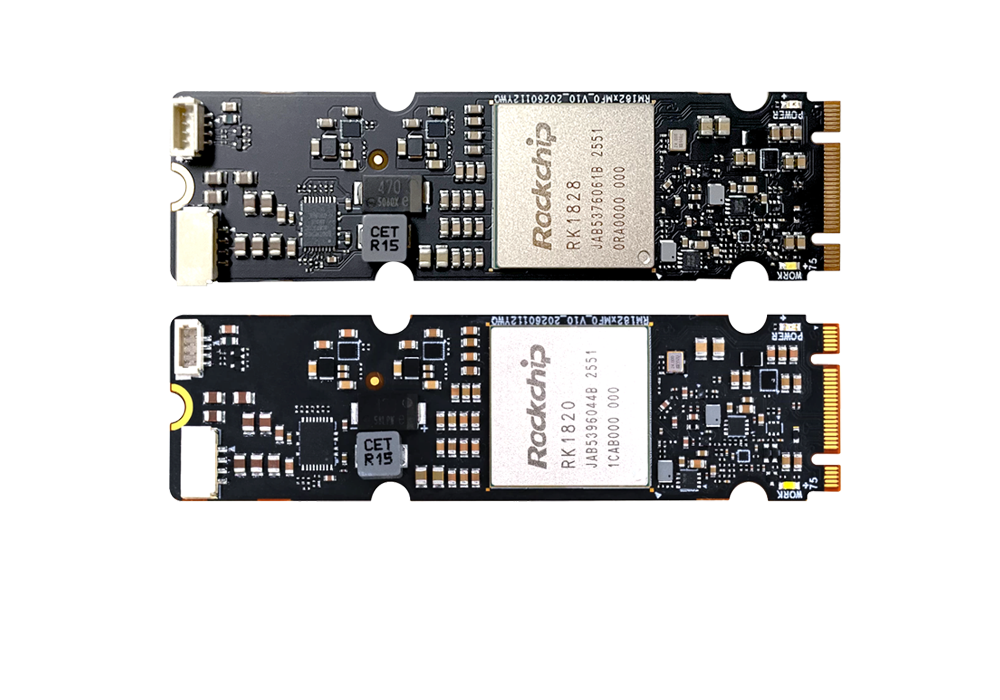
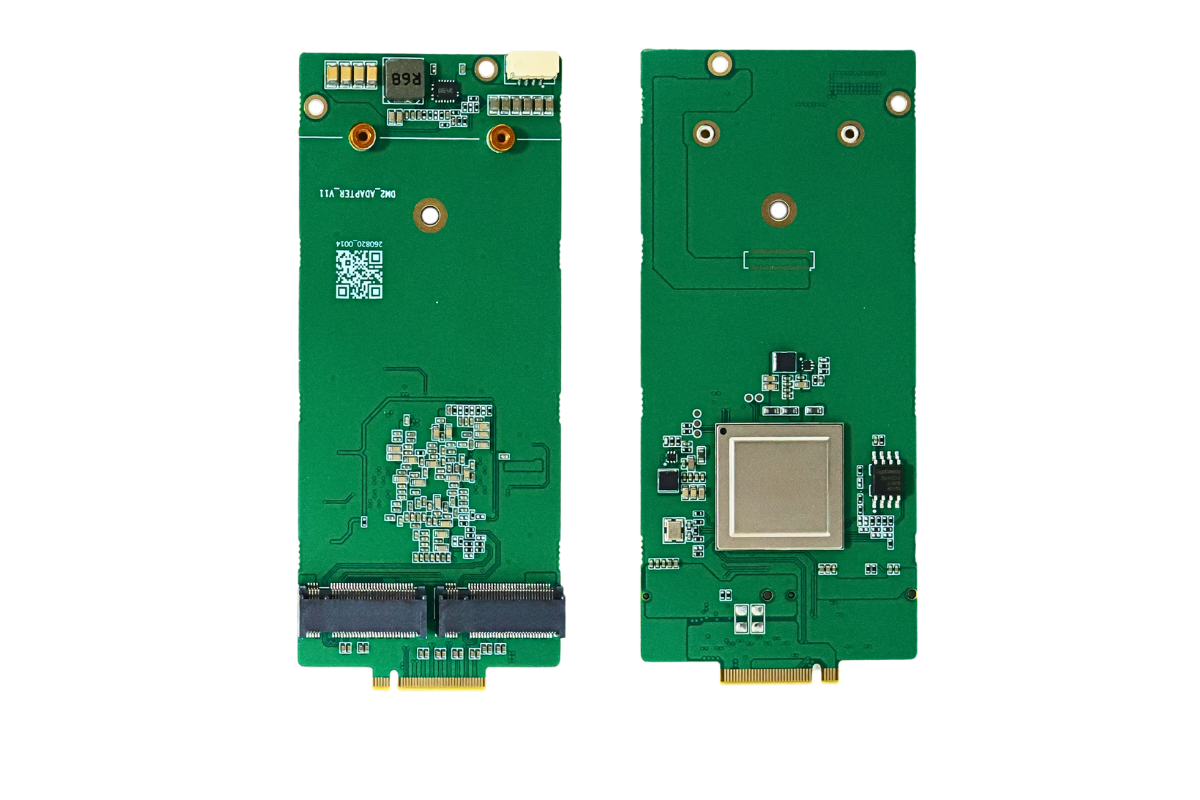
需要更高算力:考虑算能 BM1684X(32 TOPS),或 RK3588 + RK1828 协处理器方案。
数据口径与边界:本文参数取自厂商公开规格与第三方整机产品资料,功耗与帧率为公开实测值,会随整机散热设计、内存配置、模型精度与软件版本变化;不同品牌整机的实际表现可能与本表存在差异,最终选型建议以样机在目标模型与目标路数下的自测结果为准。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部