


核心判断:解码够,算力不一定够。32 路 1080P@25fps 是 BM1684X 的硬件解码上限,而工业质检的真实路数上限由 TPU 推理算力决定。
解码不是瓶颈:1080P@25fps 可满配 32 路;2K 约 16 路、4K 仅 8 路,帧率高于 25fps 时等比例下降。
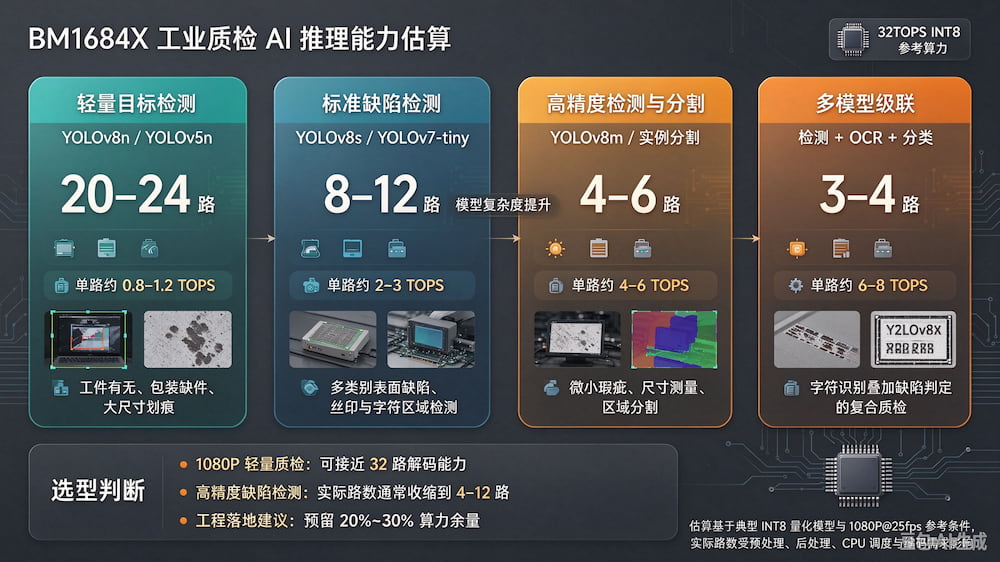
推理才是瓶颈:轻量检测约 20—24 路,标准缺陷检测 8—12 路,高精度或分割类只有 4—6 路。
另有三个隐性约束:硬件编码仅 12 路 1080P,CPU 与内存带宽在多模型并发时可能先到顶。
选型建议:16 路以内 1080P 中等复杂度质检可放心选;确需 32 路全量 AI 质检,须限定轻量模型并做实测压测。
1. 解码规格:1080P 满配 32 路,分辨率一升路数就掉
BM1684X 的视频解码由专用 VPU 硬件单元承载,不占用 TPU 与 CPU,因此这一项可以按硬件标称值直接与场景对照,不存在"标称值要打折"的问题。它的总解码吞吐量约为 800fps @1080P(H.264/H.265),对应 32 路 1080P@25fps 满负荷解码;超过 1080P 的分辨率则按像素吞吐量近似线性折算。
输入规格 | 可解码路数 | 说明 |
1080P @25fps | 32 路 | 按 800fps 总吞吐量满配,是官方"32 路"标称的来源 |
1080P @30fps | 约 27 路 | 产线提速或高帧率检测时,路数随帧率等比例下降 |
2K(2560×1440)@25fps | 约 16 路 | 像素量约为 1080P 的 1.8 倍,路数相应折半 |
4K(3840×2160)@25fps | 8 路 | 高分辨率精密质检的常见配置,此时 32 路不成立 |
工业相机 Raw 图直连 | 不占解码 | GigE/USB3.0 原始图像不经过视频解码,路数完全由 TPU 决定 |
解码侧的判断很直接:只要摄像头是 1080P、25fps、H.264/H.265 编码,32 路就是真实可用的能力,不是营销数字。一旦分辨率升到 2K 以上,32 路的前提就消失了;如果现场是工业相机直出 Raw 图,解码这一项根本不参与计算,需要单独评估的是采集带宽与推理算力。
1. 真实天花板在推理:32TOPS 支撑不了 32 路复杂质检
按 32 路解码配摄像头很容易忽略一件事:解码能力与推理能力是两条彼此独立的资源线。BM1684X 的 TPU 算力为 32TOPS INT8,而工业质检模型普遍比安防级轻量算法复杂一个量级,"32 路"在质检语境下很少能跑满。下表是按模型复杂度折算的工程参考值,已计入 30%—40% 的算力利用率与预处理、后处理开销。
质检模型类型 | 单路算力需求 | 可支撑路数 | 典型场景 |
轻量目标检测 (YOLOv8n / YOLOv5n) | 约 0.8—1.2 TOPS | 20—24 路 | 工件有无、包装缺件、大尺寸划痕 |
标准缺陷检测 (YOLOv8s / YOLOv7-tiny) | 约 2—3 TOPS | 8—12 路 | 多类别表面缺陷、丝印与字符区域检测 |
高精度检测与分割 (YOLOv8m / 实例分割) | 约 4—6 TOPS | 4—6 路 | 微小瑕疵、尺寸测量、区域分割 |
多模型级联 (检测 + OCR + 分类) | 约 6—8 TOPS | 3—4 路 | 字符识别叠加缺陷判定的复合质检 |
折算差距来自三处。一是模型本身的复杂度,分割头与多尺度特征融合的算力开销远高于单阶段检测;二是每次推理后的 NMS、规则判定与结果上报,会重新占用 CPU 与 TPU 时间,这部分在标称算力里不体现;三是模型量化精度,只有稳定量化到 INT8 且精度不塌的模型,才对应上表的乐观区间,FP16 或混合精度会按倍数吃掉路数。
有利于质检的一点是 BM1684X 集成了专用 VPP 硬件单元,Resize、Crop、色彩空间转换、对比度调整都可以离线完成,不占 TPU 与 CPU。工业质检通常需要对 ROI 区域裁剪缩放后再推理,这项硬件加速能显著压低系统负载,实际路数比纯软件预处理更接近上表的上沿。
1. 三个不在标称值里的隐性瓶颈
除解码与推理之外,还有三项资源决定系统能否稳定跑满。它们的共同特点是都不出现在"32 路"这个数字里,却常常是现场掉帧的真实原因。
视频编码只有 12 路。BM1684X 硬件编码支持 12 路 1080P@25fps。如果方案要求把缺陷画框、标注叠加后回传平台或本地存证,32 路无法全部编码,最多 12 路能走完整条"解码—推理—编码"链路,其余路只能输出报警信号。
CPU 可能先于 TPU 到顶。8 核 ARM Cortex-A53 @2.3GHz 应付简单报警逻辑与 IO 控制没有问题,但一旦涉及多模型调度、产线联动、数据上报、本地数据库写入,CPU 单核占用会先打满,表现为推理排队与掉帧。
内存带宽在大分辨率下吃紧。最大 16GB LPDDR4x、68.3GB/s 带宽,对 16 路以内的轻量质检非常充裕;但 4K 分辨率叠加较大模型并发时,带宽会先成为约束,表现为 TPU 利用率上不去而帧率下降。
2. 场景化结论:什么情况可放心选,什么情况别跑满
可以先判断场景,再谈路数。把前面的三条资源线与实际业务叠加,选型结论基本可以收敛到三档。
推荐按 32 路部署的情况:
32 路以内 1080P 分辨率的轻量级缺陷检测,例如包装线缺件、物流分拣、普通工件外观初检,模型可稳定量化到 INT8 且为 YOLOv8n/YOLOv5n 级轻量架构。
多工位低帧率抓拍场景,每个工位每秒只检测 2—5 次,可以通过轮询调度接入超过 32 路摄像头,此时瓶颈从解码转为调度策略。
只做推理、不做编码回传的闭环产线,系统仅输出报警信号或触发执行机构,不叠加 OSD 标注上传。
不建议跑满 32 路的情况:
采用 2K/4K 相机的精密质检,解码侧本身就先折半甚至降到 8 路,推理侧还要用更高分辨率输入,两处同时缩水。
使用 YOLOv8m 及以上模型、需要实例分割或检测 + OCR + 分类多模型级联的高精度检测,实际可支撑路数在 3—6 路区间。
每一路都要编码录像、叠加标注后上传云端的场景,硬件编码的 12 路上限会直接卡住方案。
稳妥的选型原则是预留 20%—30% 的算力与解码余量。工业现场的路数需求通常随产线扩建、检测项增加而上浮,模型也会迭代,按标称上限一次性配满,后续几乎没有调整空间。若实际需求在 16 路以内、模型复杂度中等,BM1684X 是性价比很高的选择;若确实需要 32 路全量 AI 质检,前提是模型足够轻、不做编码回传,并提前用真实码流做压测。
3. 结论与边界
结论:32 路视频解码在 1080P 工业质检场景中是够用的,但它只是一个入口条件,而非选型依据。真正决定方案能否落地的,是"模型复杂度 × 路数 × 是否编码回传"三者叠加后的余量;三者中任意一项抬高,可支撑路数都会明显低于 32。
边界与待验证事项:上表中的路数为按标称算力与像素吞吐量折算的工程估算,不包含具体模型的实测帧率与真实码流特征。落地前应使用实际模型、实际摄像头码流与真实业务逻辑做 8 小时以上连续压测,重点观察 TPU 利用率、CPU 单核占用、内存带宽占用与掉帧率四项指标,再据此确定最终路数配置。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部