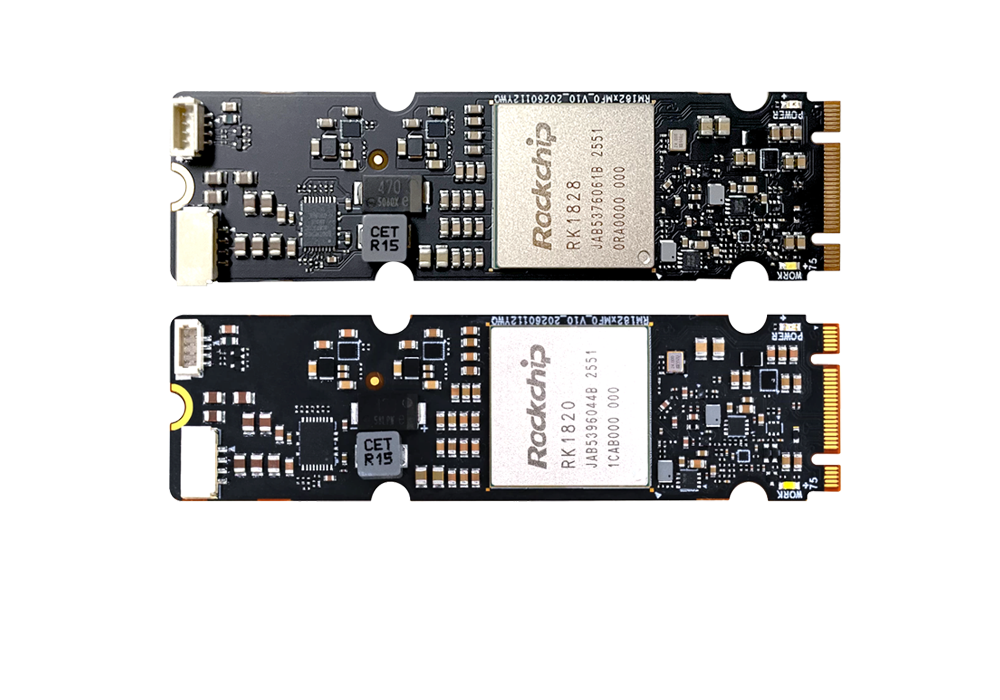
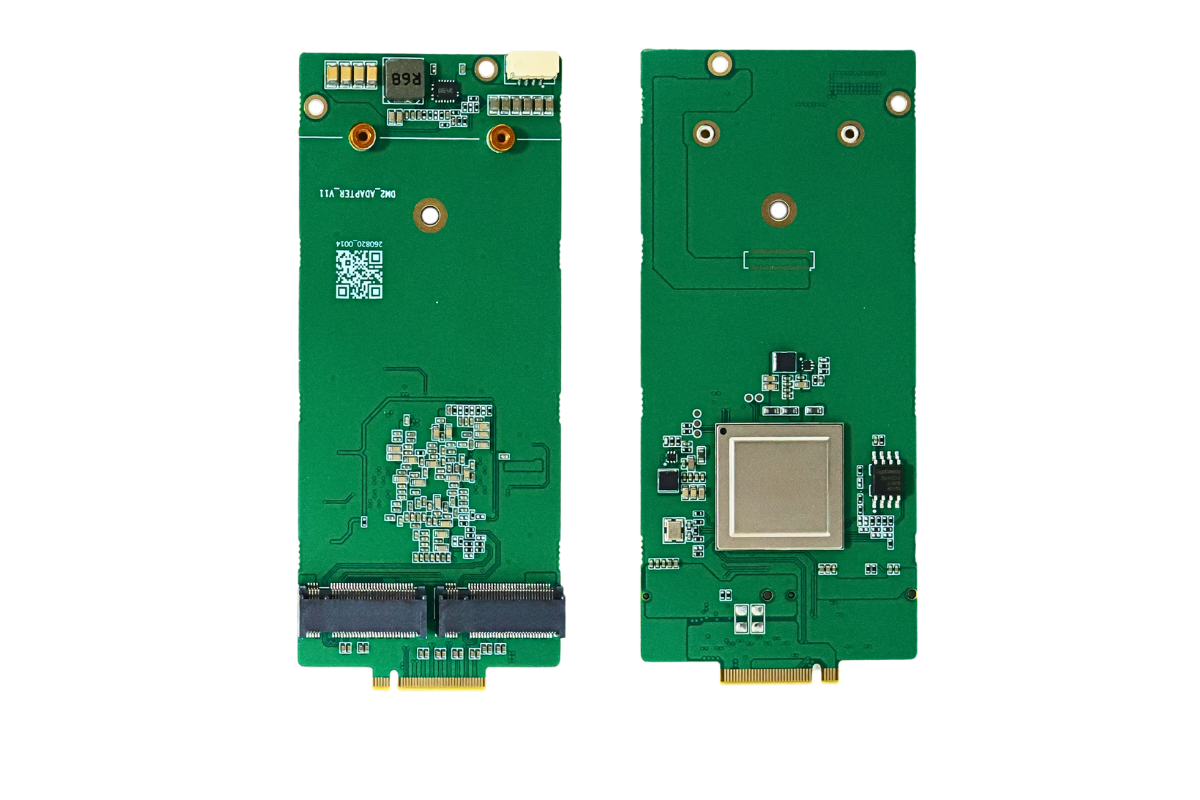
算能发布 BM1684X M.2 形态算力模组新版本,重点针对VLM 视觉语言大模型做软硬件协同优化,把多模态图文理解能力落地到 M.2 边缘插卡形态,可直接通
算能升级面向 BM1684X 的 TPU-MLIR 模型编译优化工具链,重点补齐大语言模型、多模态视觉语言模型的编译与自动优化能力,降低在 BM1684X 边缘
在智慧城市、智慧工地、智慧工厂项目中,多路视频流处理是边缘设备最消耗资源的环节。行业热点反映,很多边缘设备依赖 CPU 做软件解码,一旦接入摄像头数量增多,CP
2026 年大模型正在加速从智算中心向边缘硬件下沉,端侧运行大模型已经从概念走向项目落地。但大量项目遇到现实矛盾:普通边缘芯片算力不足、内存有限,跑不动主流开源
2026 年,国产 AI 芯片产业迎来规模化落地的关键窗口期,在供应链安全与信创政策双重驱动下,边缘侧硬件加速完成海外芯片方案的国产化替换,国产 TPU 芯片凭
算能针对BM1684X M.2 AI 算力卡推出新版固件,重点优化 VPU 视频编解码调度、内存带宽分配与 TPU 任务调度逻辑,多路视频解码 + AI 推理综
*








 试用申请
 产品咨询
 在线客服
 回到顶部