
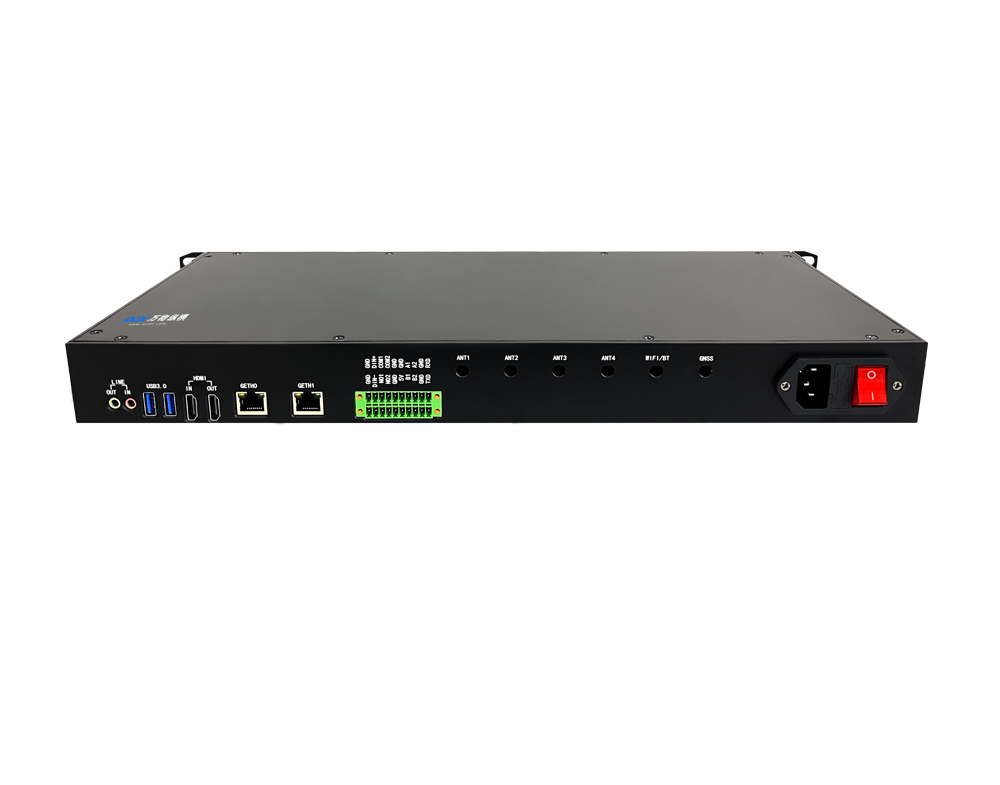
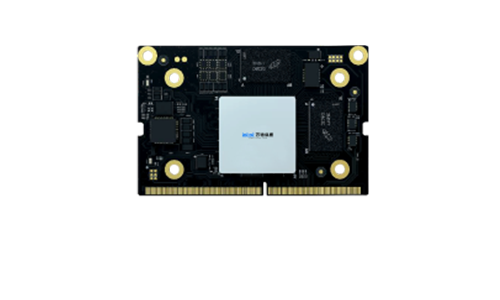
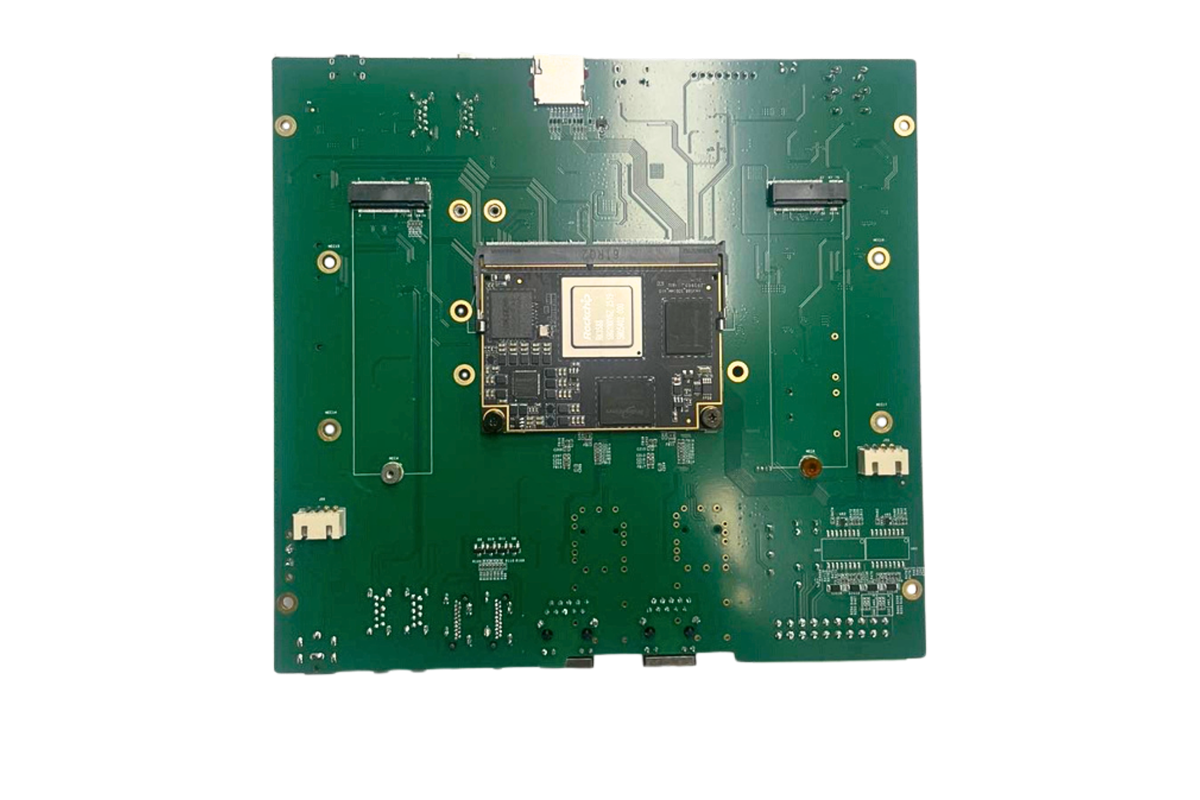
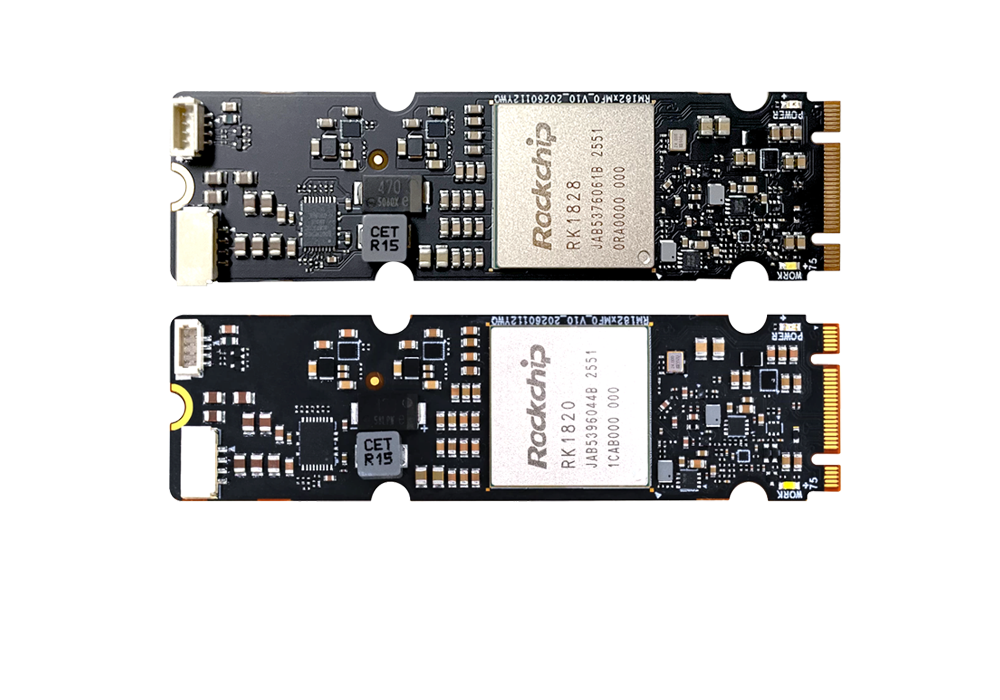
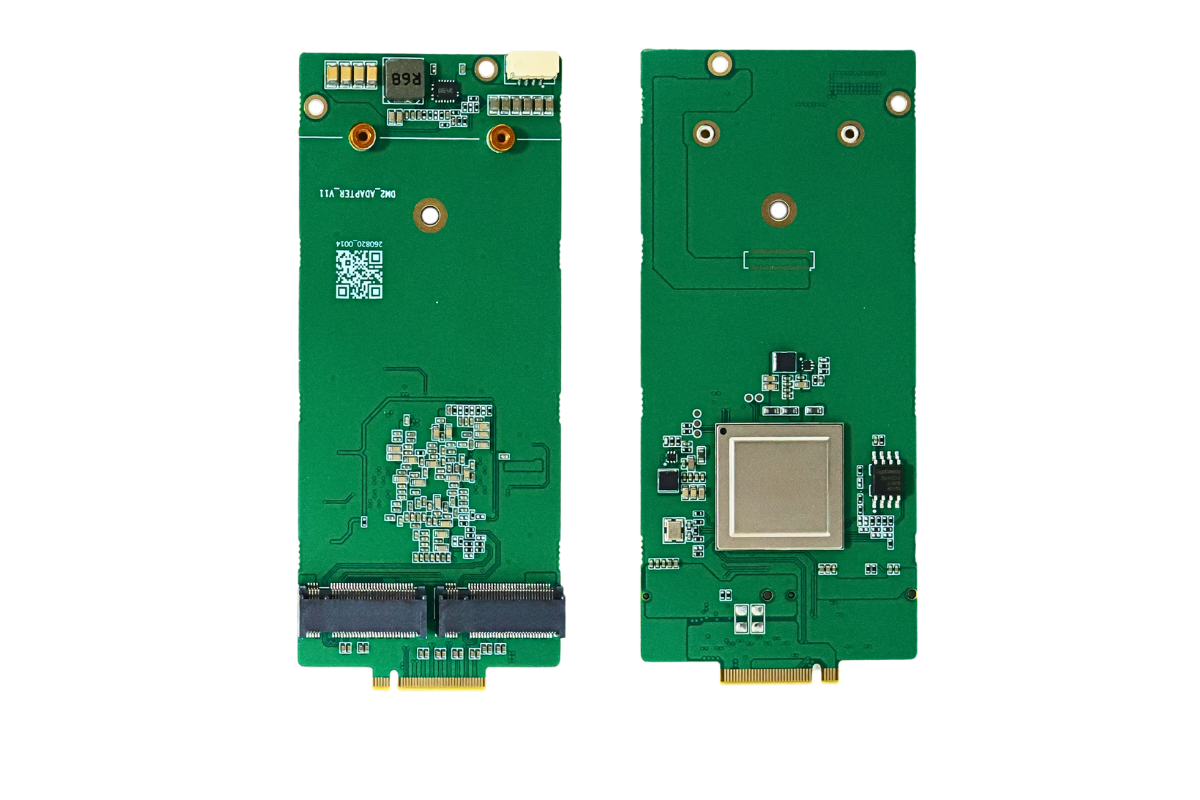


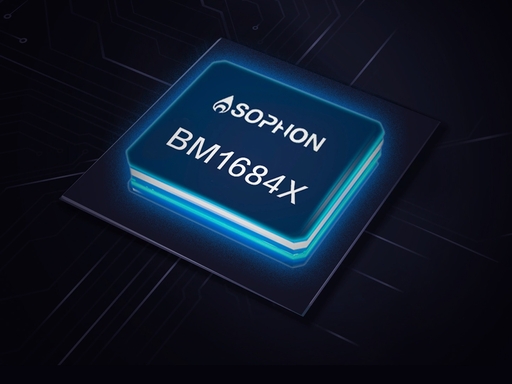
算能发布 BM1684X M.2 形态算力模组新版本,重点针对VLM 视觉语言大模型做软硬件协同优化,把多模态图文理解能力落地到 M.2 边缘插卡形态,可直接通过 PCIe 接入工控机、AI 盒子、行业服务器,无需复杂底板开发,大幅降低本地 VLM 部署门槛。
✅ 核心硬件基础
BM1684X 为算能第四代张量处理器,INT8 峰值算力32TOPS,集成 8 核 A53@2.3GHz,最高支持 16GB LPDDR4x,原生支持多精度混合推理:INT8 / BF16 / FP16 / FP32;自带硬编解码引擎,32 路 1080P 或 8 路 4K 视频硬解,天然适配 VLM“视频流 + 图文问答” 场景,典型功耗约 17W,M.2 2280 规格,适合空间受限边缘设备。
✅ 新版本 VLM 优化要点
1. 算子与模型编译优化
更新 SOPHON SDK,针对 CLIP、ViT 视觉编码器、LLM 文本解码器做算子融合、动态 shape 优化;优化多模态桥接层(vision-language projector),减少图像编码到文本推理之间的数据搬运开销,降低 VLM 首 token 延迟。支持 VILA、Qwen-VL 等主流开源 VLM 模型一键转换 BModel,量化精度损失可控。
2. 内存调度优化
针对 VLM “图像特征占用内存大” 痛点,优化显存分片、特征图复用策略,在 16GB 内存版本下可以稳定跑通 7B 级别 VLM,支持更长上下文图文问答。
3. 多媒体链路深度打通
BMCV 图像预处理硬件加速,图像缩放、归一化、色彩转换在芯片端完成,CPU 不再承担图像预处理压力,视频流 VLM 问答(边看视频边提问)吞吐显著提升。
4. M.2 PCIe 链路优化
优化 PCIe 数据传输,降低主机与模组之间特征数据传输瓶颈,多路并发 VLM 任务时稳定性更好。
✅ 典型场景
行业视觉 Agent:工业质检、电力巡检,拍照 / 视频 + 自然语言问答
智慧工地、明厨亮灶:视频流实时 VLM 理解,事件描述、异常图文上报
机器人本地多模态交互:本地离线图文问答,不依赖云端
嵌入式 AI 整机:工控机、NVR 加装 M.2 模组,快速升级多模态能力
✅ 对比价值
相比纯 CV 时代老版 BM1684X M.2 模组:旧版主打目标检测、视频结构化;新版本补齐VLM 多模态短板,一张 M.2 卡同时承载视频解析 + 视觉大模型图文推理,兼顾多路视频接入能力与多模态生成能力,是边缘端低成本落地本地 VLM 的方案。
✅ 配套工具链
SOPHON SDK 提供模型转换、量化、性能 profiler 工具,支持 Docker 部署,提供 VILA、Qwen-VL 等 VLM 参考例程,开发者可快速做二次开发。支持 Windows/Linux 主机通过 M.2 PCIe 调用模组算力。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部