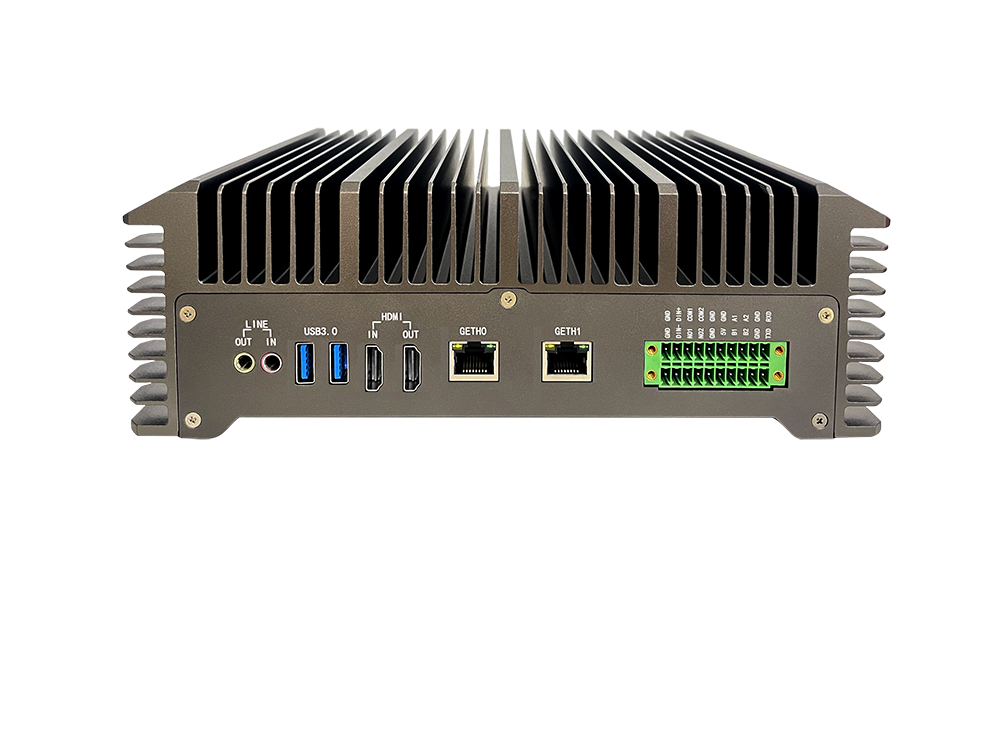
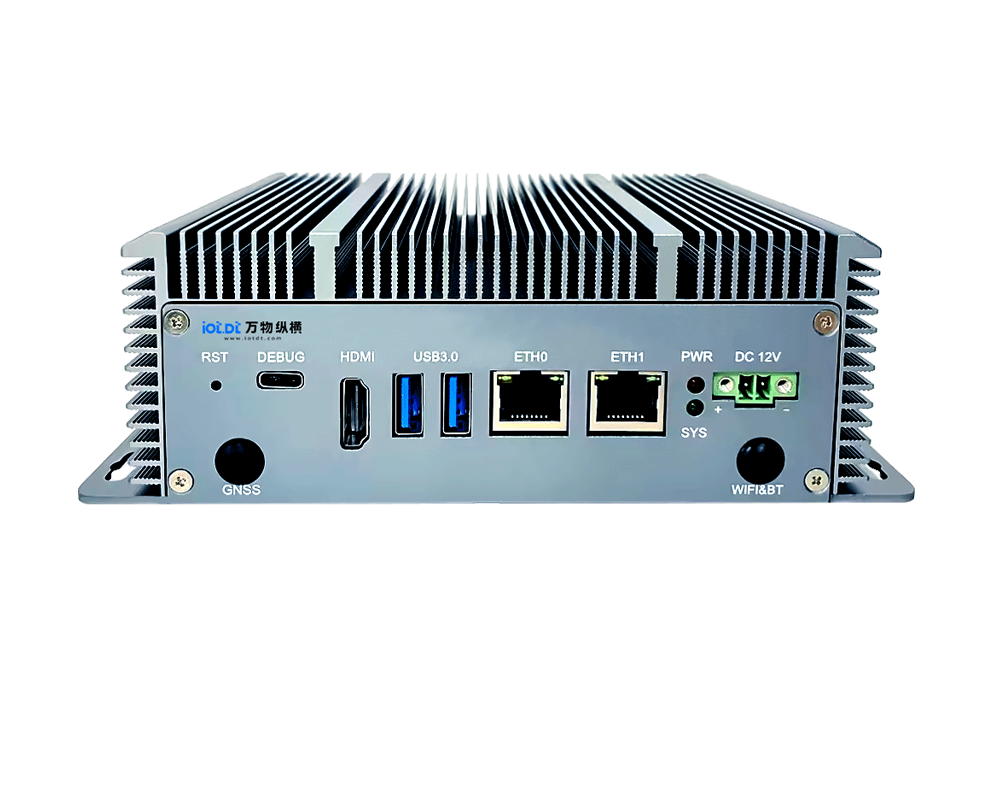
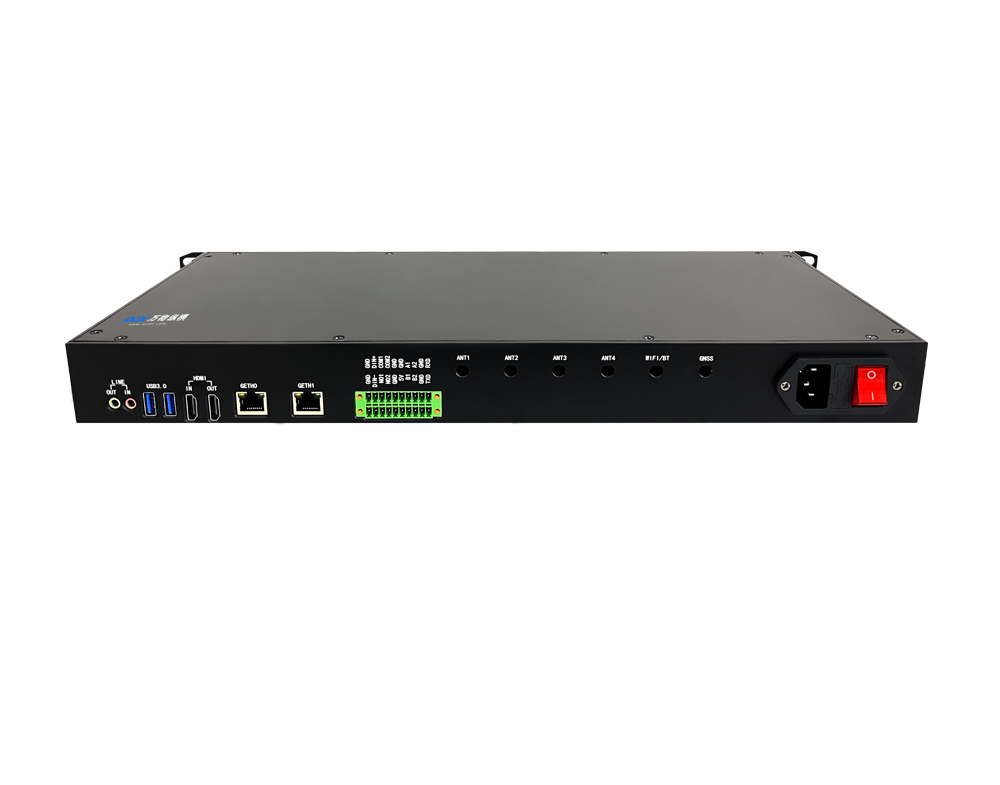
近期行业趋势显示,AI 算力正在大规模从云端向端侧迁移,本地大模型推理、物理 AI、多模态视觉语言模型(VLM)成为产业落地焦点。开源端侧模型持续迭代,Qwen 系列、MiniCPM、InternVL 等模型版本密集更新,企业却普遍遭遇硬件选型困境:传统边缘设备算力固化,要么跑不动 7B‑30B 大模型,要么整机成本、功耗过高,难以适配工业复杂环境。万物纵横 DA060R AI 边缘计算盒子,采用主控 + M.2 可扩展算力模组异构架构,为端侧大模型落地提供一套弹性、工业级的硬件底座。

AI 从云端走向边缘,核心诉求集中在三点:数据本地处理保障隐私安全、端到端低延迟推理、无网络条件下业务持续运行。但很多传统边缘硬件算力固定,一旦业务升级,只能整机替换,造成硬件浪费与项目周期拉长。
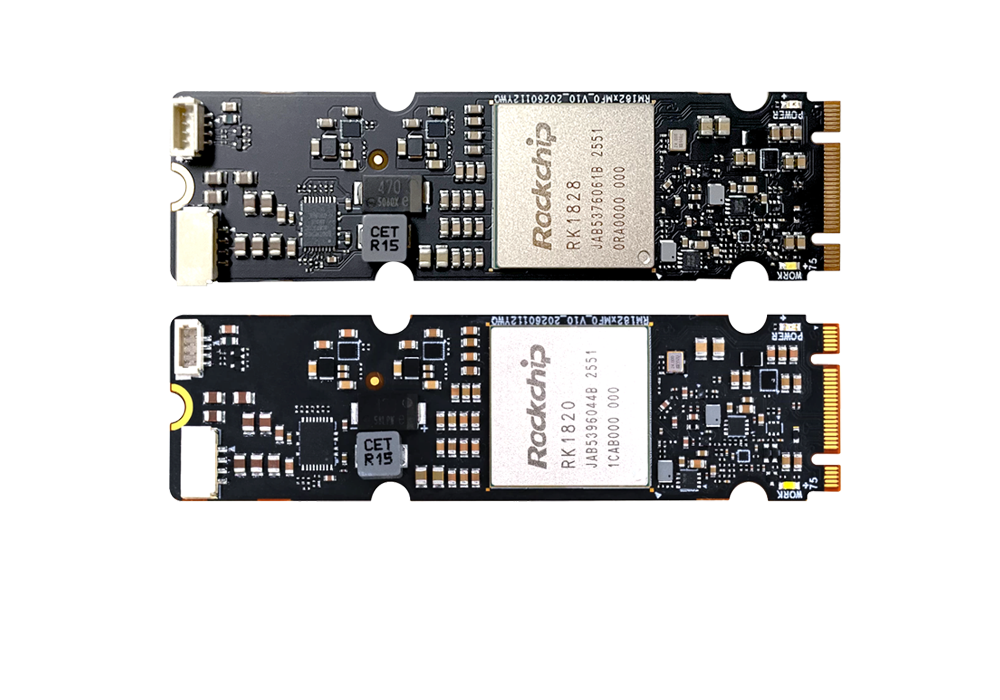
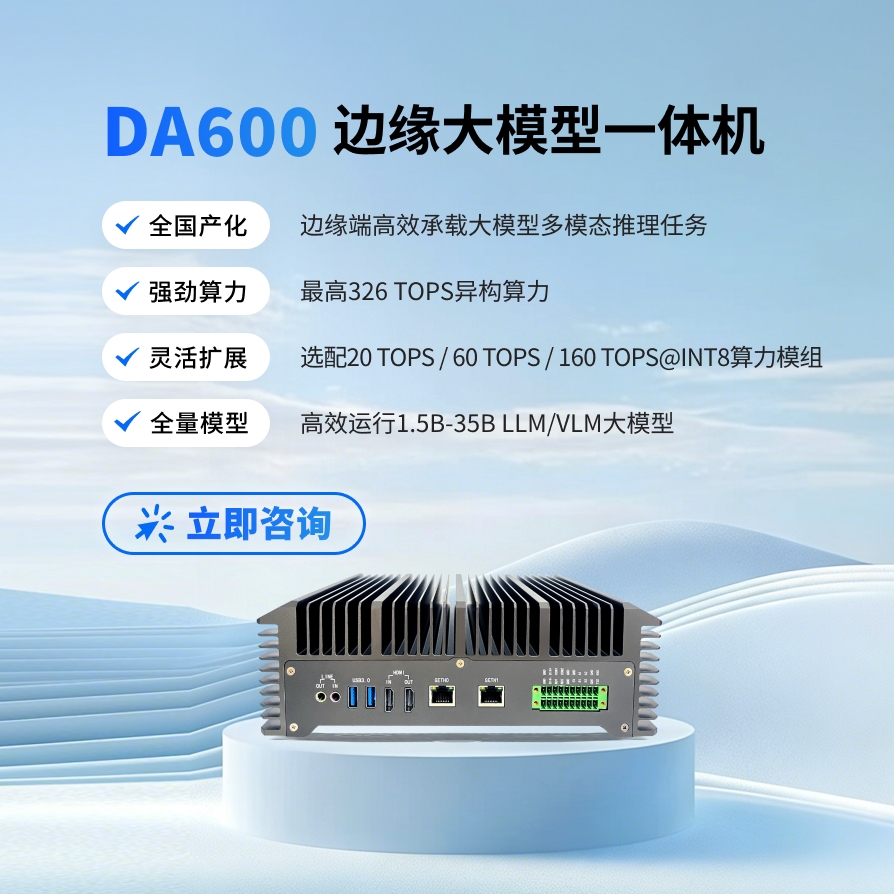
DA060R 基于 RK3588 平台,主控自带 6TOPS INT8 基础 NPU 算力,通过标准 M.2 PCIe 接口,可灵活选配 20TOPS/60TOPS/160TOPS 算力加速模组,异构总算力最高可达 166TOPS@INT8,无需更换整机硬件即可完成算力升级,覆盖 3B‑30B 参数 LLM 以及 VLM 多模态推理需求。
在软件生态层面,DA060R 原生支持 Ubuntu、Debian、麒麟国产操作系统,深度适配 PyTorch、TensorFlow、PaddlePaddle、ONNX 等主流深度学习框架,开箱即用,开发者可快速完成 Qwen2.5、Qwen3、Llama2、DeepSeek、InternVL 等主流开源模型部署,无需做大量底层驱动开发。
针对工业严苛环境,DA060R 采用全机被动散热,DA060RJ 宽温版本支持‑20℃~70℃持续稳定工作;双千兆网口、RS485/232、CAN、DI/DO、音频输入输出完整工业接口,可直连工业相机、传感器、PLC 设备,打通 “感知‑AI 推理‑设备联动” 全链路。
总结
端侧 AI 已经跨过概念验证阶段,进入规模化工程落地周期。算力不能一味追求峰值 TOPS,更要兼顾弹性扩展、功耗、宽温稳定性、软件适配完整度。DA060R“基础算力 + 可插拔加速模组” 架构,正是面向产业实际痛点给出的硬件方案,助力企业快速落地本地大模型、工业视觉、智能分析项目。
请用手机扫码查看分享内容
 下一篇:M.2 算力模组怎么选?万物纵横 DA060R 三大模组覆盖从轻量到百亿大模型
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部

 商城