随着 M.2 形态 AI 加速模组成为边缘算力扩展主流方案,市面上模组规格百花齐放,很多研发工程师容易只看峰值 TOPS 参数,忽略显存带宽、功耗、驱动适配、宽温能力,导致项目后期踩坑。今天结合万物纵横 DA060R 平台,拆解三款 M.2 算力模组选型逻辑,帮助项目快速匹配 LLM/VLM 推理硬件。

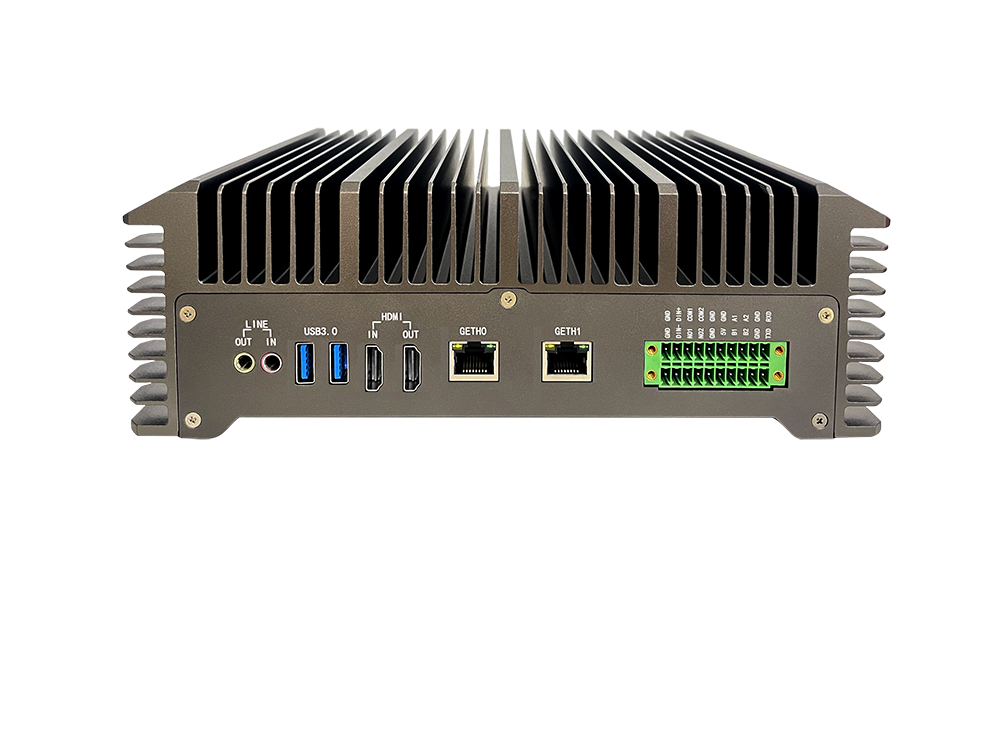
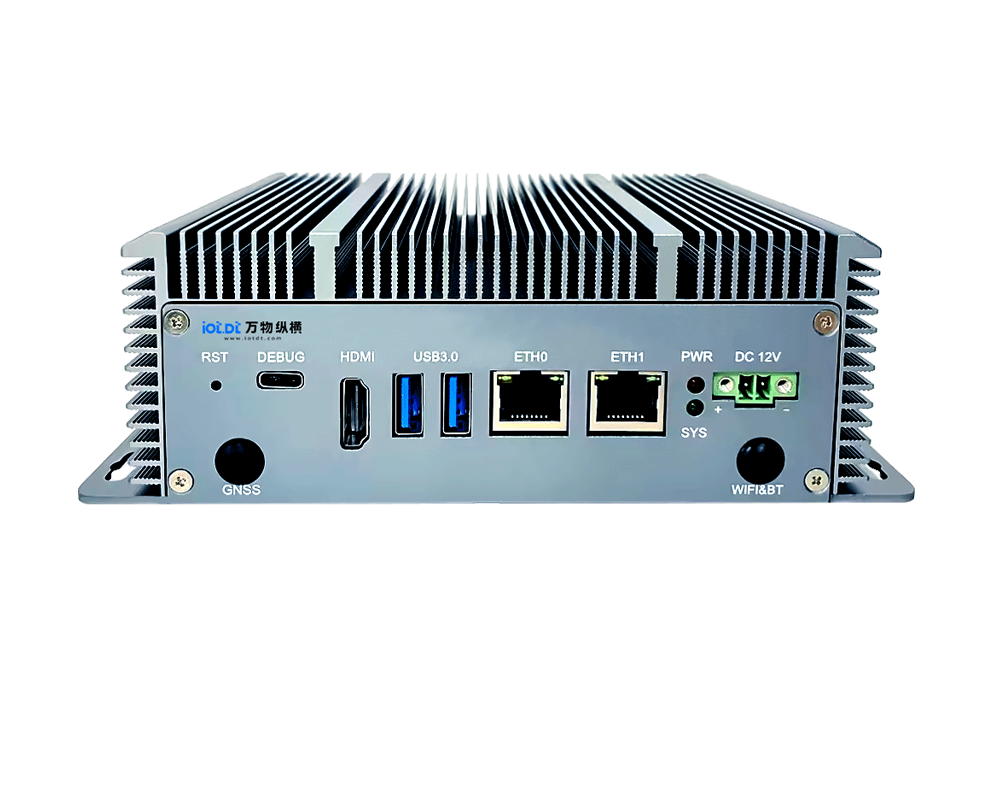
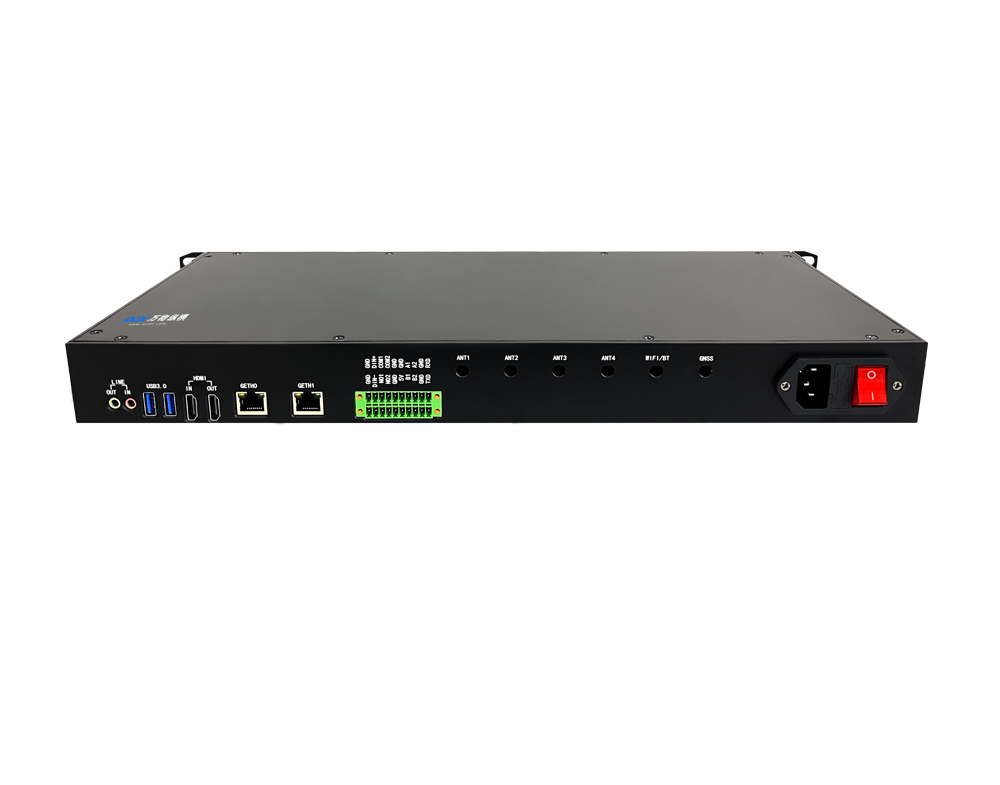
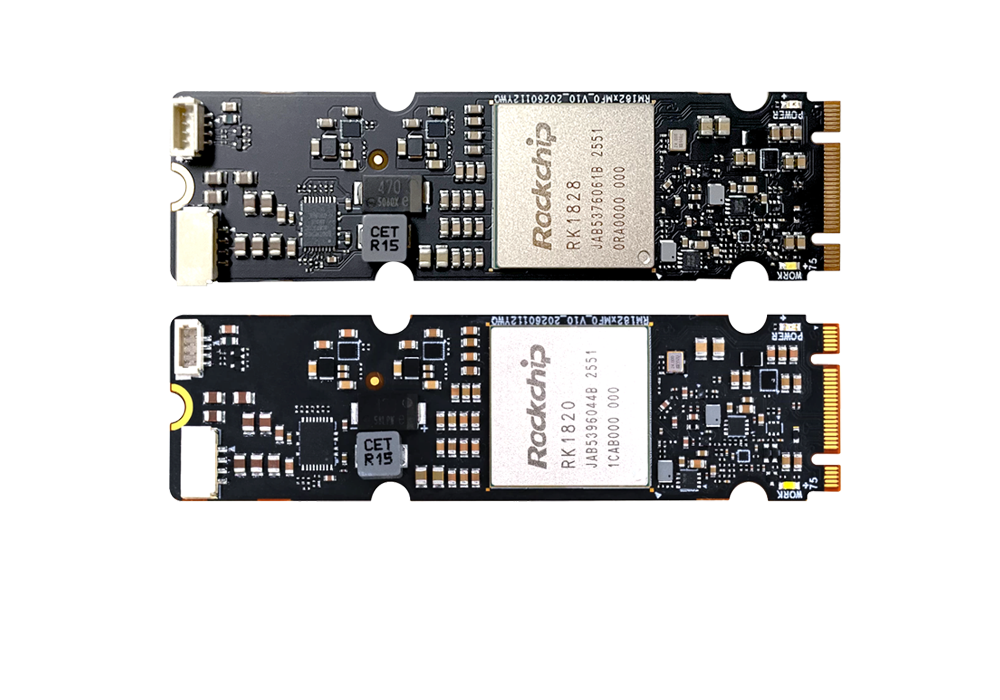
DA060R 系列边缘盒子预留标准 M.2 PCIe 高速插槽,独立供电散热设计,支持三款差异化算力模组:R182X(20TOPS)、DL20(60TOPS)、HM50(160TOPS),分别面向轻量化大模型、多模态工业场景、7B‑30B 高参数量大模型。
模组型号 | 核心定位 | 适配模型规模 | 典型功耗 | 核心优势 |
R182X-20TOPS | 高性价比协处理器 | 3-7B LLM/VLM | ≤15W | 驱动零开发,延迟低至 0.1s,适合语音、轻量化多模态 |
DL20-60TOPS | 工业级多模态标杆 | 7-13B LLM/VLM | ≤25W | 20~70℃宽温,32 路视频解码,7×24 小时产线运行 |
HM50-160TOPS | 高能效主力大模型引擎 | 7-30B LLM/VLM | ≤15W | 存算一体架构,大显存版本支持 30B 级本地推理,多系统兼容 |
选型参考建议
1. 轻量化场景:智能会议转录、简单视觉检测、3‑7B 模型
优先选配 R182X 模组。如本地 ASR 语音转写、会议摘要、YOLO 目标检测,Qwen2.5‑3B/7B、MiniCPM 系列模型,端到端最低 0.1s 延迟,功耗低,成本可控。
2. 工业产线 7×24 小时不间断运行、多路视频 + 多模态 VLM
优先 DL20 模组。宽温工业设计,适配车间高低温环境,支持多路视频解码,适合工业视觉质检、产线瑕疵检测,搭配 DI/DO 接口直接联动产线设备。
3. 高参数量大模型,7B‑30B LLM、超长上下文 VLM 任务
选用 HM50 存算一体算力模组,最高 48GB 大显存,支持 Qwen3‑30B 等百亿级模型本地部署,高显存带宽解决端侧推理 “内存墙” 痛点,处理长文档、大分辨率图像多模态任务表现突出。
实测数据参考(官方 2026‑01 测试)
DA060R 搭配 R182X 运行 Qwen2.5‑7B,输入输出各 128Token 条件下,解码 TPS 可达 70.26;HM50 24GB 版本可本地跑通 Qwen3‑30B 大模型,实现真正离线私有化部署,不依赖云端 API。
DA060R 整机同时支持 M.2 SSD 本地高速存储,M.2 B‑Key 接口扩展 4G/5G、WiFi6,一套硬件同时解决算力扩展、本地存储、无线通信需求。
总结
选择 M.2 算力模组,峰值算力只是参考指标,显存大小、带宽、功耗、温度适应性、驱动适配、真实模型跑分,才是项目落地关键。DA060R 整套方案已经完成主流开源大模型适配验证,可提供性能测试报告,方便客户前期 POC 验证。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部

 商城