
 商城
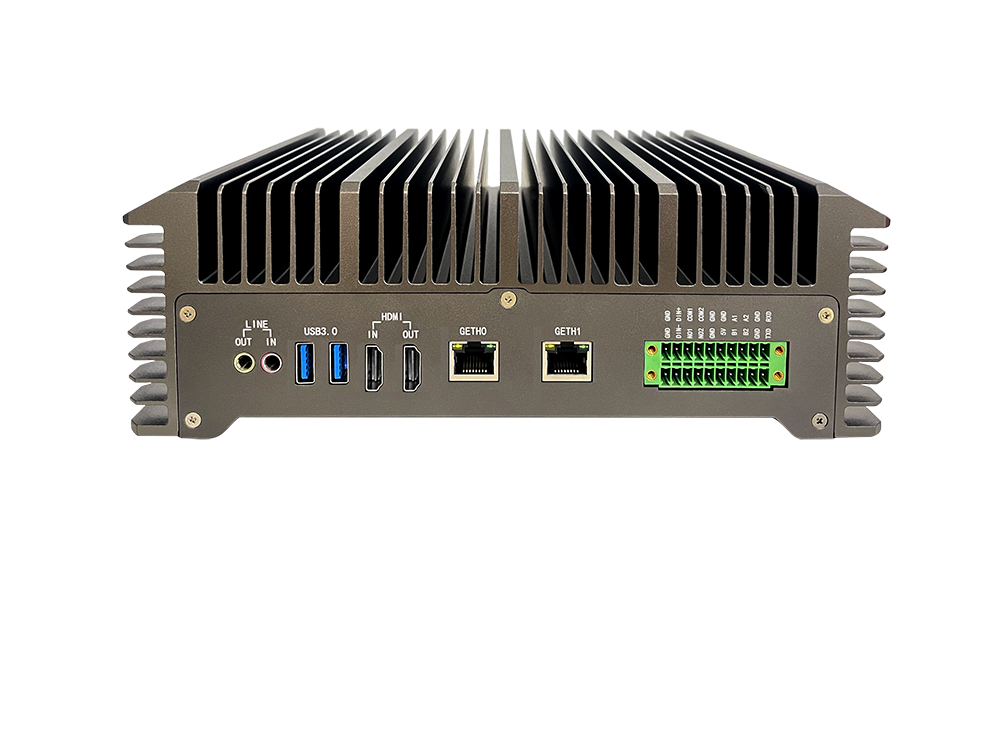
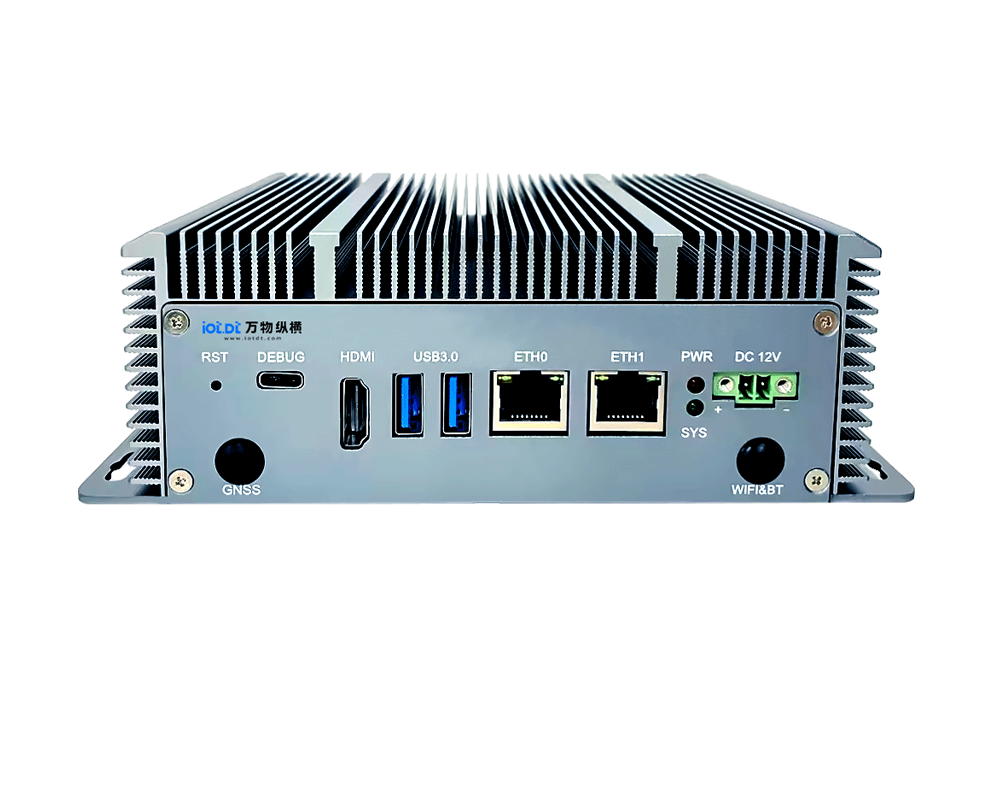
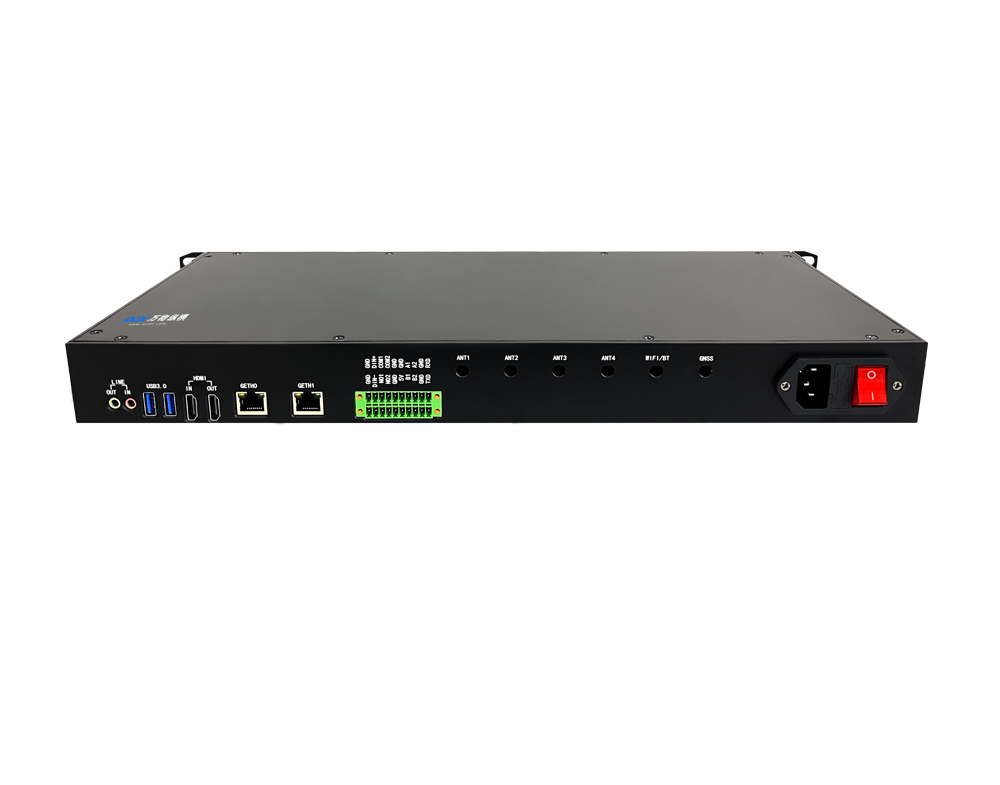
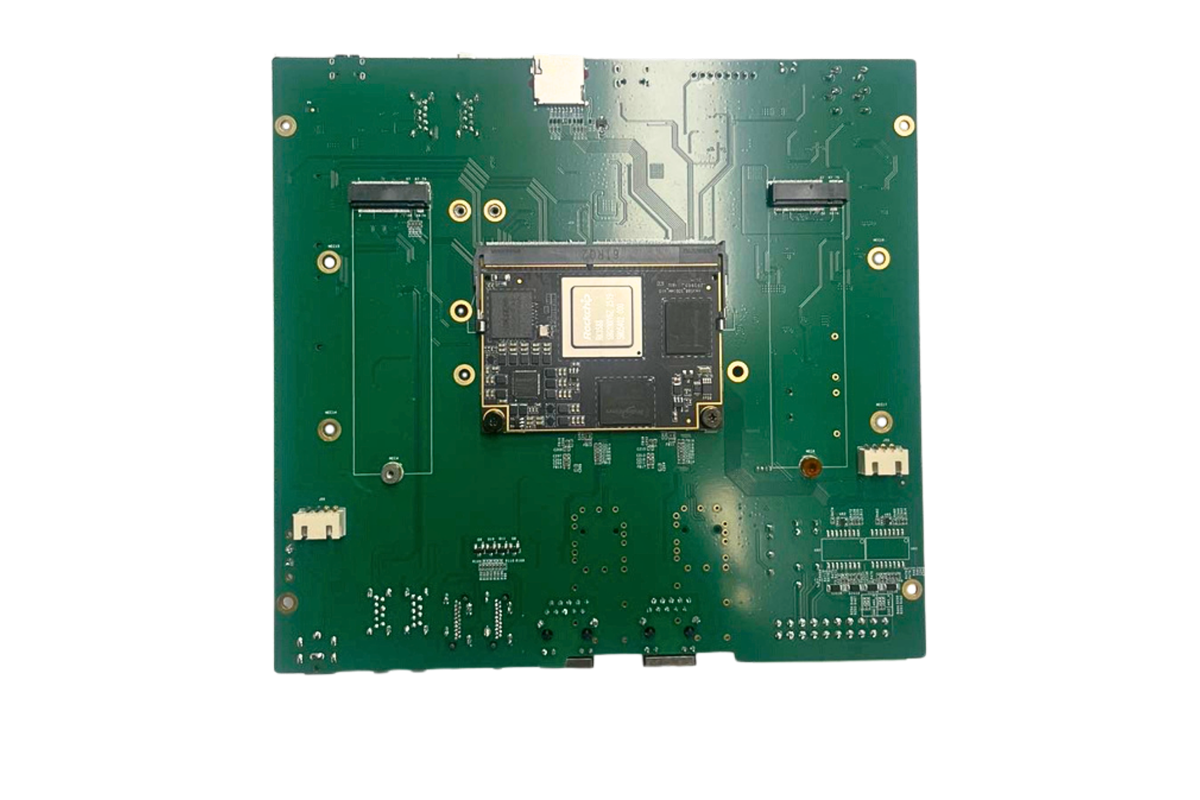
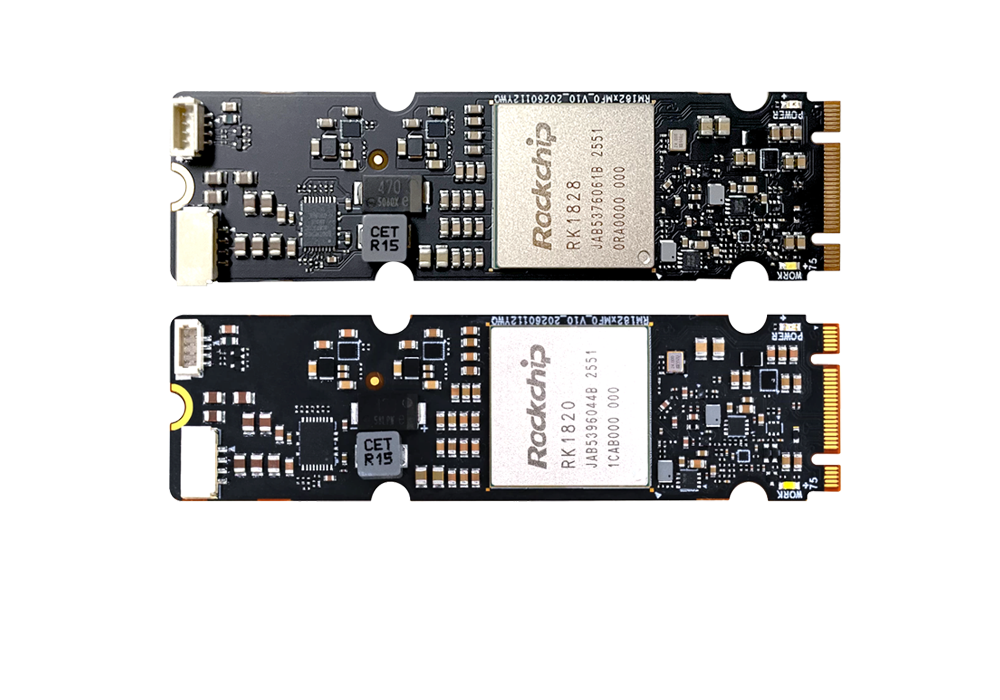
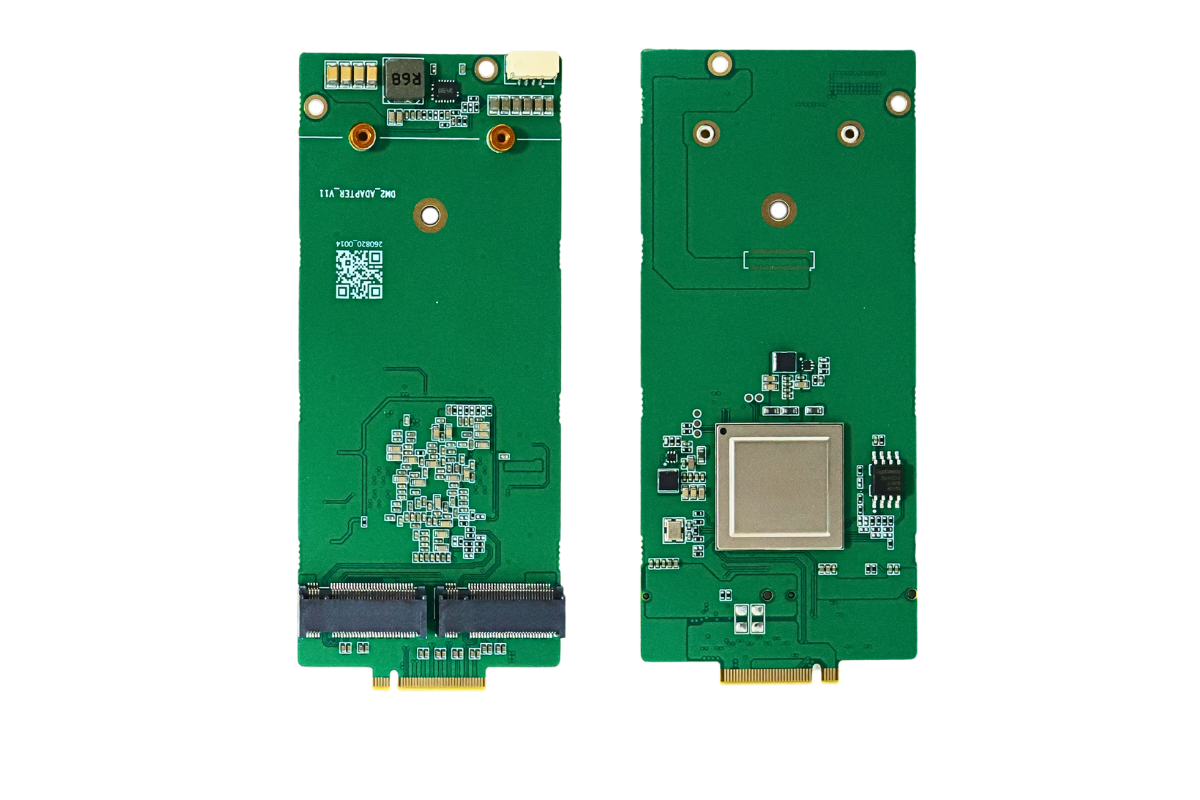


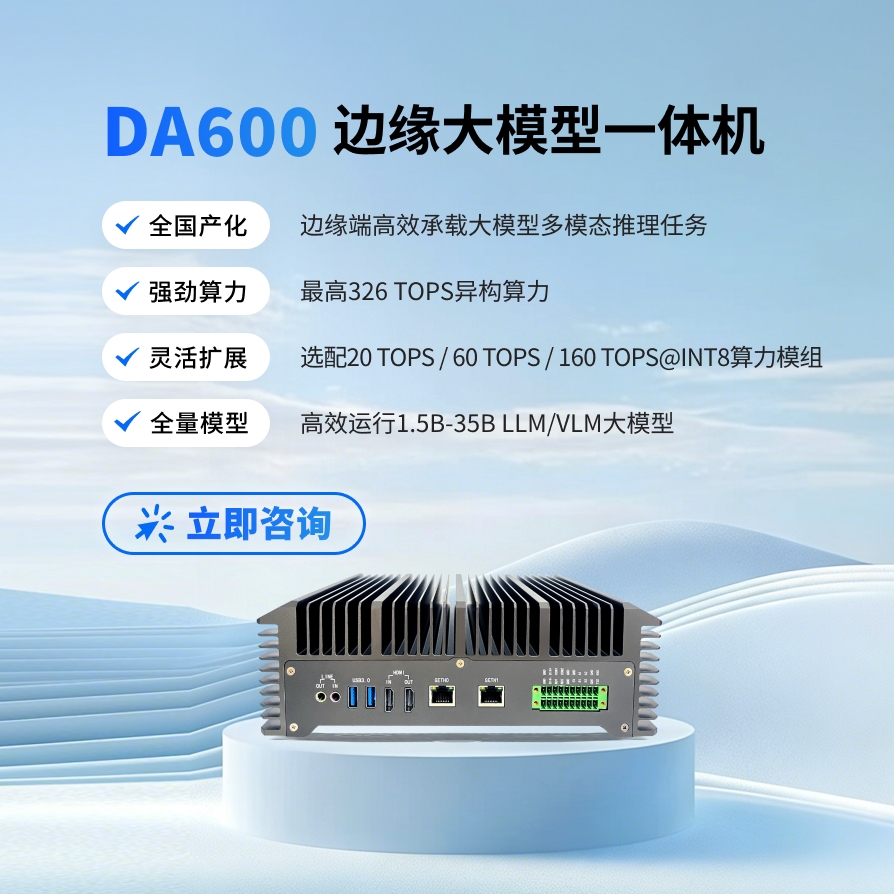
在本届上海工博会新一代信息技术展区,多款基于算能 BM1688 芯片的国产边缘 AI 算力盒子集中亮相,标志着国产化边缘推理硬件正加速走进工业、安防、智慧物联真实场景,云边协同方案落地门槛持续降低。
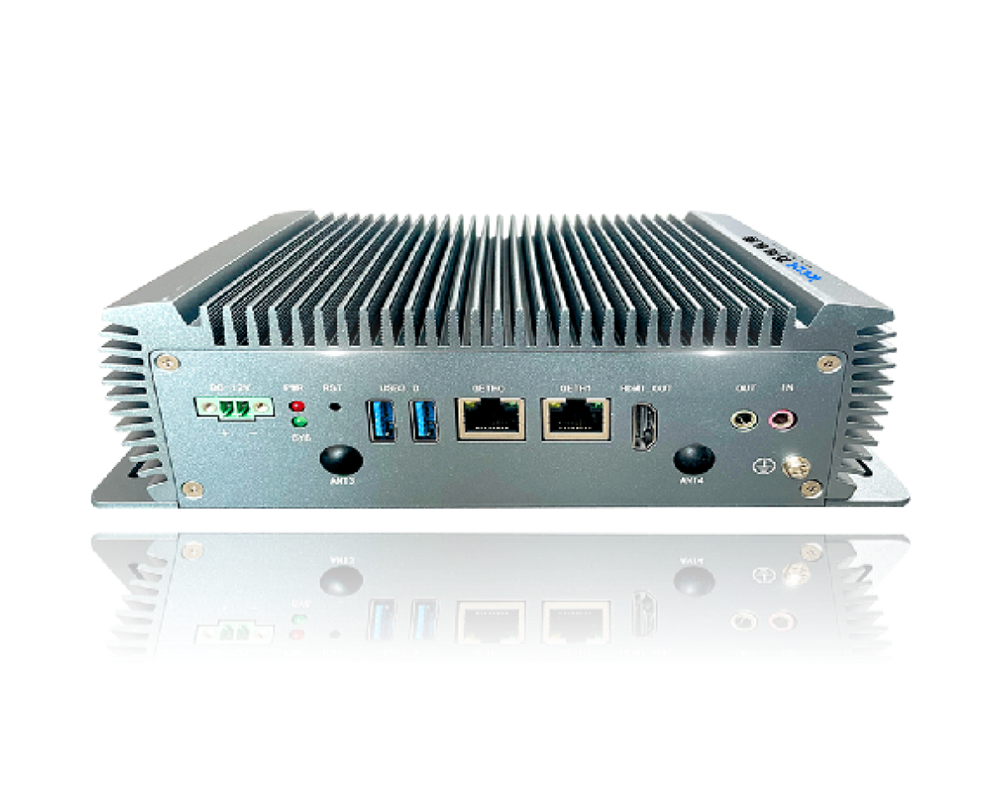
核心硬件规格
BM1688 是算能推出的第二代边缘 TPU 处理器,采用 8 核 Cortex‑A53@1.6GHz,内置自研 TPU 神经网络加速引擎:
INT8 峰值算力:16TOPS,INT4 可达 32TOPS,FP16/BF16 为 4TFLOPS
视频能力:最高支持 16 路 1080P H.264 解码,可同时完成多路视频解码 + AI 推理全链路处理
内存配置:主流版本 8GB/16GB LPDDR4,搭配 32GB/64GB eMMC 存储
接口:双千兆网口、HDMI、USB3.0,工业款拓展 RS485、RS232、CAN 总线、DI/DO,适配工控设备对接
结构:全金属铝合金壳体,被动散热,宽温稳定运行,支持嵌入式安装与壁挂部署
能力亮点
1. 兼顾机器视觉 + 小参数大模型本地私有化部署
除传统视觉任务(目标检测、车牌识别、缺陷检测、人脸识别),可本地运行 Qwen、Gemma、Llama2、ChatGLM 等轻量大模型,支持 Docker 容器化部署,不用依赖云端,保障数据不出本地,降低网络延迟。
2. 国产全栈生态,降低工程落地成本
配套算能 Sophon SDK,支持 PyTorch、TensorFlow 主流框架模型一键转换,算法移植周期短;多家国内厂商(Firefly、英码、深算工场、全爱科技等)都推出 BM1688 算力盒子,硬件选型丰富,供应链自主可控。
3. 工业级稳定性,适配多行业边缘场景
丰富工业总线接口、宽温抗干扰设计,广泛用于工业视觉质检、智慧工地、明厨亮灶、园区安防、智能楼宇、无人零售、电力巡检等场景,替代部分进口边缘算力硬件方案。
产业意义
此前边缘 AI 市场很多依赖海外芯片,BM1688 这类中端国产边缘算力芯片,定位介于 CV 系列低算力芯片与 BM1684X 高算力芯片之间,16TOPS 算力刚好匹配绝大多数多路视频边缘推理需求,成本更友好,非常适合规模化批量部署。
工博会集中展出,也体现一个趋势:国产边缘算力不再只停留在芯片样片阶段,已经形成 “芯片 主板 算力盒子 行业算法” 完整产品矩阵,正在从试点项目走向大规模商业化落地。
和 BM1684X 简单对比
项目 | BM1688 | BM1684X |
INT8 算力 | 16TOPS | 32TOPS |
CPU | 8 核 A53@1.6G | 8 核 A53@2.3G |
定位 | 中端边缘,多路视觉 + 小模型 | 高性能边缘,高密度视频流 |
成本 | 更低,适合批量项目 | 偏高,重度推理场景 |
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部