
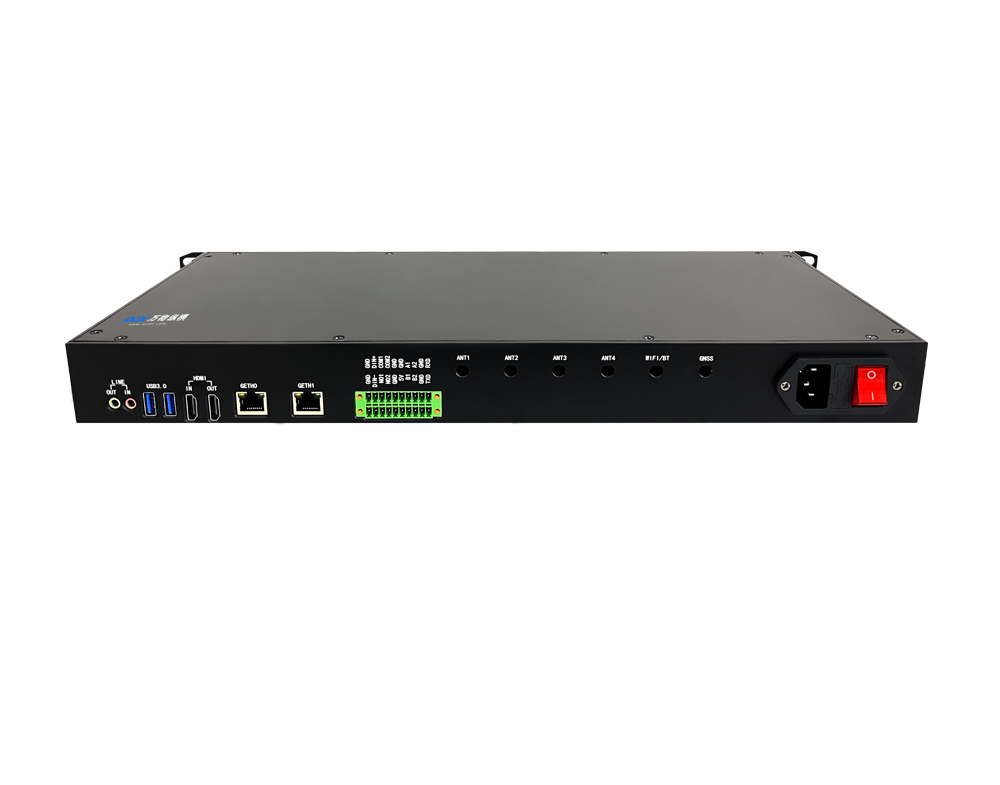
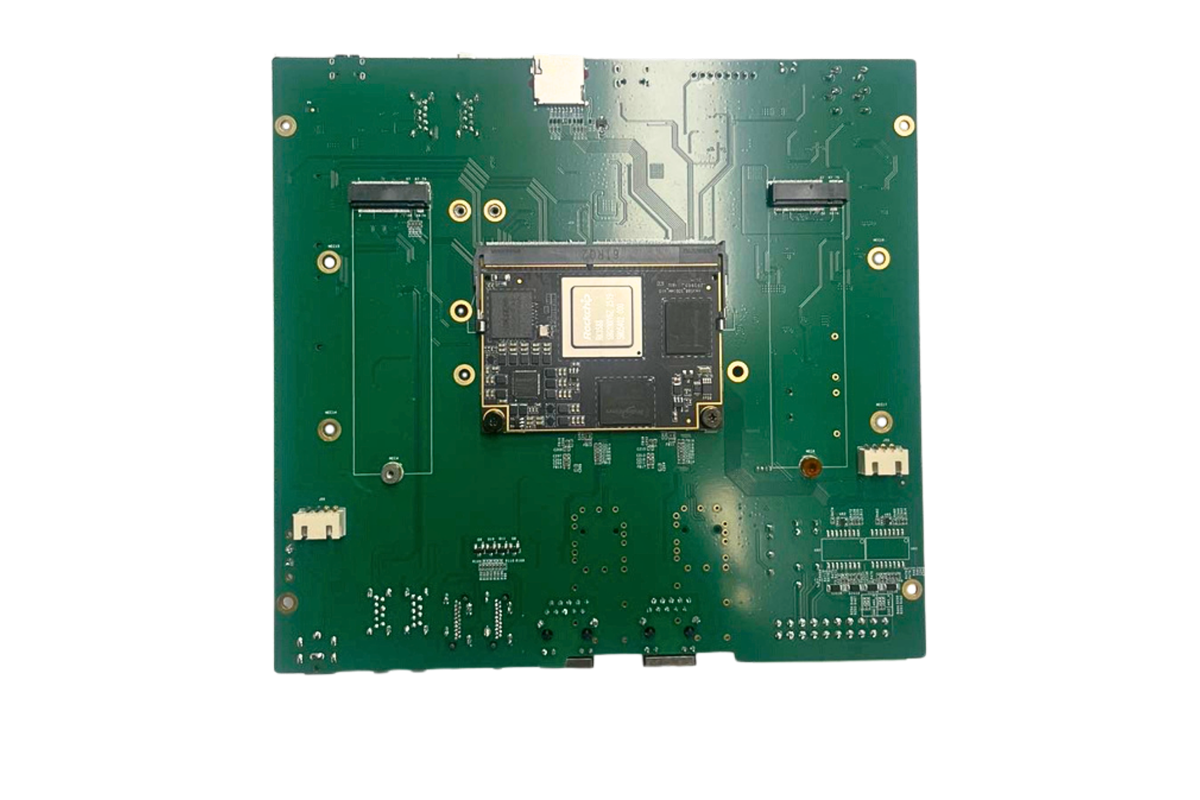
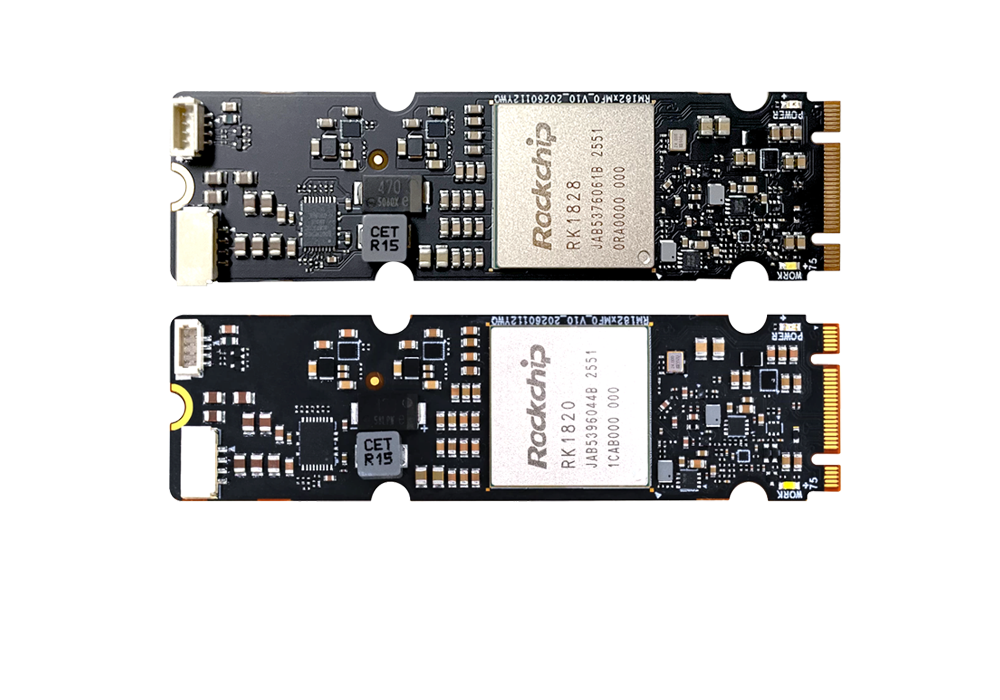
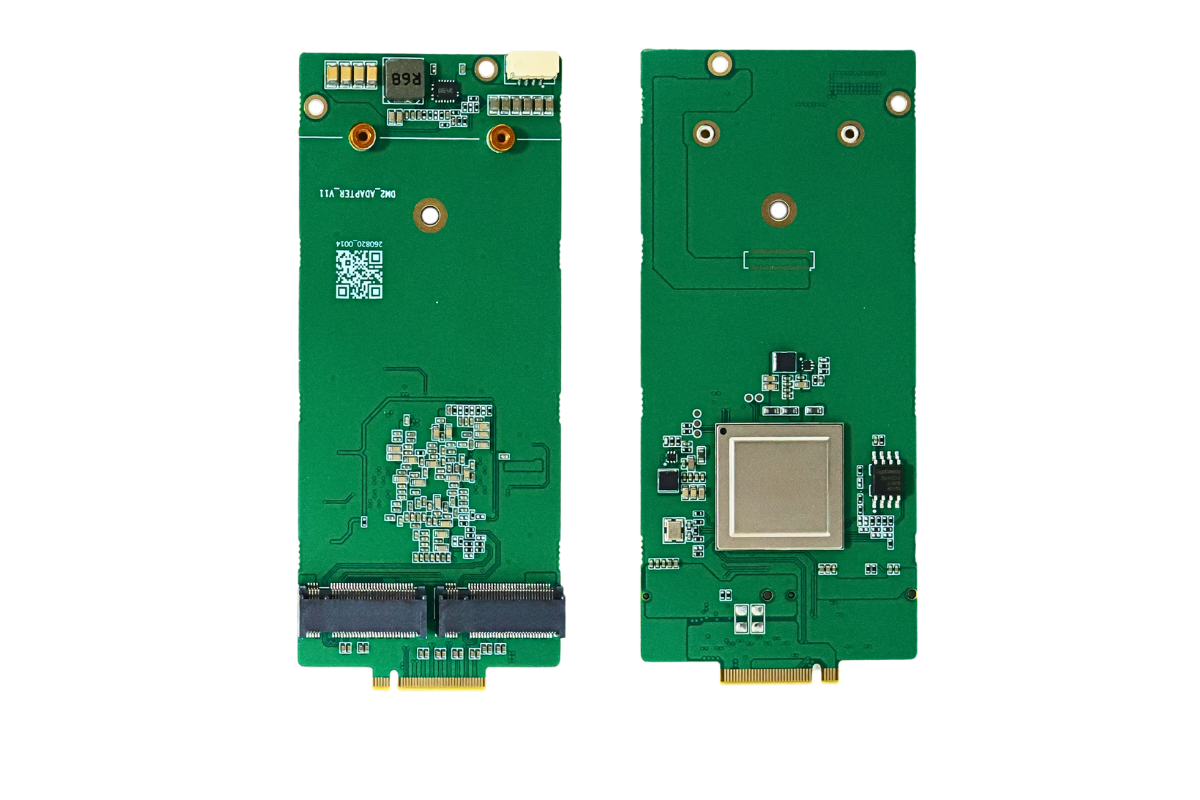


在 2026 全球 AI 芯片峰会上,后摩智能披露下一代端边旗舰 AI 芯片,采用3D CIM 三维存算一体架构,融合存算核心与 3D DRAM 垂直堆叠技术,主打高性能边缘盒子、本地大模型推理场景,解决传统芯片 “存储墙” 瓶颈。
一、核心技术亮点
1. 3D 垂直堆叠,算力密度翻倍
相比当前量产 M50(2D SRAM 数字 CIM),新一代 3D CIM 把计算阵列和存储层垂直堆叠,同等芯片面积下算力提升至 2 倍,同时优化功耗、散热,适配边缘盒子紧凑机箱空间,适合多路视频、本地大模型 Agent 高并发推理。
现有 M50:INT8 160TOPS,典型功耗 10W,最高 48GB 内存,PCIe4.0+HM-Link 片间互联,已超 150 款产品定点,用于边缘盒子、AI 主机、机器人等。
2. CIM 存算一体底层优势延续并升级
延续后摩SRAM 数字 CIM路线,计算直接在存储单元内完成,大幅减少显存与计算单元之间的数据搬运开销;叠加 3D DRAM 堆叠,带宽、容量同步跃升,适配更大参数模型本地离线推理,保障端边数据不出本地,满足安防、工业、智慧工地等隐私场景。
3. 定位:高性能边缘盒子 + 端边大模型智能体
目标打造具备端侧超实时思考、多轮交互能力的芯片,面向边缘计算盒子、工业边缘服务器、本地 AI Agent 主机;支持多芯互联扩展算力,适合多路视频分析、大模型本地问答、具身机器人等复合任务。
二、与 M50 的代际差异
项目 | 漫界 M50(当前量产) | 下一代 3D CIM 芯片(研发中) |
架构 | 2D SRAM 数字存算一体 | 3D CIM,存算阵列 + 3D DRAM 垂直堆叠 |
算力密度 | 基准 | 同面积算力 ×2 |
核心场景 | 边缘盒子、AI PC、机器人 | 高性能边缘盒子、多并发本地大模型 Agent |
优势 | 成熟量产、定点丰富 | 更高带宽、更大内存容量、更强能效 |
三、产业意义
传统边缘 AI 盒子最大瓶颈是访存带宽不足,大模型推理卡延迟。3D CIM 把存、算做三维堆叠,从架构层面缓解存储墙。后摩这条路线,是国内少数从2D SRAM CIM 量产芯片向3D 堆叠存算一体演进的端边芯片方案,直接对标边缘盒子、本地大模型硬件赛道,和瑞芯微、算能、力擎等边缘算力芯片形成差异化竞争。
时间节点:该芯片尚处于研发阶段,暂未公布完整规格,计划明年推出。
请用手机扫码查看分享内容
 下一篇:算能更新BM1684X模型优化工具,大幅简化边缘盒子大模型、多模态算法部署
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)


 试用申请
 产品咨询
 在线客服
 回到顶部