


边缘 AI 算力选型的核心矛盾,是纸面参数与落地效果的落差。很多方案踩坑,本质是只看峰值 TOPS,忽略了内存带宽、散热稳定性、软件适配、量产可行性等关键维度。后摩智能力擎® LQ50 Duo(现产品名 LM5020 DM.2)成为行业高频选择,正是因为它精准命中了边缘大模型时代的选型痛点,逐一规避了常见陷阱。
一、边缘 AI 算力选型的 6 个核心避坑点
常见陷阱 | 选型误区 | 落地风险 |
唯峰值 TOPS 论 | 只对标 INT8 峰值算力,忽略内存带宽与实际推理效率 | 边缘大模型推理的核心瓶颈是内存墙,带宽不足会导致数据搬运延迟,实际帧率、首字延迟远低于标称值;同标称算力下,高带宽方案的实际推理性能可能是低带宽方案的 2 倍以上。 |
功耗散热失控 | 只看峰值功耗,不看典型功耗与散热设计 | 密闭、无风扇的工业/户外场景中,高功耗模组满载后极易触发热节流,出现“前 5 分钟满速、后续性能腰斩”的情况,甚至缩短设备寿命、拉高故障率。 |
大模型适配难 | 只看硬件算子,忽视推理框架、量化工具与预优化模型库 | 方案商需花费数周甚至数月做模型迁移与精度调优,还可能出现量化后精度暴跌、自定义算子无法加速的问题,开发成本远超硬件本身。 |
内存容量不足 | 沿用传统边缘模组 8~16GB 内存的配置思路 | 当前边缘侧已需部署 7B~70B 参数大模型、多模态模型及多任务并发,内存不足会导致模型无法运行,或只能使用重度压缩版本牺牲效果。 |
硬件非标化 | 只验证 Demo,不评估接口、尺寸与整机参考设计 | 自定义接口、非标尺寸缺少通用参考设计,原型验证容易,但量产阶段需重新设计结构、供电与散热,周期拉长 3~6 个月,错过市场窗口。 |
算力弹性差 | 单芯片固定算力,或依赖多卡堆叠扩容 | 业务升级更大模型、更多路并发时,只能整体更换设备,前期投资作废;多卡堆叠又会大幅增加体积、功耗与硬件成本,无法适配边缘设备的空间限制。 |
二、后摩 LQ50 Duo 成为方案商优选的核心原因
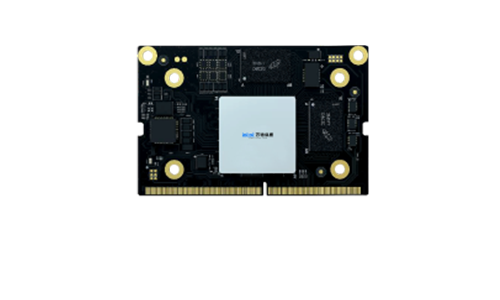
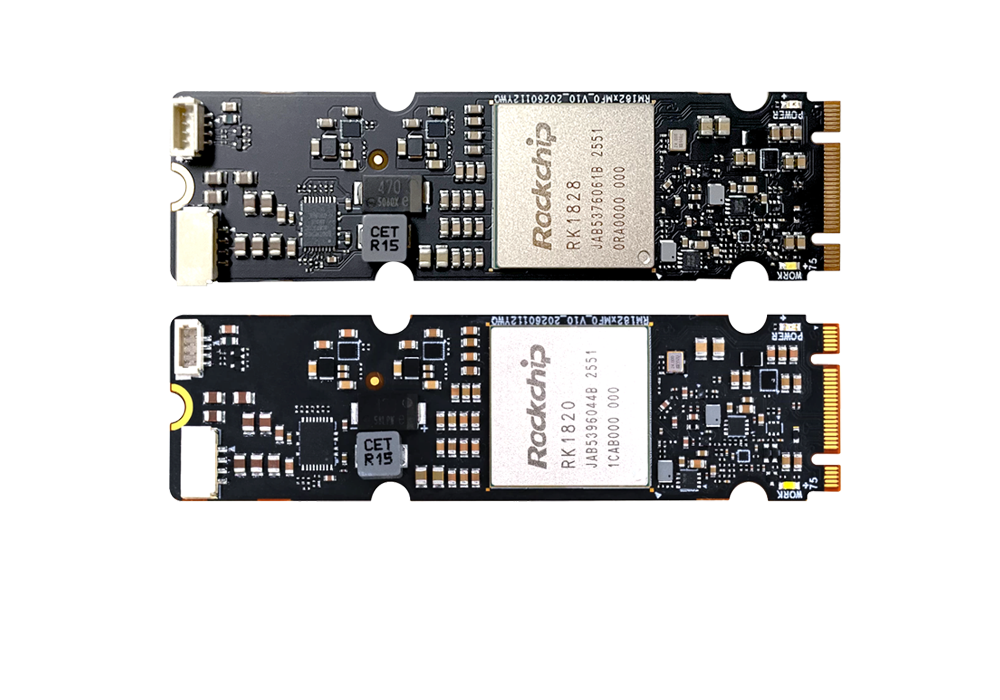
LQ50 Duo 是基于后摩 M50 存算一体架构的双芯 M.2 模组,针对上述选型痛点设计,在算力密度、内存配置、功耗控制、软件生态和量产适配五个维度实现了平衡。
1. 存算一体 + 超高带宽,把纸面算力转化为落地性能
集成 2 颗后摩漫界® M50 存算一体芯片,提供 320 TOPS @INT8 弹性算力与 200 TFLOPS @bFP16 浮点算力。
搭配最高 96GB LPDDR5/5X 内存,内存带宽达 307.2 GB/s。
存算一体架构从底层突破内存墙,大幅降低数据搬运延迟;原生支持 bFP16 浮点精度,无需强制 INT8 量化,避免精度损失,减少调优工作量,实际推理表现更接近标称值。
2. 精细化功耗控制,适配边缘严苛散热环境
典型功耗 ≤26W,在标准 M.2 尺寸下实现双芯大算力的低功耗控制。
支持多级功耗模式,超低待机功耗低至 8mW,可适配不同负载的动态功耗需求。
无风扇、密闭外壳的工业边缘设备可通过被动散热稳定运行,避免长时间满载后的热降频,保证 7×24 小时工况下的性能一致性,降低量产故障率。
3. 全栈软件生态,大幅降低大模型部署门槛
配套自研后摩大道®软件平台,深度适配 vLLM 等主流大模型推理框架,提供开箱即用的 ModelZoo 与行业领域套件。
支持主流 CV、NLP、多模态模型一键部署;内置静态编译器与自动优化算子库,提供全套 C++/Python API,兼容 Win11、Linux、Android 多系统。
提供专业量化工具,可灵活切换精度档位;方案商无需投入大量人力做底层适配,开发周期可缩短 60% 以上。
4. 超大内存 + 双芯互联,支撑边缘大模型全场景
最高 96GB 大内存,可支撑千亿参数大模型的本地化私有化部署,同时运行多模态感知、AI Agent、多任务并发等复杂负载。
双芯高速互联架构可灵活分配算力资源:例如一路芯片跑视觉多路分析,另一路跑大语言模型决策。
适配智慧安防、工业质检、智能会议、边缘机器人等多模态场景。
5. 标准接口 + 成熟生态,量产落地效率高
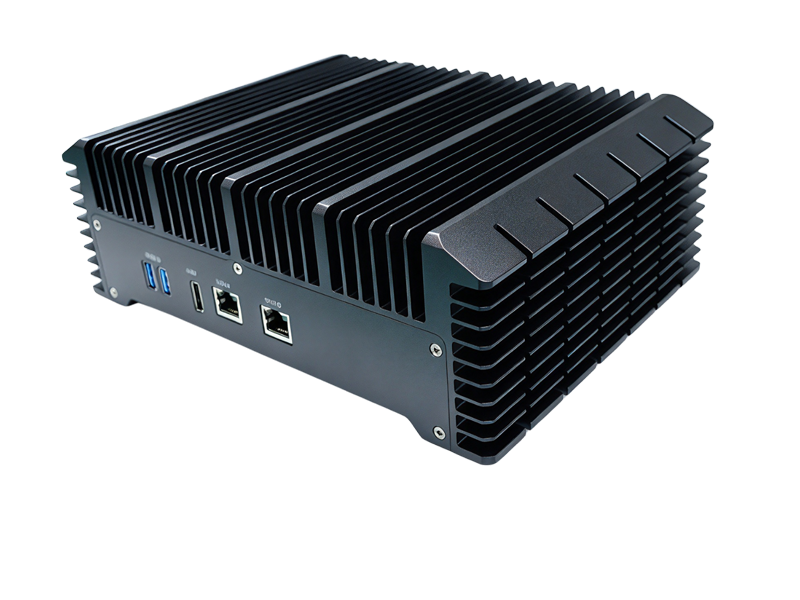
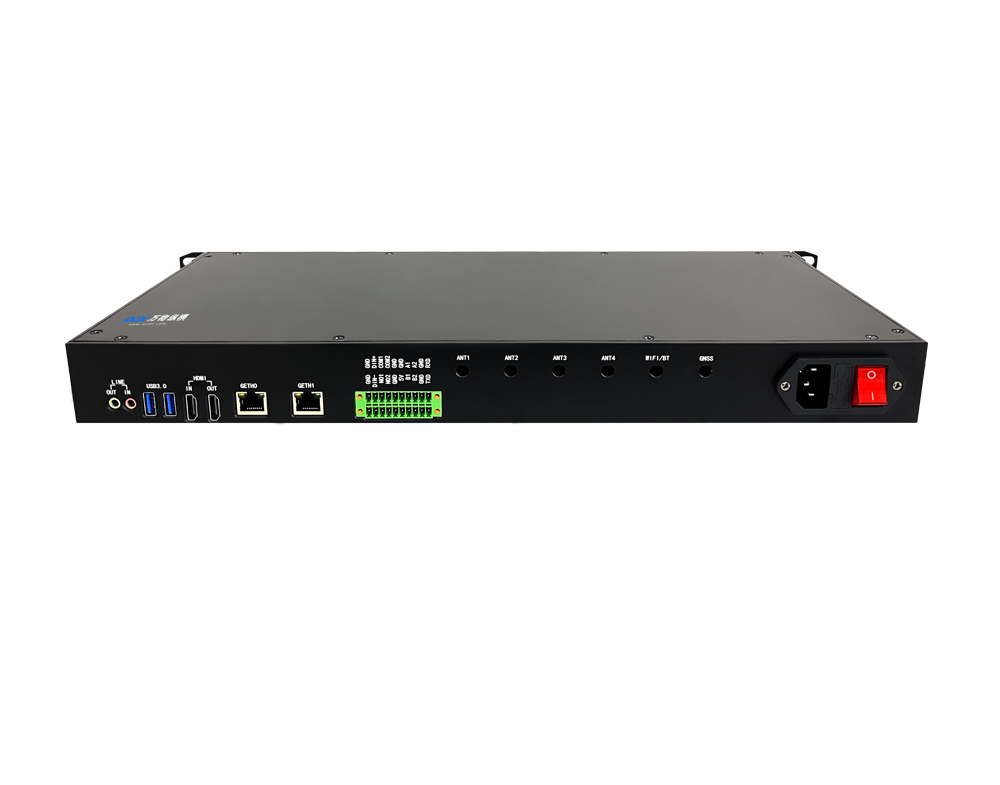
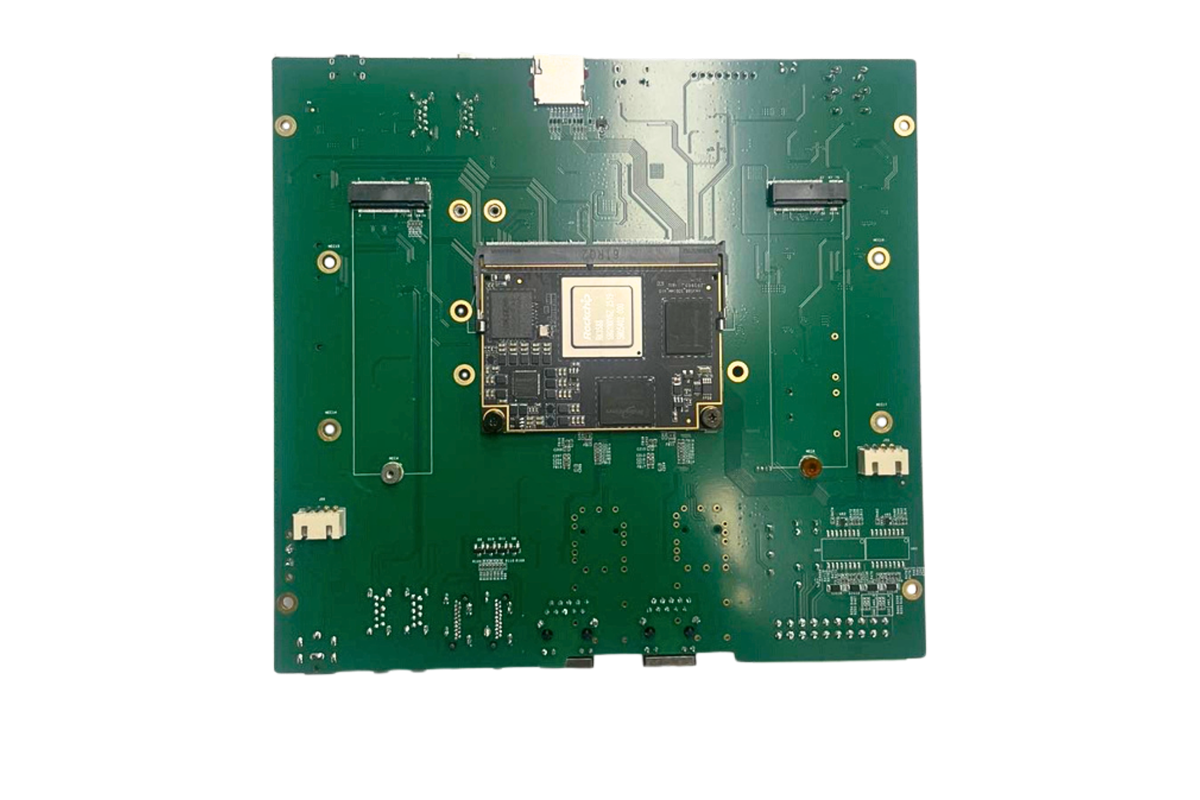
采用标准 M.2 M-Key PCIe Gen4 ×8 接口,尺寸 46×80mm,兼容通用硬件设计,可直接嵌入边缘盒子、工控机、AI PC 等设备。
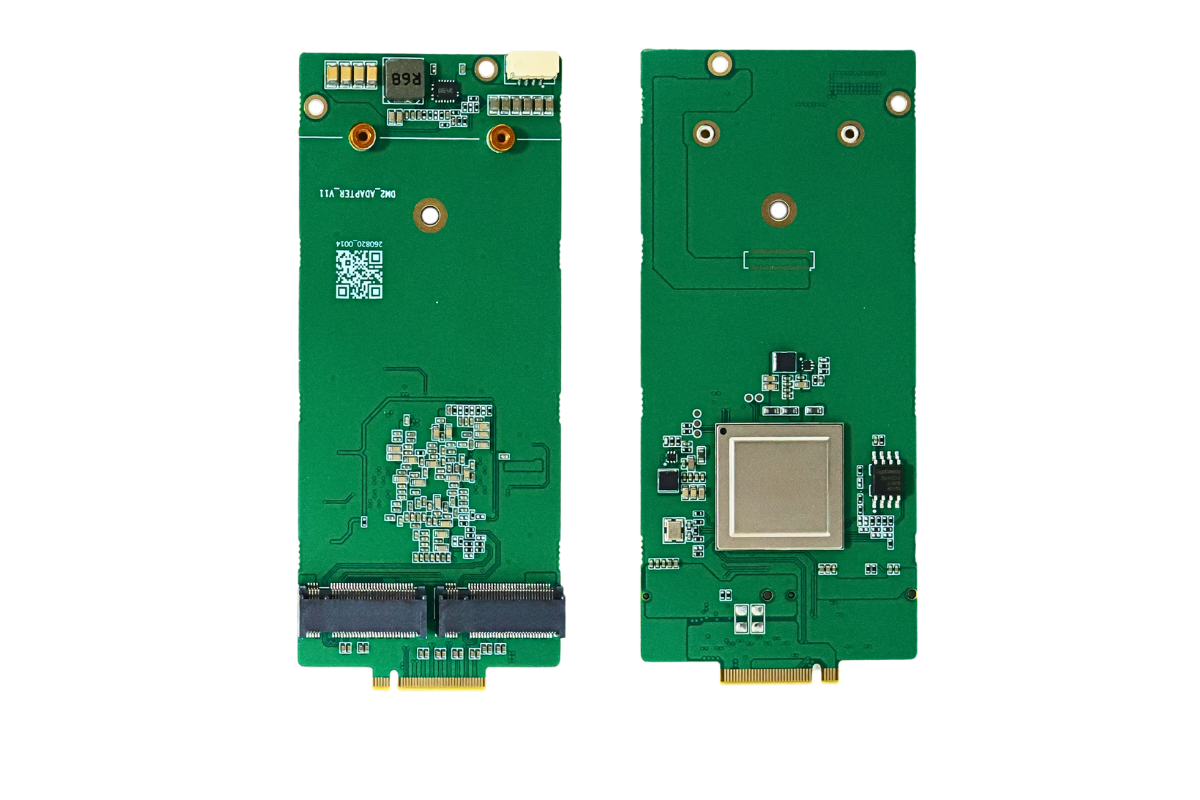
已有 Firefly 等多家行业厂商推出适配开发套件与参考设计,方案商可快速完成原型验证。
从开发板到量产模组无缝切换,避免“Demo 验证顺利、量产适配卡壳”的行业通病。
6. 高算力密度与性价比,降低全生命周期成本
单张 M.2 模组实现双芯算力,无需多卡堆叠,节省设备内部空间,降低整机 BOM 成本。
提供单芯、双芯不同档位,可根据场景灵活选型,避免算力浪费。
模块化设计支持后续算力升级,无需更换整机设备,仅需替换算力模组即可适配更大模型,保护前期硬件投资。
三、总结
边缘 AI 已经从“单视觉小模型”进入“大模型多模态”的新阶段,选型逻辑也从“拼算力参数”转向“拼落地综合能力”。LQ50 Duo 的核心竞争力,是在边缘设备有限的体积、功耗、成本约束下,实现了大模型部署的可用性、稳定性和量产性,因此成为众多方案商布局边缘大模型业务的首选硬件。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部