
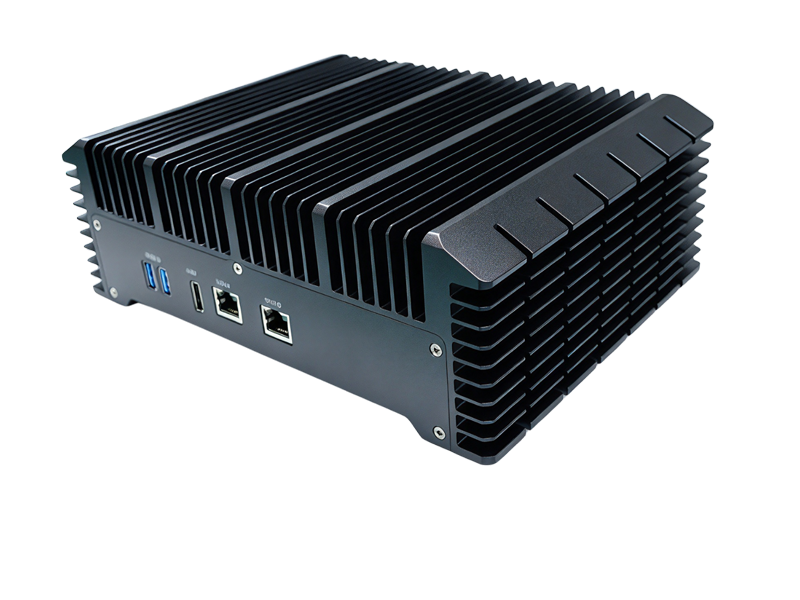
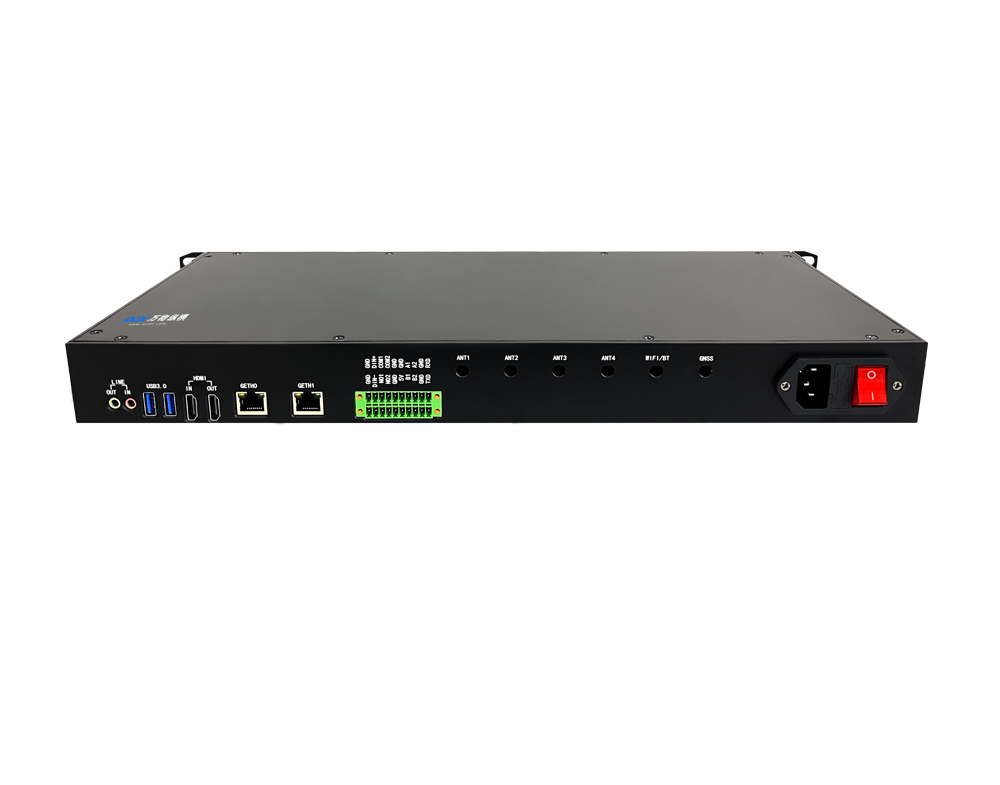
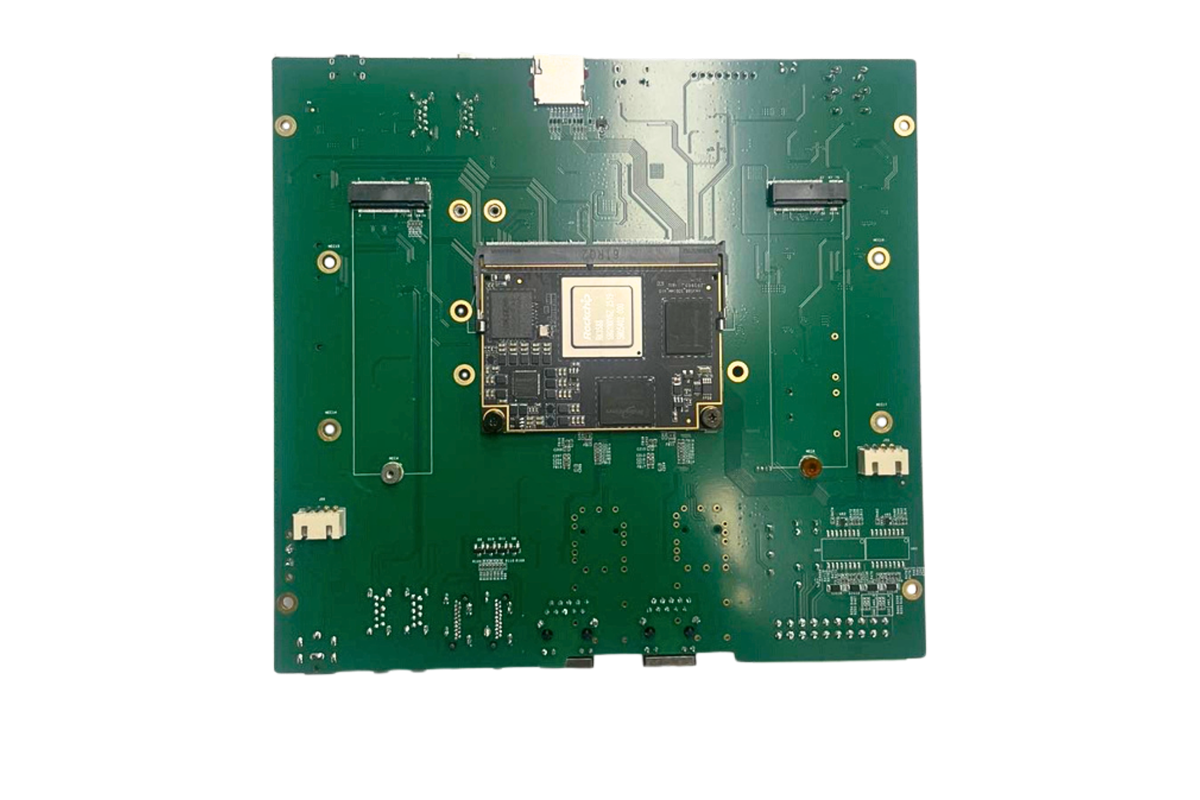


一、RK1828 算力卡核心基础规格
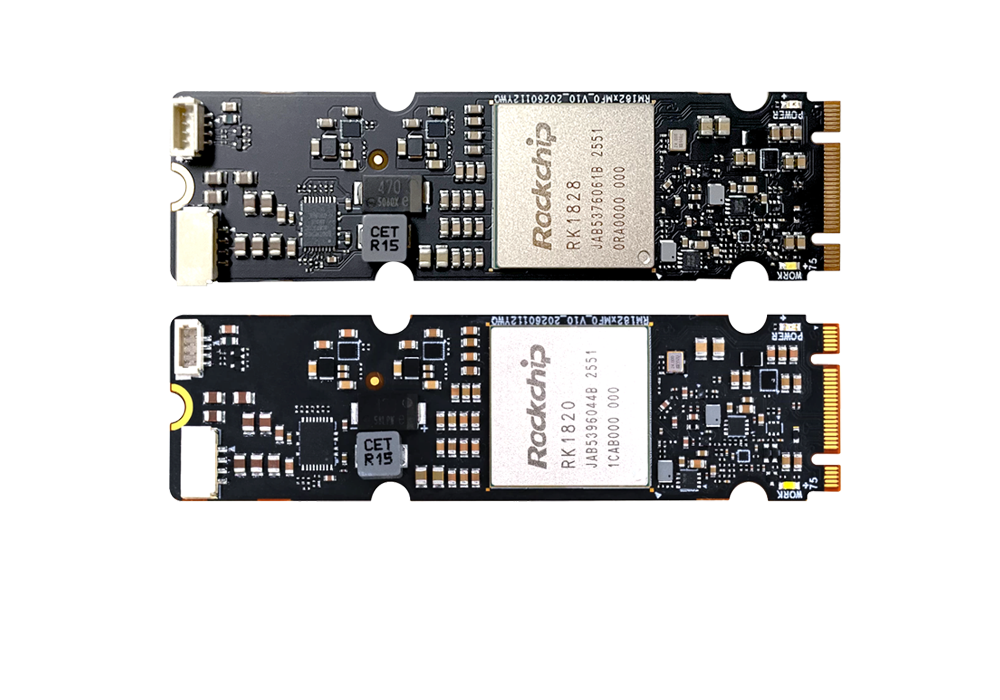
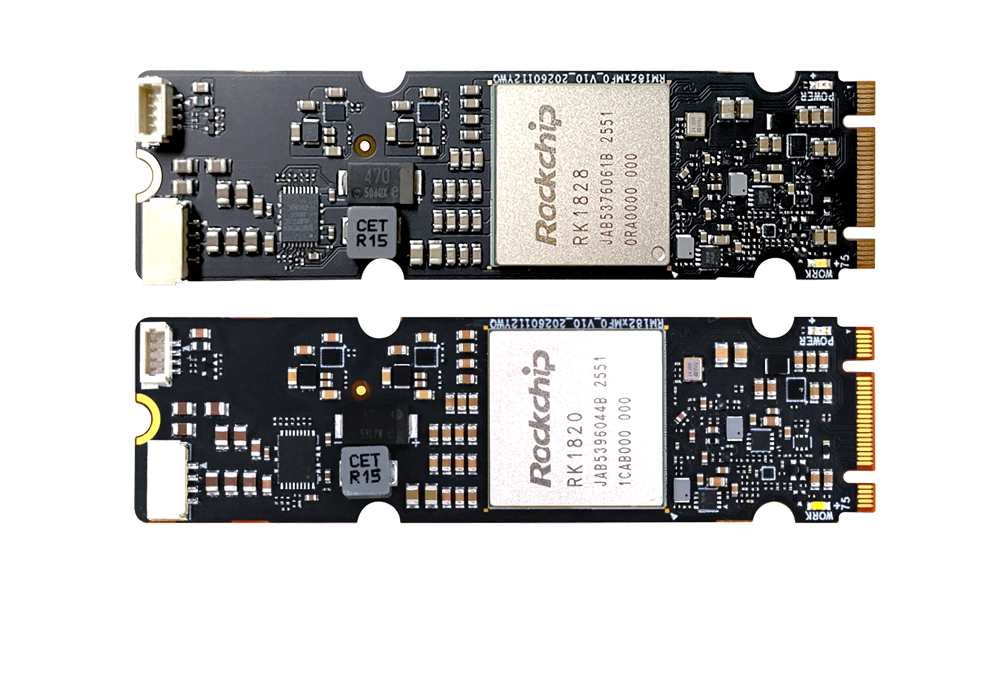
RK1828 是瑞芯微推出的端侧 AI 协处理器算力卡,主打边缘端低功耗大模型推理,核心硬件参数如下:
AI 算力:20 TOPS(INT8),INT4 量化下等效算力翻倍,支持 INT4/INT8/INT16/FP8/FP16/BF16 混合精度计算。
显存配置:内置 5GB 3D 堆叠高带宽 DRAM,带宽达 1TB/s 级别,无需外接显存即可承载 7B 级量化模型,规避端侧“内存墙”问题。
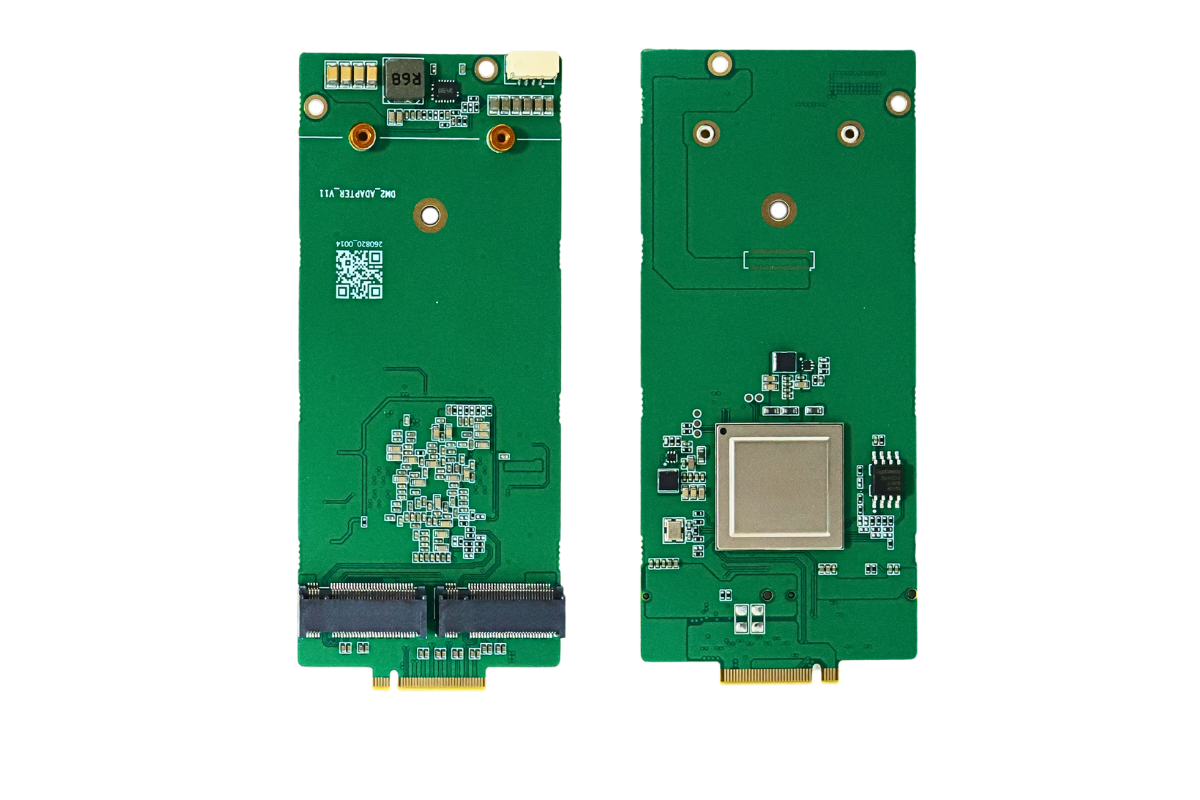
接口形态:主流 M.2 2280(Key B-M)、SODIMM 两种形态,通过 PCIe 2.1 / USB3.0 与 RK3588、RK3576 等主控 SoC 连接。
功耗控制:单卡满载推理功耗约 10W,风冷即可稳定运行,适配边缘嵌入式设备。
软件生态:配套 RKNN3 SDK V1.0.0 全栈工具链,覆盖模型转换、量化、部署全流程。
二、7B 大模型推理实测性能
以下测试均基于 RK3576/RK3588 主控 + RK1828 算力卡硬件组合,采用 W4A16/group32 混合量化策略(Transformer 层 INT4 量化、输出层高精度保留),模型均为端侧常用的对话/推理版本。
1. Qwen 系列 7B 模型实测
Qwen 是瑞芯微官方深度优化的模型系列,适配度最高,性能表现最优:
模型版本 | 接口形态 | 输入 Token | 上下文长度 | 首字延迟 TTFT | 生成速度 Decode TPS | 数据来源 |
Qwen2.5-7B | SODIMM | 128 | 1024 | 155.46 ms | 69.68 tokens/s | 创龙科技实测 |
Qwen2.5-7B | M.2 2280 | 128 | 1024 | 176.70 ms | 67.23 tokens/s | 创龙科技实测 |
Qwen2.5-7B | PCIe | 1024 | 2048 | 1280.04 ms | 59.48 tokens/s | 飞凌嵌入式实测 |
Qwen3-8B(参考值) | PCIe | 128 | 1024 | 182.20 ms | 61.34 tokens/s | DFRobot 实测 |
Qwen3-7B 性能推算:结合 Qwen3-4B(约 69~88 tokens/s)与 Qwen3-8B(约 50~61 tokens/s)的实测数据,Qwen3-7B 在 RK1828 上单卡推理速度约为 55~65 tokens/s,短上下文首字延迟可控制在 160ms 以内,长文本生成速度稳定,完全满足日常人机对话的流畅度需求(人眼流畅阈值约 20 tokens/s)。
官方云栖大会现场演示中,Qwen2.5-7B 实现了 50+ tokens/s 的稳定输出,首帧延迟 160ms 左右,交互体验接近云端小模型水平。
2. DeepSeek 7B 适配与性能表现
目前官方未放出 DeepSeek 7B 的专属实测数据,但基于 RKNN3 SDK 的通用适配能力,可得出以下结论:
兼容性:DeepSeek-R1-Distill-Qwen-7B 等基于 Qwen 架构蒸馏的 DeepSeek 模型,可直接复用 Qwen 系列的算子优化,转换部署无明显障碍;原生 DeepSeek 架构模型需做算子适配,整体兼容度良好。
性能预估:同参数量下,DeepSeek 7B 推理速度与 Qwen2.5-7B 接近,INT4 量化后稳定在 50~60 tokens/s;由于 DeepSeek-R1 系列包含思考链(Thinking)过程,有效回答的生成速度会略低于纯对话模型,整体仍处于可用区间。
精度表现:W4A16 量化后数学推理、代码生成等核心能力保留度较高,适合边缘端轻量推理、本地知识库问答等场景。
三、部署流程与开发体验
1. 完整部署链路
RK1828 部署 7B 大模型遵循“PC 端转换 → 板端加载运行”的标准流程,门槛较低:
1. 硬件安装:将算力卡插入主控板的 M.2/SODIMM 插槽,上电后安装 PCIe 驱动,通过 rknn-smi info 命令验证设备识别与算力状态。
2. 模型转换:在 PC 端使用 RKNN3 Toolkit,将 HuggingFace/ModelScope 下载的 GGUF/ONNX 格式模型,进行量化、图优化,转换为专属的 .rknn 模型文件;支持一键开启 W4A16、INT8 等量化策略。
3. 板端运行:将转换好的模型文件拷贝至主控板,通过 C++ API、Python API 或 rkllm3_server 服务加载推理;rkllm3_server 提供兼容 OpenAI 的 HTTP 接口,可直接对接现有业务系统。
4. 应用开发:官方提供 Web 聊天界面、RAG 知识库问答等参考示例,可快速搭建离线对话系统、行业私有知识库等方案。
2. 开发体验亮点
生态完善:SDK 覆盖 Linux、Android 双系统,提供完整的 Model Zoo 示例仓库,Qwen、MiniCPM、Gemma 等主流模型均有现成转换脚本,开箱即用。
功能齐全:原生支持 mRoPE 位置编码、Function Call 工具调用、多轮对话上下文管理,可直接开发 Agent 类应用。
扩展灵活:支持多卡级联,算力线性叠加,2 卡可流畅跑 9B 模型,4 卡可跑 27B 大模型,按需扩容成本可控。
低延迟优势:内置高带宽显存 + 推理传输并行优化,短对话首字延迟远低于同算力的外接显存方案,交互体感更跟手。
3. 注意事项
7B 模型建议优先使用 W4A16 量化,可完全容纳于 5GB 内置显存,避免显存溢出和带宽瓶颈;若追求更高精度,INT8 量化需精简上下文长度。
原生 DeepSeek 模型需自行适配部分算子,建议优先选择基于 Qwen 蒸馏的版本,减少调试工作量。
USB 接口版本相比 PCIe 版本,推理速度损失约 5% 以内,长上下文 Prefill 阶段延迟略有上升,高并发场景优先选 PCIe 接口。
四、总结与适用场景
RK1828 单卡跑 7B 级大模型是当前边缘端性价比极高的方案:
Qwen 系列是最优选择,官方深度优化后性能拉满,55~70 tokens/s 的生成速度足以支撑智能客服、工业交互、智能座舱等绝大多数场景。
DeepSeek 系列适配成本低,推理能力保留完整,适合需要本地逻辑推理、数学计算的边缘场景。
整体方案兼具低功耗、离线可用、数据隐私性强的优势,无需依赖云端,特别适合工业质检、机器人、车载座舱、安防网关等端侧部署场景。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部