
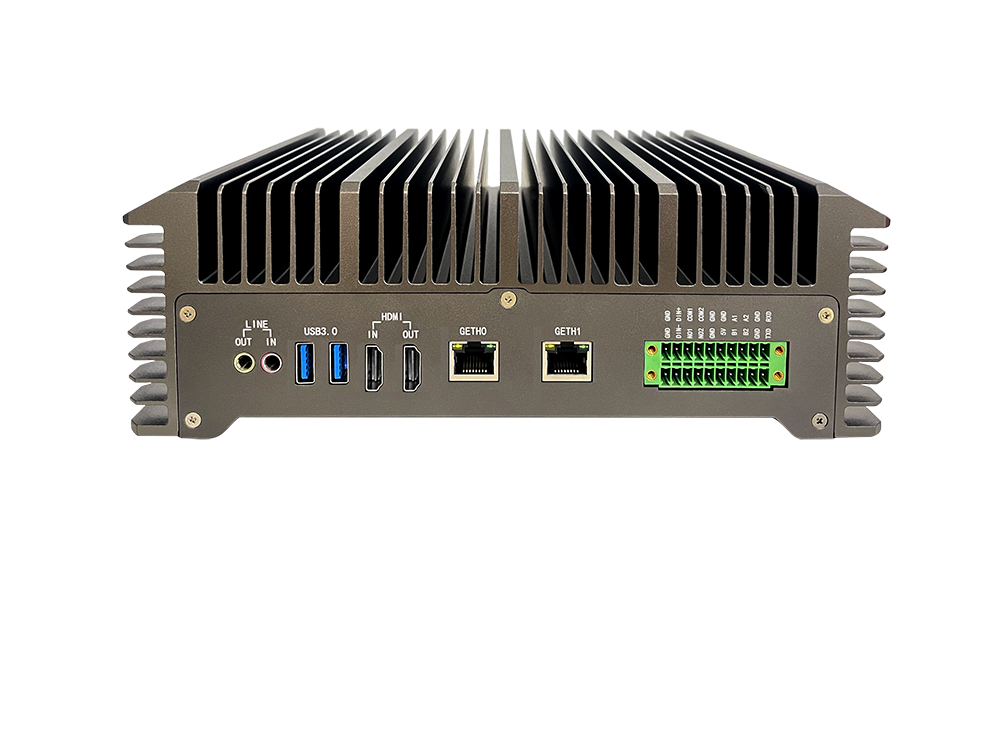
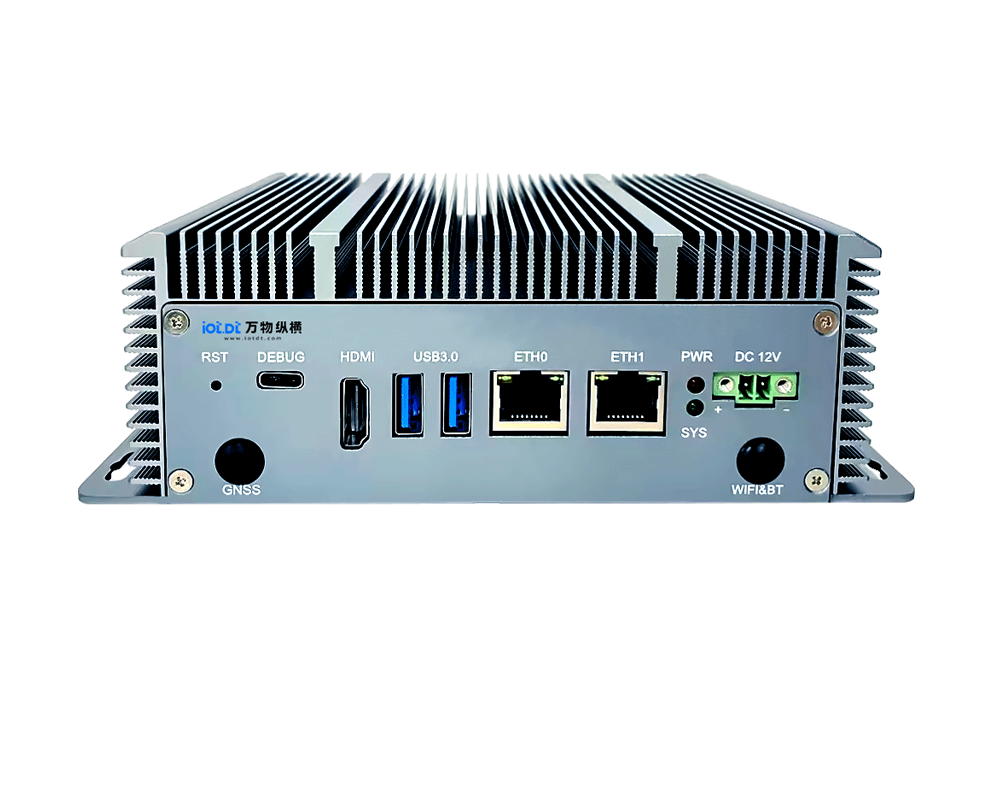
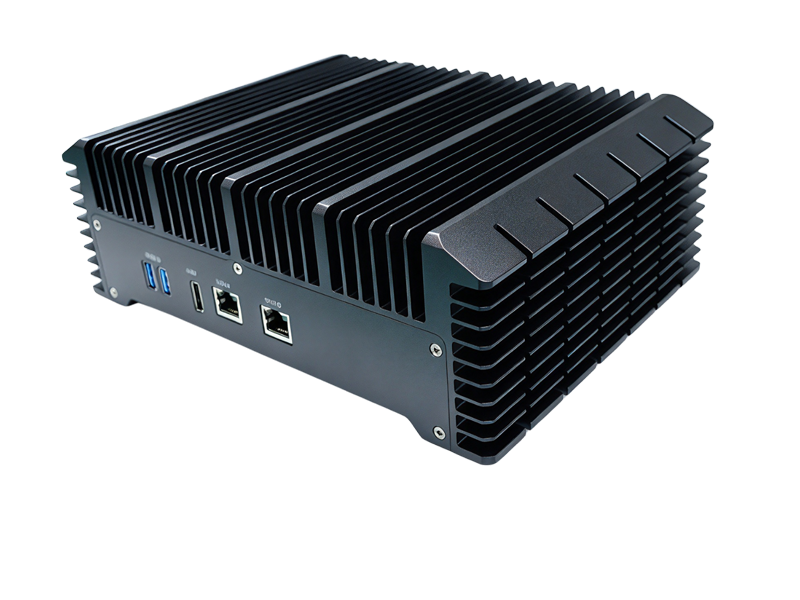
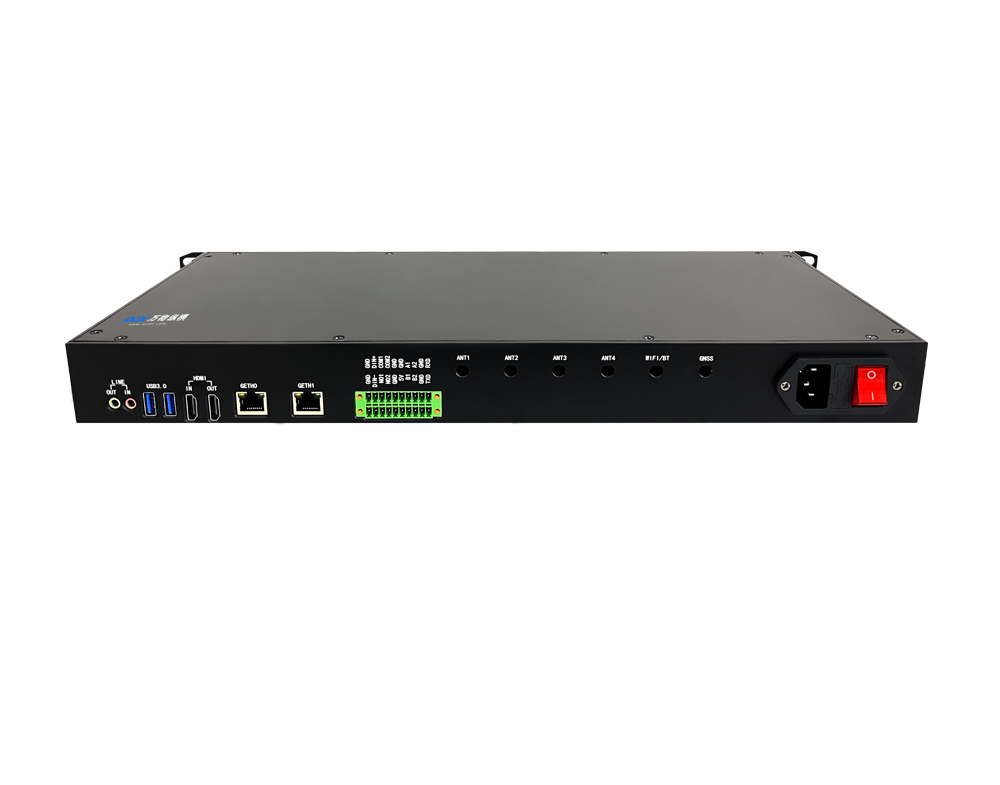
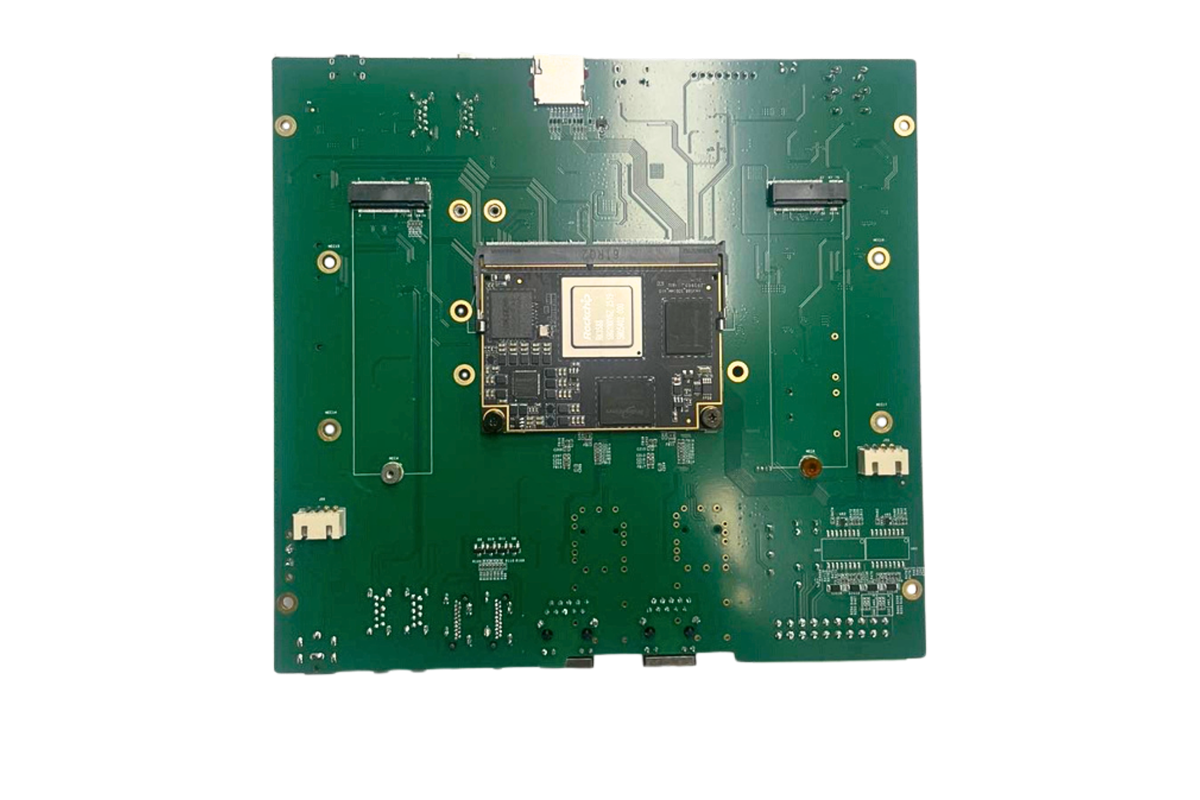
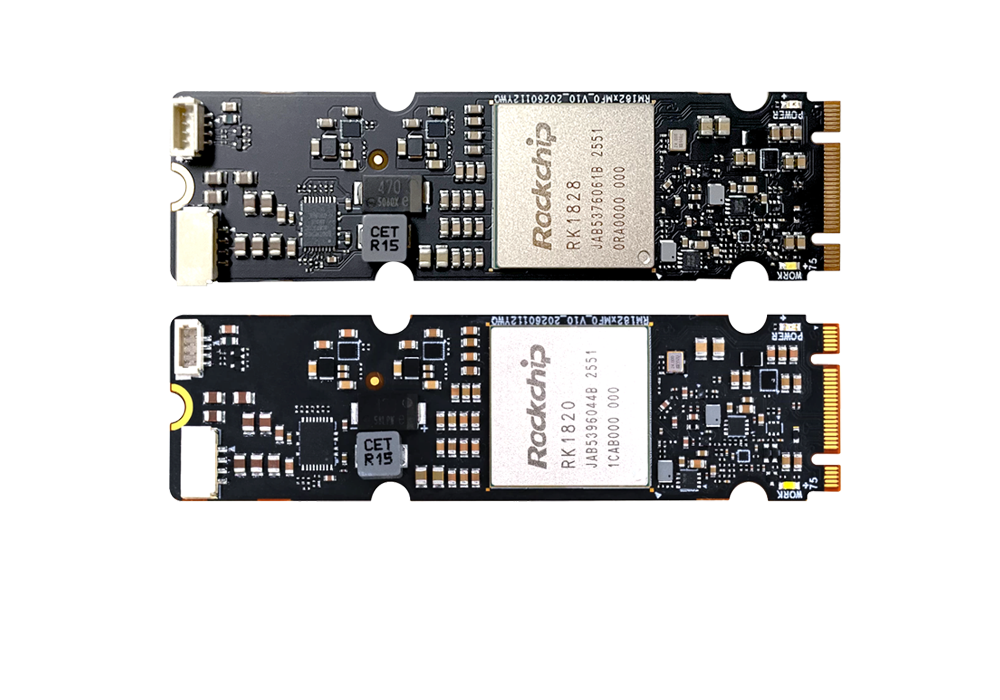
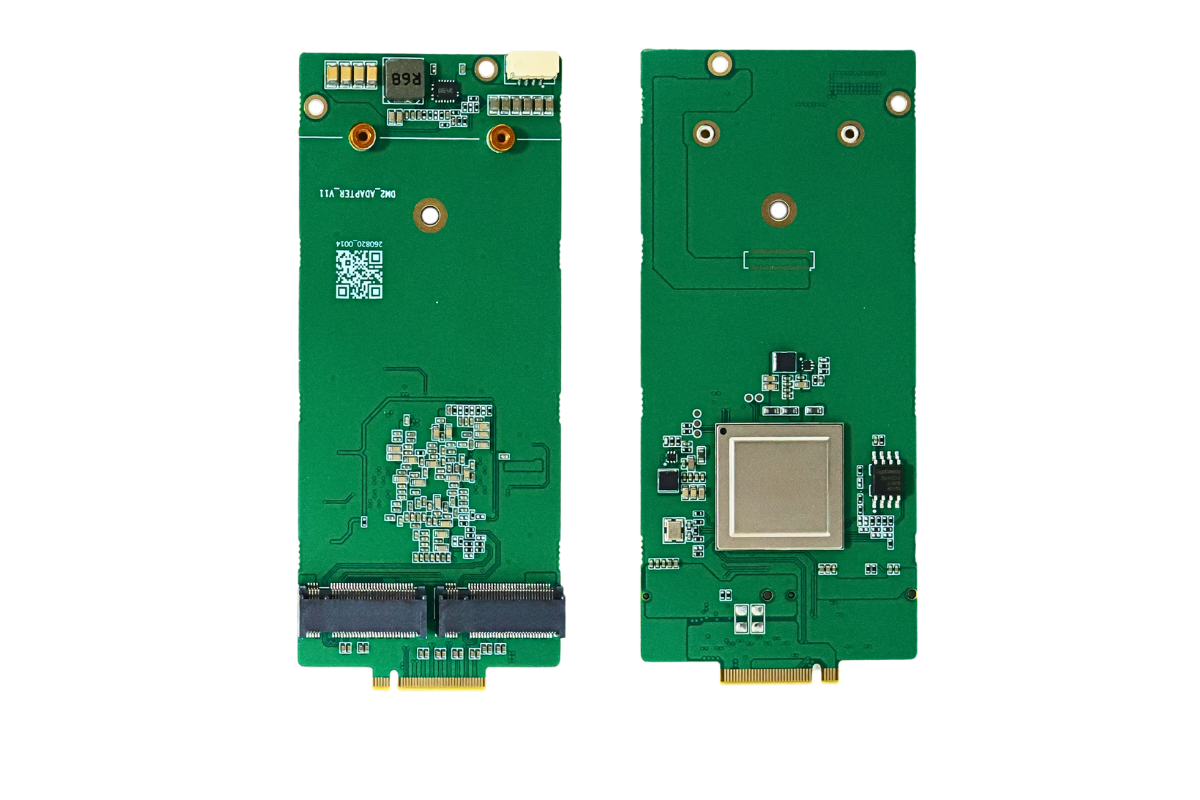


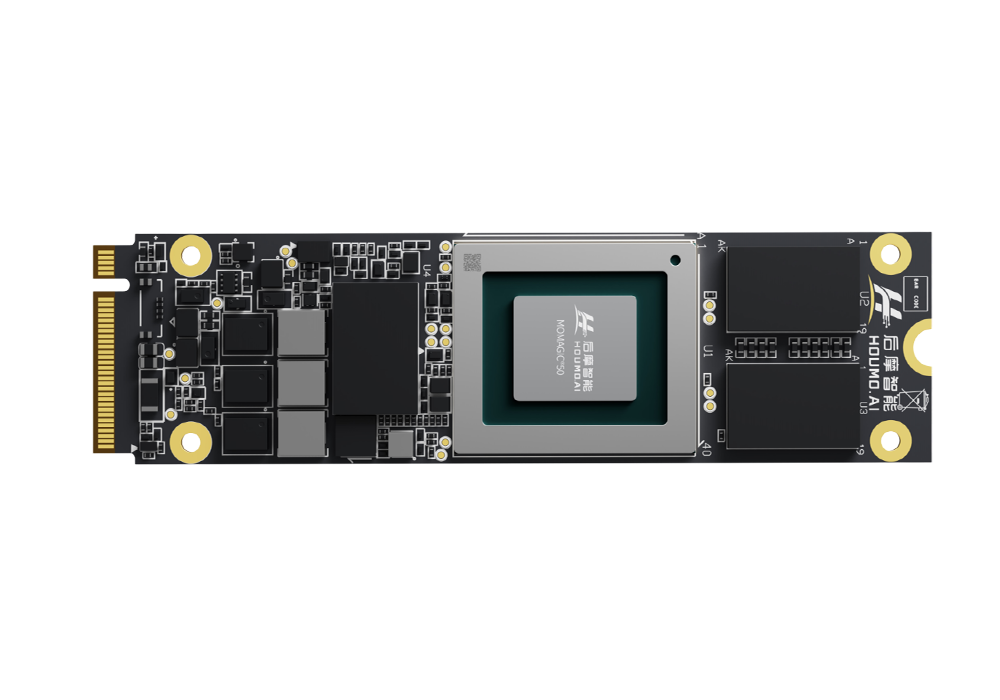
LQ50 Duo(双后摩 M50 存算一体芯片)可在 48GB 内存上端侧部署 Qwen2-32B;INT4 量化下日常对话生成约 14~17 tokens/s,体验流畅;FP8 量化下约 7~9 tokens/s,满足非实时交互需求。整卡满载功耗约 30W,能效比突出。
一、部署可行性:48GB 版本即可稳定运行
LQ50 Duo 集成 2 颗后摩 M50 存算一体芯片,标配 48GB LPDDR5/5X 内存,针对 Qwen2-32B 完全可以端侧部署:
INT4 量化版:模型体积约 16GB,搭配 16K 上下文 KV 缓存,总内存占用约 20~22GB,48GB 内存余量充足,还可同时常驻多个小模型。
FP8 量化版:模型体积约 32GB,搭配 16K 上下文 KV 缓存,总内存占用约 36~38GB,48GB 版本可稳定运行;若需 32K 以上长上下文,建议选择 96GB 版本。
后摩自研大道软件栈已原生适配 Qwen 系列模型,支持一键量化、图优化与编译部署,无需深度定制即可落地。
二、推理速度:基于官方实测数据推算
官方已公开 LQ50 单卡 / Duo 跑 Qwen3-8B 的实测数据(16K 上下文,标准功耗模式,IPU 1400MHz):
硬件配置 | 模型 | 场景 | Decode 生成速度 | Prefill 输入速度 |
LQ50 单卡(单 M50) | Qwen3-8B FP8 | 长输入(16K tokens) | 15.0 tokens/s | 682.6 tokens/s |
LQ50 单卡(单 M50) | Qwen3-8B FP8 | 短输入(<20 tokens) | 22.4 tokens/s | 2187.8 tokens/s |
LQ50 Duo(双 M50) | Qwen3-8B FP8 | 长输入(16K tokens) | 16.3 tokens/s | 577.1 tokens/s |
LQ50 Duo(双 M50) | Qwen3-8B FP8 | 短输入(<20 tokens) | 23.1 tokens/s | 1527.8 tokens/s |
注:8B 模型体积小,单卡内存带宽已能喂饱算力,因此双卡并行收益有限;模型参数量越大,双卡的带宽优势越明显,并行效率越高。整卡功耗:单卡约 11~12W,Duo 约 28.8~31.05W。
LLM 解码阶段核心受内存带宽限制,生成速度与模型体积大致成反比。结合 LQ50 Duo 307.2 GB/s 的内存带宽,推算 Qwen2-32B 的实际表现如下:
1. INT4 量化(推荐,平衡速度与精度)
这是端侧部署的主流选择,精度损失可控,速度体验最佳:
日常对话场景(短输入,输出几百字以内):生成速度约 14~17 tokens/s,相当于每秒输出 7~9 个汉字,接近人类正常阅读速度,对话流畅无明显等待感。
长文档问答场景(16K 上下文输入):生成速度约 11~13 tokens/s。
首字延迟(TTFT):短输入下通常 300~600ms,输入处理(Prefill)速度可达 400~1500 tokens/s,响应迅速。
2. FP8 量化(高精度专业场景)
适合对模型精度要求高的代码生成、逻辑推理、专业知识库等场景:
日常对话场景:生成速度约 7~9 tokens/s,相当于每秒输出 3~5 个汉字,可满足非实时交互需求。
长文档问答场景(16K 上下文):生成速度约 5~7 tokens/s。
Prefill 输入速度:短输入约 600~800 tokens/s,长输入约 200~300 tokens/s。
三、横向对比与实际体验
1. 端侧第一梯队水平
在端侧 / 边缘级 AI 加速卡中,LQ50 Duo 跑 32B 模型的表现属于第一梯队,远优于瑞芯微 RK3588 等通用 SoC(RK3588 仅能流畅运行 7B 以下模型,32B 需 CPU 混合推理,速度不足 2 tokens/s)。
2. 能效比优势显著
整卡满载功耗仅 30W 左右,对比消费级显卡:
RTX 3090(24GB)跑 32B INT4 混合推理约 8~12 tokens/s,功耗 350W。
LQ50 Duo 速度与其接近,但功耗仅为 1/10,非常适合边缘设备、便携终端、工业嵌入式等供电受限场景。
四、影响速度的关键变量
1. 上下文长度:上下文越长,KV 缓存占用越高,解码速度会逐步下降;32K 上下文下,速度比 16K 约低 15%~20%。
2. 并发路数:单路速度最高,多路并发时总吞吐量提升,但单路生成速度会相应下降。
3. 功耗模式:可切换低功耗模式(IPU 1050MHz),速度约为标准模式的 75%,功耗降低约 25%,适配电池供电场景。
4. 软件迭代:后摩大道软件栈持续优化算子与调度策略,后续版本速度仍有 10%~20% 的提升空间。
说明:32B 各场景速度为基于 8B 官方实测数据与内存带宽口径的推算值,实际表现以在 LQ50 Duo 上的真机 benchmark 为准。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部