
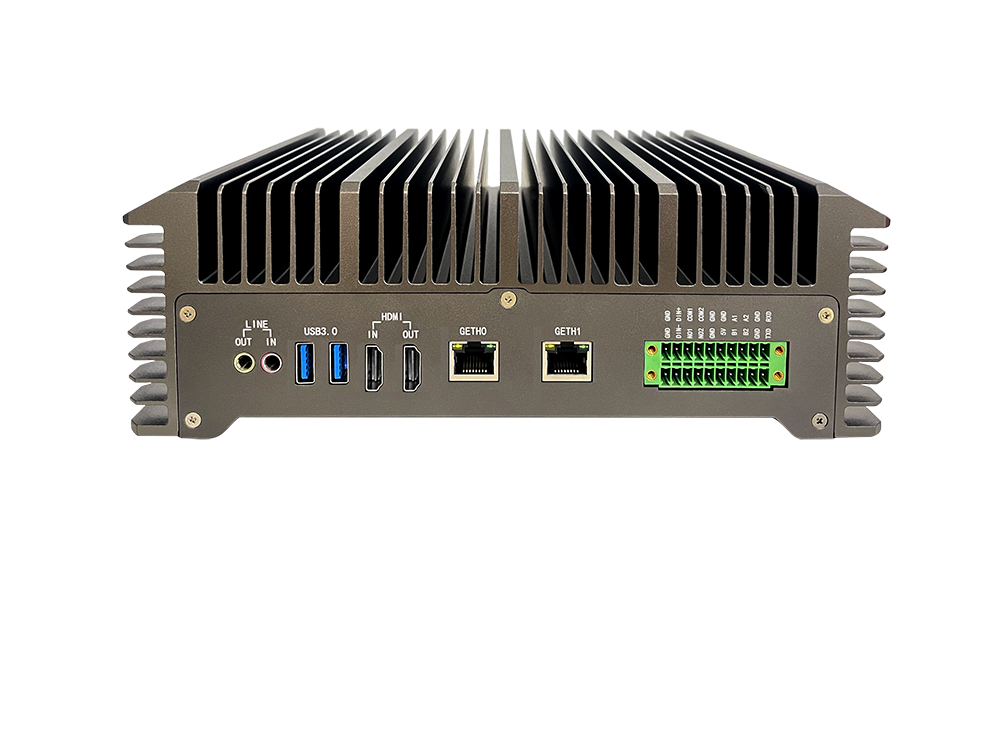
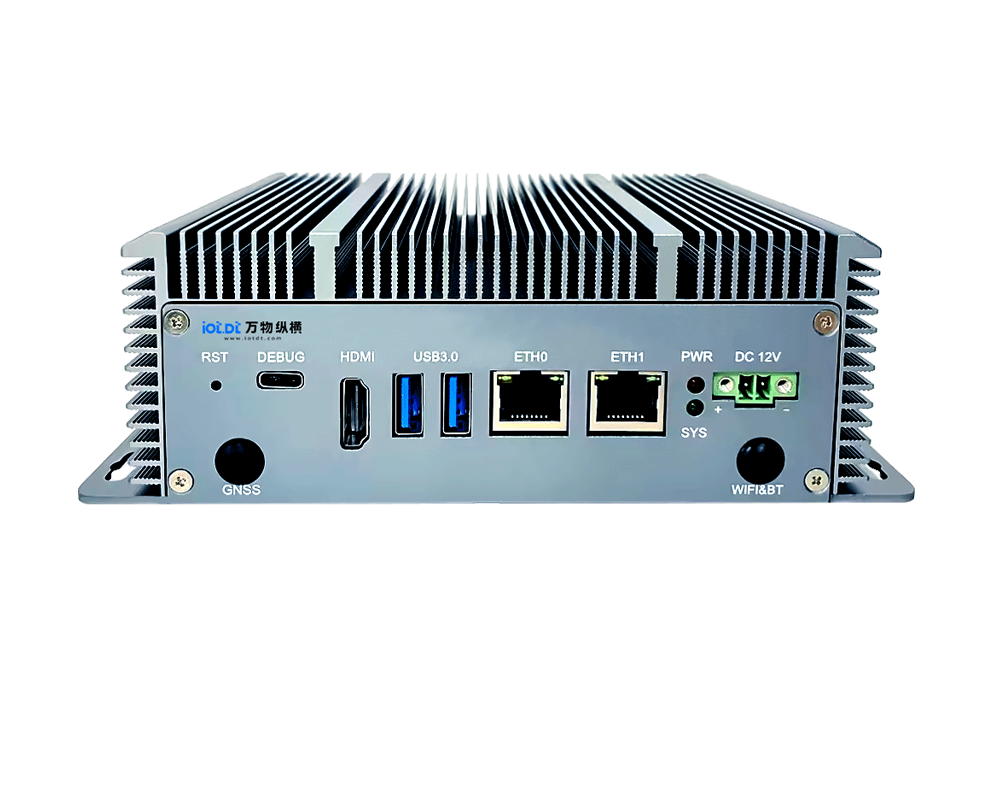
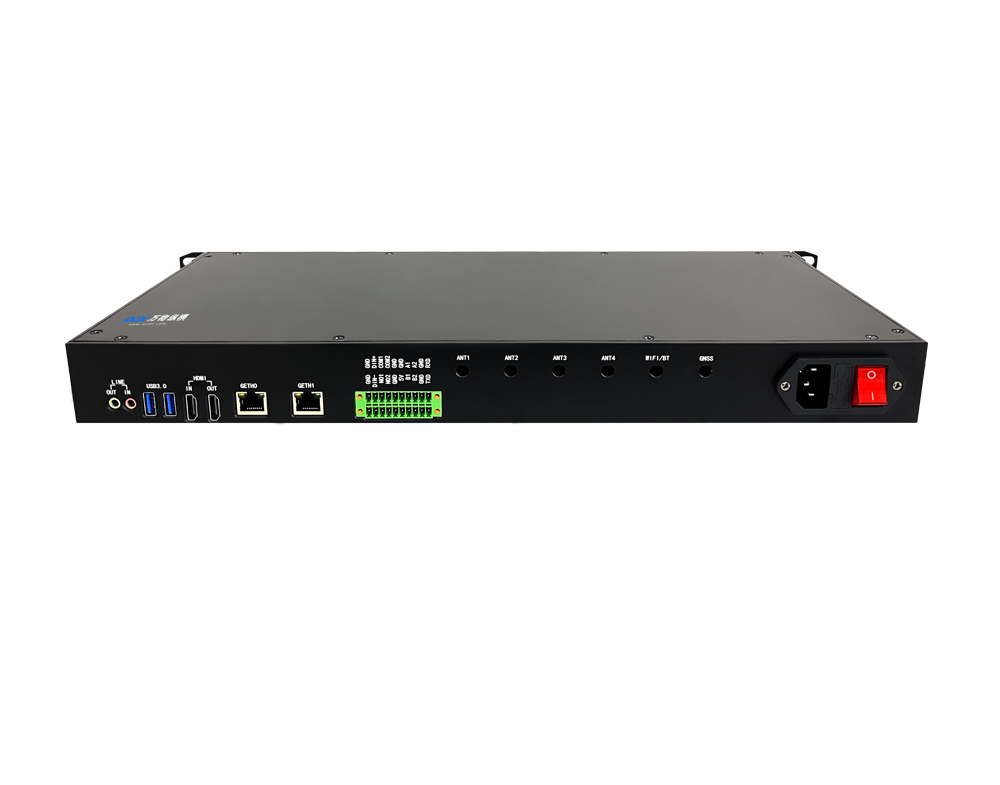
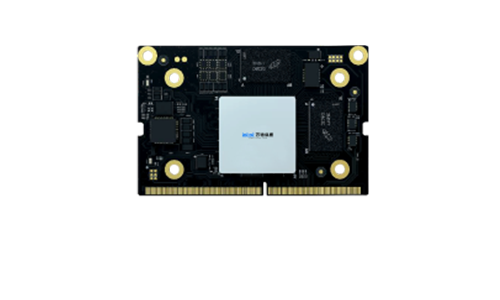
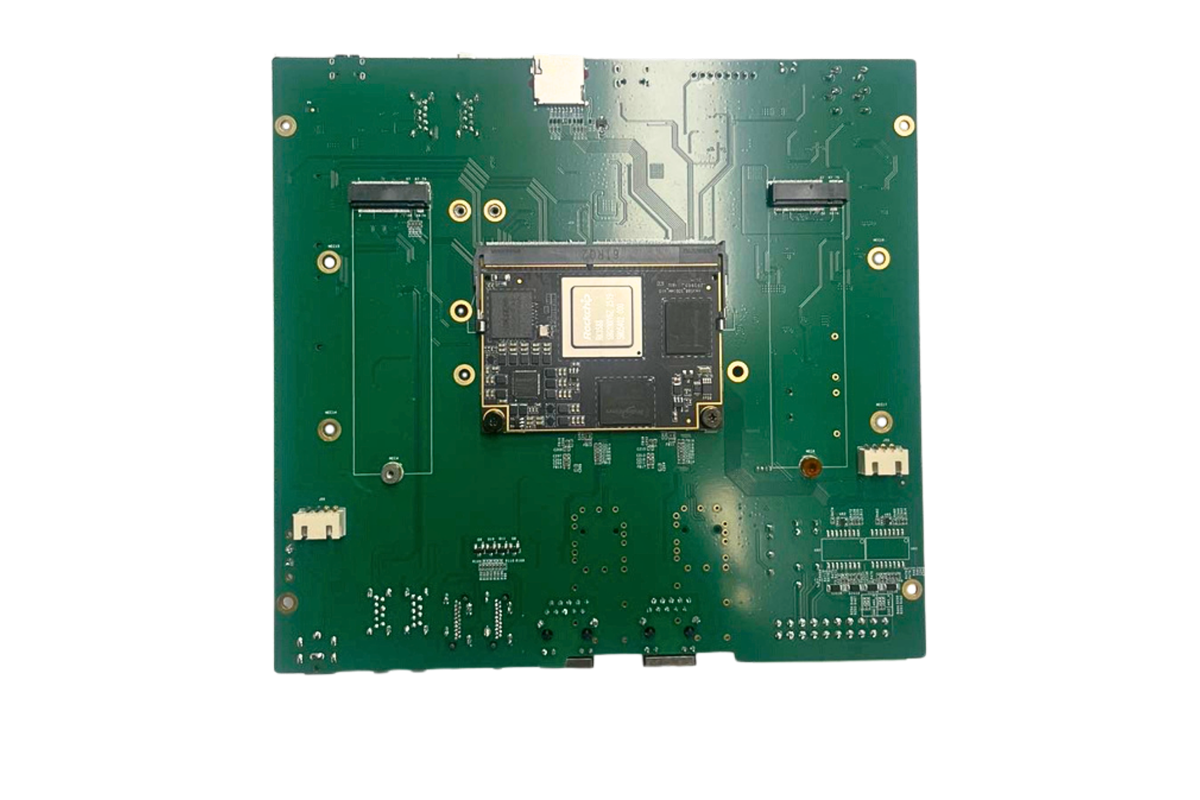
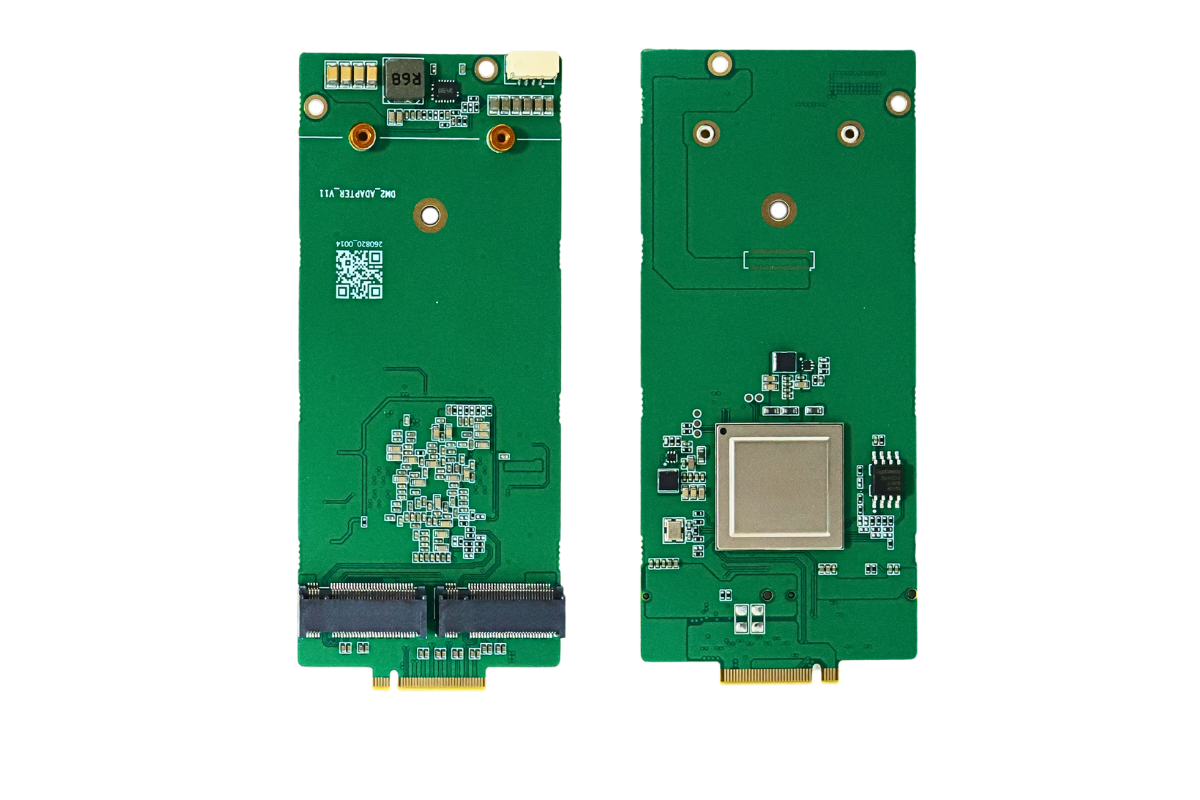


基于 RK3576 芯片的 AIBOX-3576 算力盒子,依托RKLLM 大模型工具链,发布轻量化 DeepSeek‑R1‑7B 模型适配包,通过 INT4 量化压缩,在 6TOPS NPU 上实现纯端侧离线推理,无需联网,主打低功耗、私有化部署,面向工控、本地知识库、边缘智能交互场景。
硬件基础(RK3576)
CPU:4×A72 + 4×A53,最高 2.2GHz
NPU:6TOPS@INT8,支持 INT4/INT8/INT16 混合精度,RKNN+RKLLM SDK 做模型转换与调度
内存:标配 4GB LPDDR4,满足 INT4 量化 7B 模型加载
整机功耗:典型负载约 3W,最大 8W,无风扇静音方案;DC 12V 供电,适合 7×24 小时边缘值守
接口:PCIe2.1、USB3.0、千兆网口、HDMI,支持多屏异显、多路视频接入
轻量化适配包要点
1. 量化方案:DeepSeek‑R1‑7B 采用W4A16 量化,模型体积大幅压缩,4GB 内存即可完整驻留 NPU 推理,避免频繁 swap 拖慢速度;RKLLM-Toolkit 一键完成 HuggingFace 模型转 RKLLM 格式
2. 推理性能:7B INT4,NPU 原生推理,单 token 生成速度可满足对话交互;支持流式输出、多轮对话、上下文窗口可调
3. 系统兼容:Linux / 国产 OS,支持 Docker 容器化部署;配套 demo,开发者可快速接入 STT/TTS,做成完整语音对话终端
4. 模型生态:RK3576 RKLLM 框架同时兼容 Qwen、Llama、ChatGLM 等主流 7B 以内 LLM,也可跑 YOLO、VLM 多模态模型
场景价值
✅ 私有化本地知识库、工业设备运维助手、内网智能客服,数据不出盒子
✅ 低功耗无风扇,适合机柜、车载、嵌入式边缘节点长期运行
✅ 成本远高于 GPU 卡,适合批量边缘 AI 终端落地;可扩展 PCIe 算力卡进一步提升性能
局限
4GB 内存版本只能跑 INT4 量化 7B,INT8 版本需要更大内存
6TOPS 算力定位轻量对话,不适合超长上下文、高并发批量推理
属于端侧推理,不适合大模型训练
对比参考
平台 | 模型 | 量化 | 典型功耗 |
RK3576 AIBOX | DeepSeek R1 7B | INT4 | ≈3W |
RK3588 盒子 | 7B | INT4 | ≈5W |
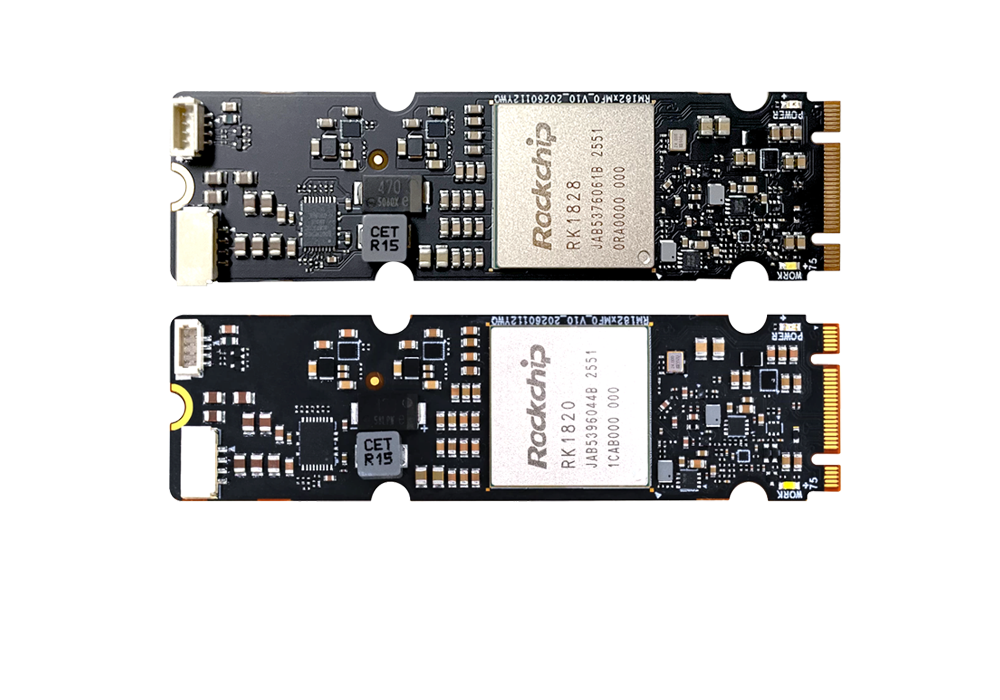
RK182X 协处理器 | 7B | INT4 | 扩展方案 |
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部