
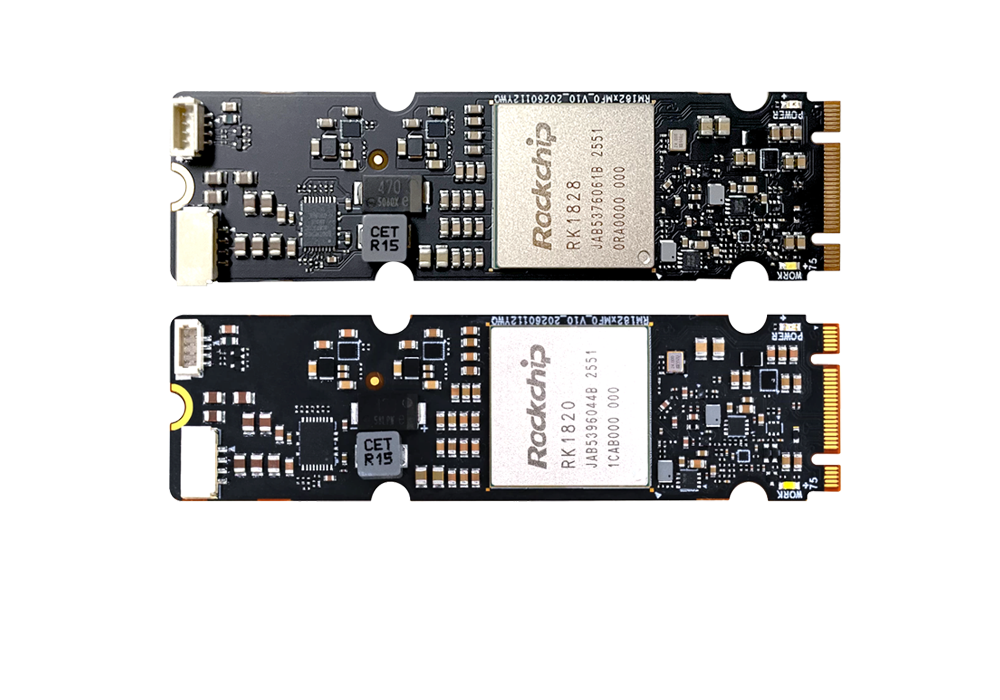
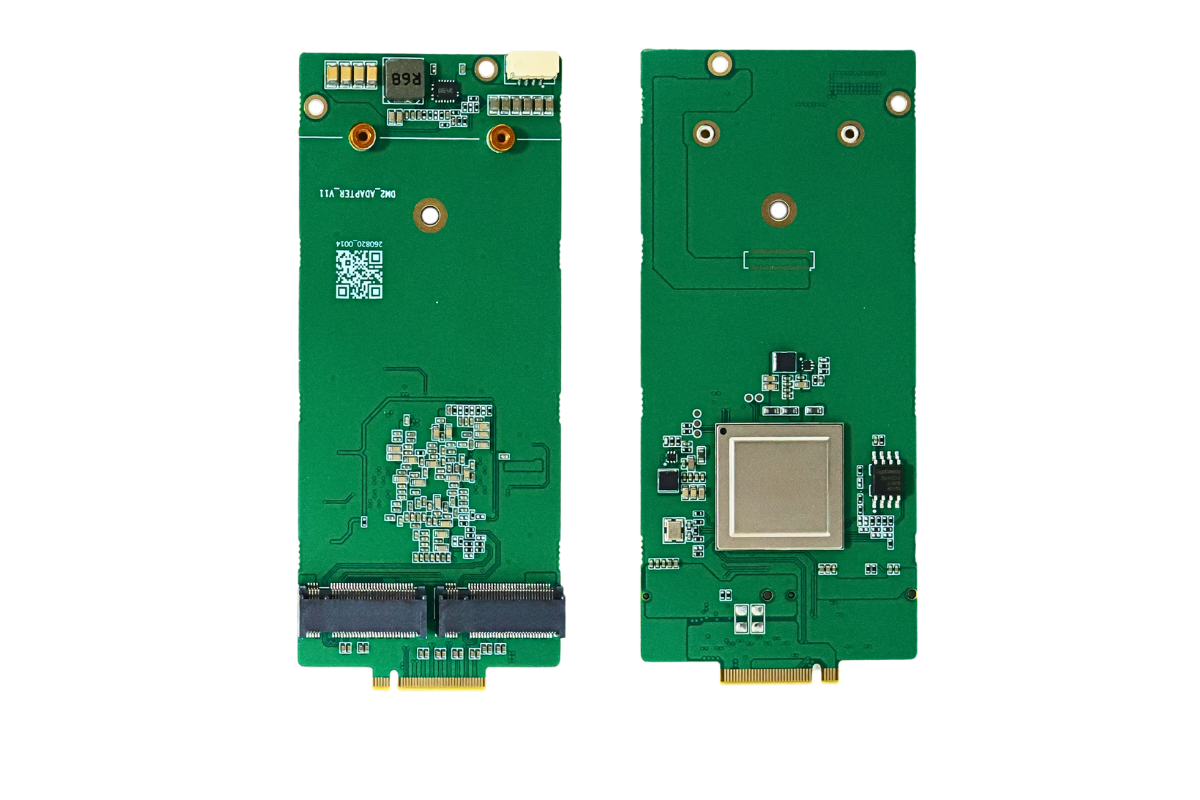


核心背景:本地 Agent Function Call(工具调用)分为两部分:LLM推理(生成思考、判断、输出function call JSON)+ 主控侧工具调度;LQ50系列只负责LLM推理,函数解析/工具执行循环由CPU/主控完成。
LQ50:单M50;LQ50 Duo:双M50,带HM-LINK片间互联,内存、带宽、算力翻倍
硬件基础参数
项目 | LQ50(单卡) | LQ50 Duo(双芯M.2) |
芯片 | 1×M50 | 2×M50,HM-LINK高速互联 |
INT8算力 | 160 TOPS | 320 TOPS |
板载内存 | 24GB LPDDR5 | 48GB LPDDR5 |
内存带宽 | 153.6 GB/s | 307.2 GB/s |
典型功耗 | ~10W | ~20W |
推荐模型上限 | 7B~8B(完整载入) | 14B~32B可部署,支持模型张量拆分跨双芯 |
原生推理速度 | 7B模型 ≥25 token/s | 7B同模型可接近翻倍;14B可稳定跑 |
Agent Function Call 场景对比
1. 小模型Agent(7B,Qwen2.5-7B / Llama3-7B)
这是最常用的Function Call底座模型。
LQ50
优势:低功耗、被动散热,适合7×24小时挂机单Agent循环;单芯片无跨芯调度开销,单次function call延迟更稳定。
局限:内存24GB,7B模型+KV缓存+工具描述(system prompt、function schema)占用高,并发Agent数量受限,多轮长工具链容易KV爆内存。
适合:单Agent、轻工具集(3~10个工具)、单轮/短循环Function Call(本地文件查询、简单API调用)。
LQ50 Duo
优势:48GB大内存,KV缓存池大;同7B模型可预留更多上下文窗口,长工具链、多轮递归Function Call稳定性大幅提升;支持多Agent并发,可把多个独立Agent分别绑定到两颗M50芯片并行跑。
局限:单模型不分片跑7B时,没有性能增益,功耗更高;若开启张量拆分,会引入少量HM-LINK片间通信延迟。
适合:多Agent并行、复杂工具集、长上下文、多轮嵌套Function Call(多工具链式调用、RAG+工具混合、多子任务规划)。
2. 中大模型Agent(14B/32B)
更强Function Call/复杂规划能力。
LQ50:24GB内存不足以完整加载14B量化模型,不推荐跑中大模型Agent;只能用CPU+卡混合推理,function call延迟高、抖动大,容易丢工具调用格式。
LQ50 Duo:48GB内存+双芯张量拆分,可本地跑14B甚至32B量化模型;大模型更强的工具选择、参数提取、多步规划能力,复杂Agent任务(代码执行、多工具编排、复杂决策)的function call准确率显著优于7B。
关键点:Function Call质量不只看token速度,模型能力 > 推理速度,14B/32B在复杂工具选择、JSON格式输出、参数校验上远强于7B。
3. 并发与多Agent场景
LQ50:单芯资源独占,同一时间只能跑1个Agent主循环;多Agent只能串行排队,并发差。
LQ50 Duo:双芯硬件隔离,后摩大道SDK支持设备ID绑定,两个Agent实例可以分别跑在M50-0、M50-1并行执行;适合多智能体、任务池并行调用工具。
4. Function Call 延迟与抖动(重点)
单Agent+7B小模型:LQ50延迟略优,没有跨芯通信开销,单次工具判断、生成function JSON抖动更小。
长上下文/多轮工具链 / 14B+模型:LQ50 Duo占优;LQ50容易因KV缓存不足触发截断,导致function call失效、丢失工具参数。
选型建议
1. 只做单个本地Agent、7B模型、少量工具、低功耗静音:选 LQ50,性价比最高,单轮function call延迟更稳。
2. 需要多Agent并发、长上下文、多工具链式递归、跑14B/32B增强Function Call能力:选 LQ50 Duo,大内存+双芯并行是核心优势。
3. 边缘Agent盒子(智慧工地、本地MCP、设备运维Agent):优先 LQ50 Duo,复杂任务下function call成功率更高。
总结
LQ50系列硬件本身不负责解析function call JSON、执行本地工具(shell/python/数据库),工具调用的代码执行、参数校验、返回结果拼接,全部由主控CPU完成;CPU性能会成为Agent循环瓶颈,两张卡都存在这个问题。
请用手机扫码查看分享内容
 下一篇:PCIe 带宽压力实测:LQ50 Duo、LQ50、RK1828 M.2 不同 PCIe 通道下性能损耗测试
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)


 试用申请
 产品咨询
 在线客服
 回到顶部