
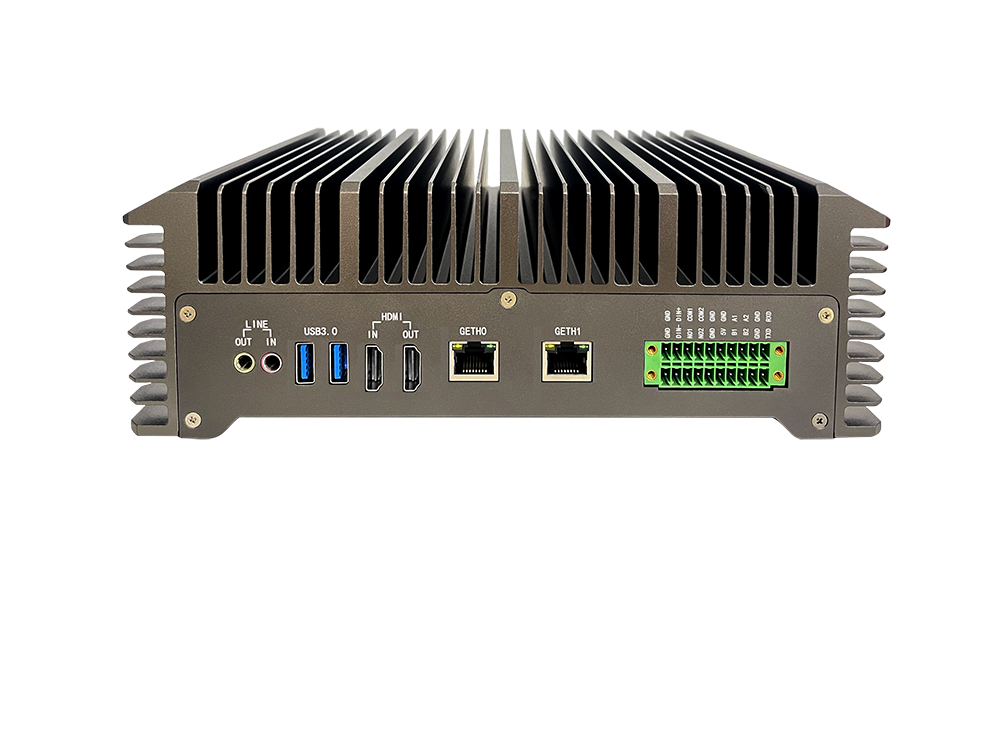
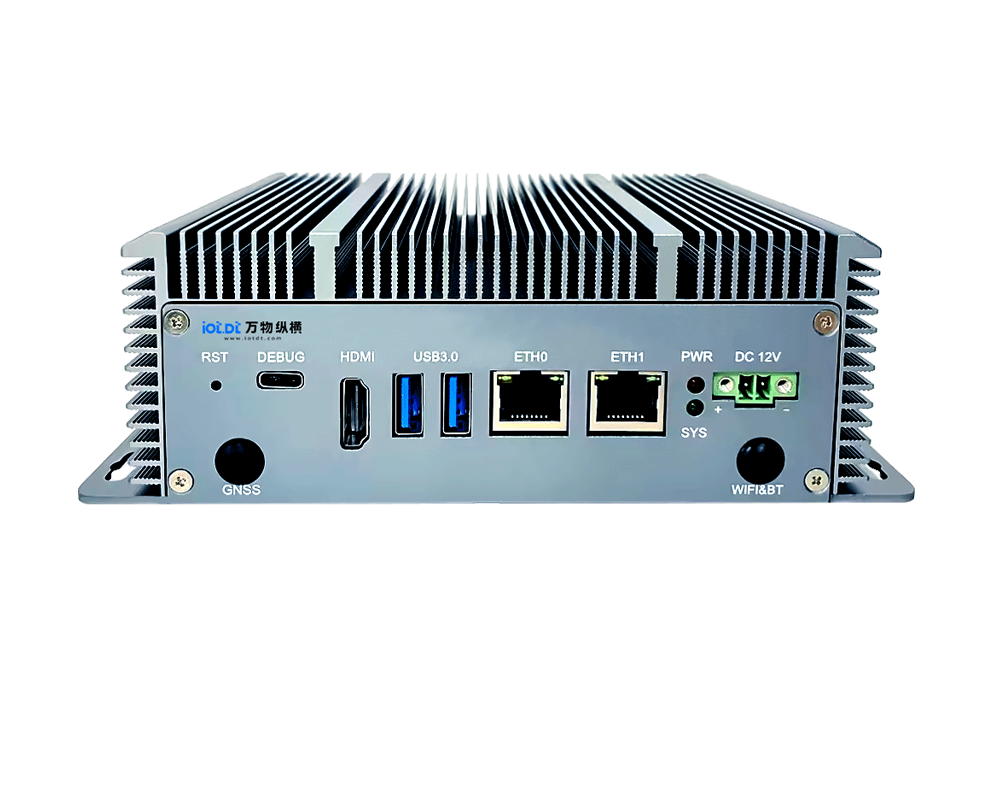
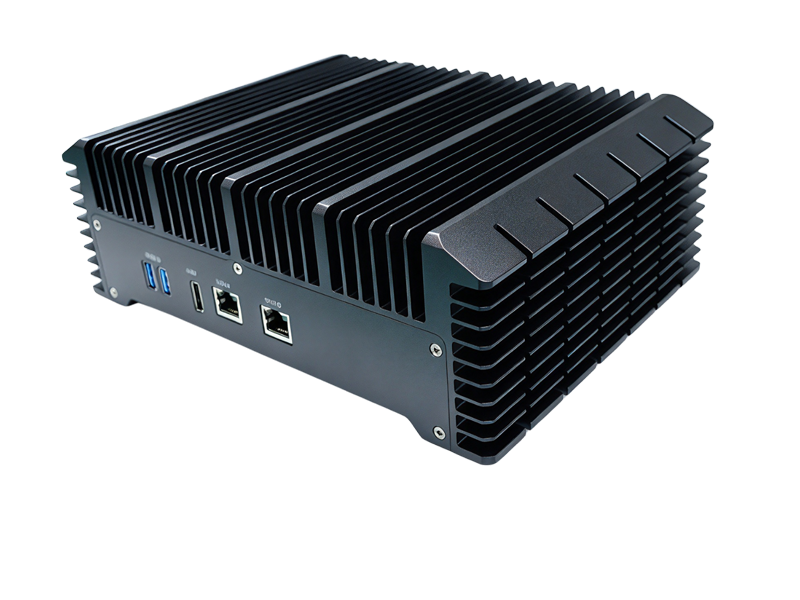
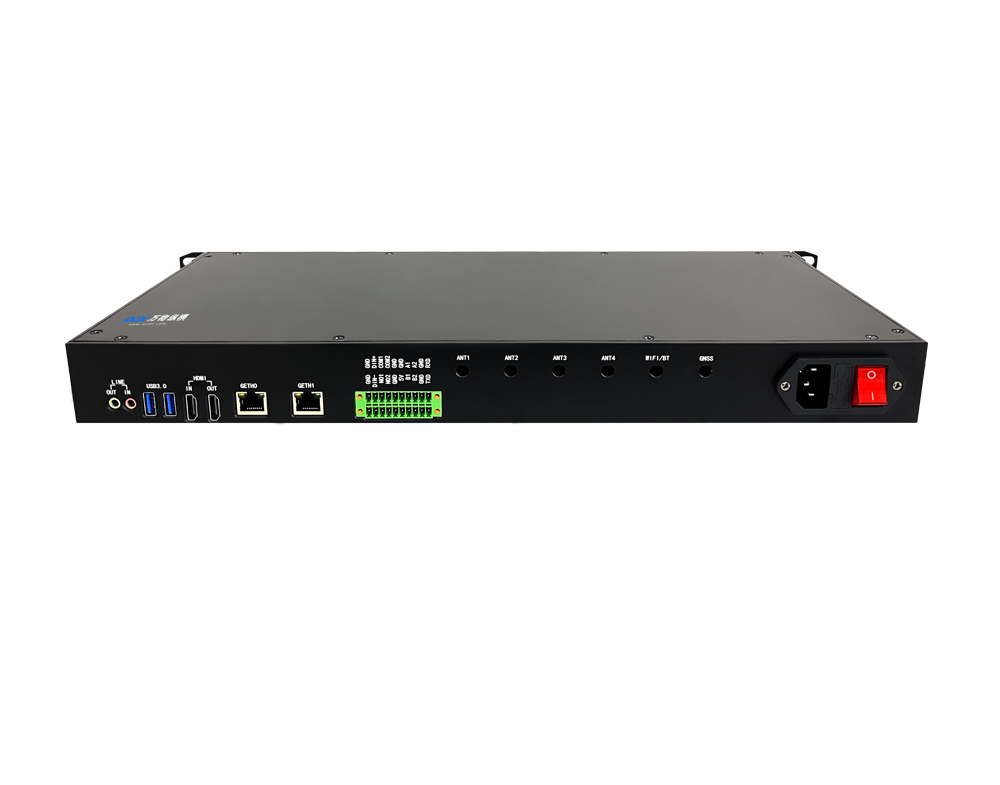
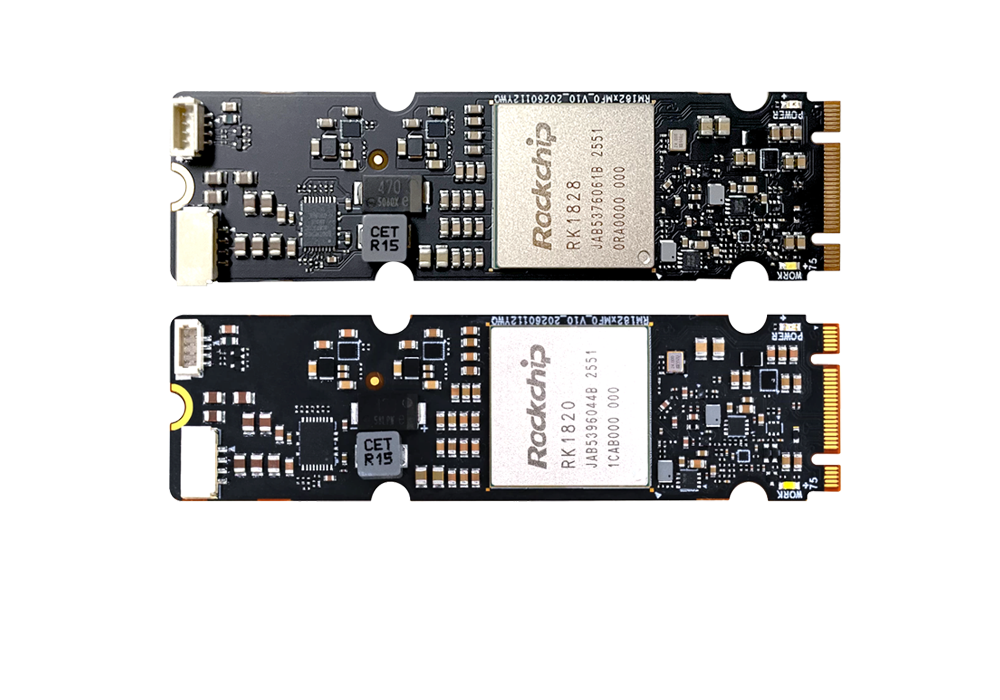
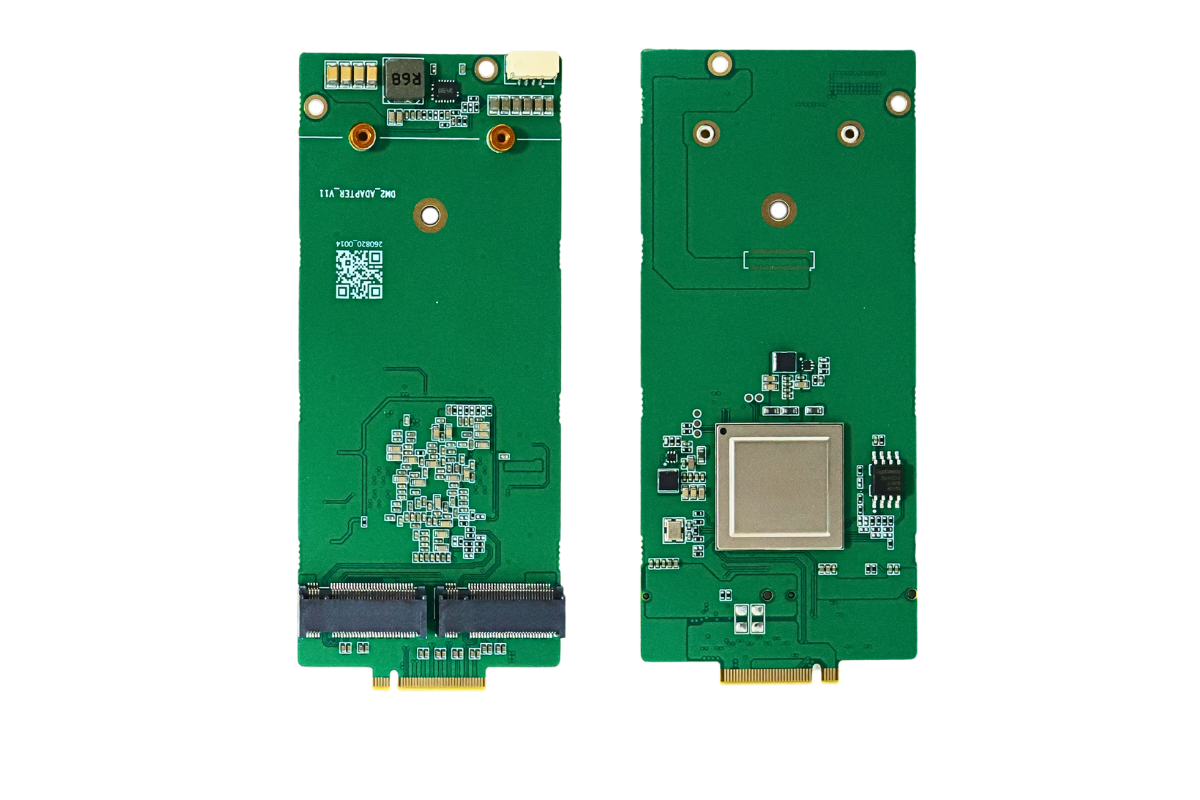


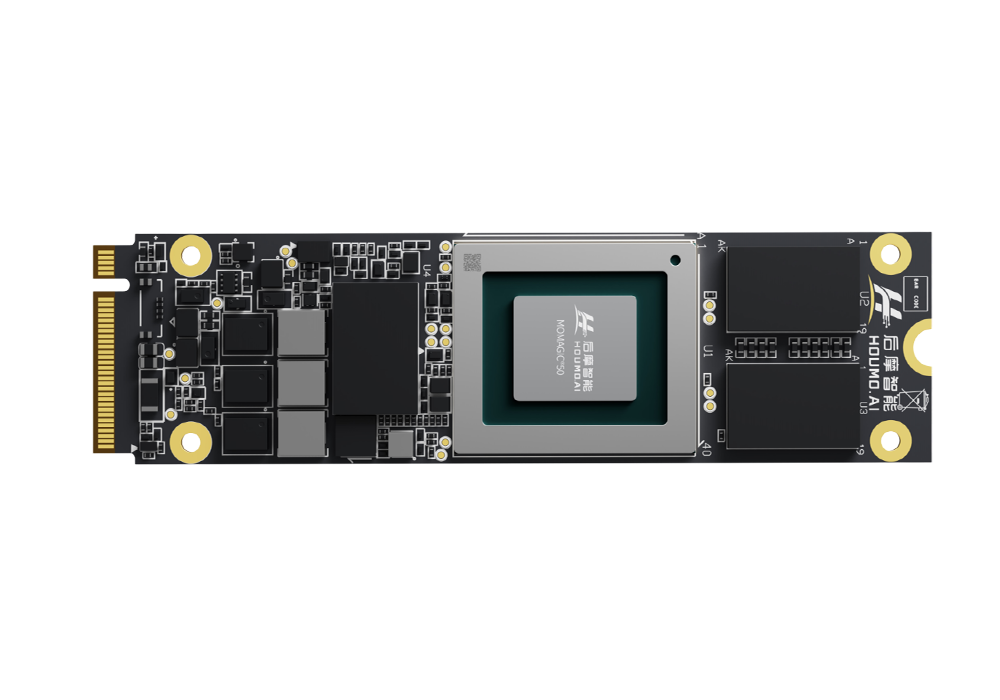
力擎 LQ50 Duo(后摩智能漫界 M50 双芯方案)边缘算力盒,现已完成 Qwen-VL 多模态模型本地微调适配,依托双 M50 存算一体芯片、C-to-C 芯片互联与后摩大道软件栈,在边缘端实现「本地数据集训练 → LoRA/QLoRA 高效微调 → 模型本地推理」全闭环,无需云端算力,数据不出设备,满足工业、安防、质检场景私有化多模态模型定制需求。
硬件基础
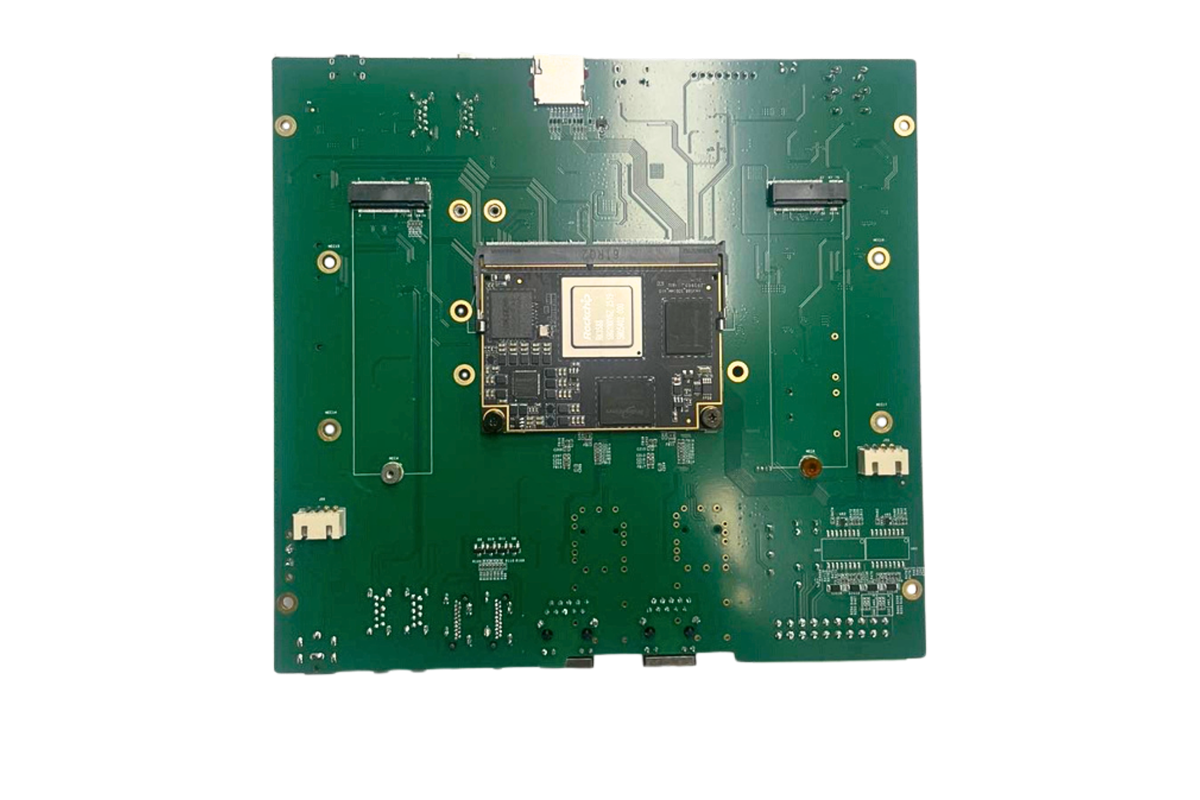
双芯漫界 M50,320 TOPS INT8,最高 48GB 板载 LPDDR5 内存,带宽 307.2GB/s;双芯片 C-to-C 直连协同,支持模型权重分片加载。
低功耗边缘形态,可集成至算力盒子、AI 工作站,适配离线工业现场、园区视频分析、产线视觉质检。
新增核心能力亮点
Qwen-VL 全系列适配
支持 Qwen-VL 2B / 4B / 7B / 8B 版本,可对图像、视频帧、票据、图纸、UI 截图做图文多模态微调,完成行业领域视觉知识注入(如产品缺陷识别、仪表读数、图纸解析)。
边缘端高效 PEFT 微调(LoRA / QLoRA)
不做全参数训练,仅训练低秩适配器,大幅降低显存开销;支持 4/8-bit 量化微调,在 LQ50 Duo 有限板载内存上完成领域 SFT,训练产出 LoRA 适配器可直接合并部署在本机推理,训练、推理同硬件,模型无需跨设备迁移。
私有化离线闭环,数据不出边缘盒
图片、标注数据集全程本地读取、本地训练,不上传云端,解决工厂、政务、涉密场景数据安全合规痛点;微调完成后直接在算力盒跑 Qwen-VL 多模态推理,视频流 + 图文实时解析。
后摩大道软件平台原生支持
模型转换、量化、微调脚本、推理 API 统一在大道 SDK 内,兼容 ms-swift、Transformers 训练框架;训练后模型可直接导出适配 M50 的推理格式,一键部署,减少模型迁移适配成本。
典型落地场景
工业质检:微调 Qwen-VL 识别产线零部件划痕、缺料、尺寸缺陷。
智慧工地 / 明厨亮灶:定制场景图像识别,安全帽、烟火、违规行为图文理解。
文档票据 OCR + 解析:对表单、手写单据、工程图纸做领域微调。
机器人视觉:机器人本地多模态感知,实物图文问答、场景理解。
价值对比
对比维度 | 传统方案(云端 GPU 微调) | LQ50 Duo 新方案(边缘本地微调) |
数据流向 | 数据上传云端,隐私风险大 | 数据本地闭环,不出设备 |
网络依赖 | 需稳定公网,断网不可用 | 完全离线可用 |
模型迭代 | 训练后下发边缘设备,跨设备迁移 | 训练、推理同硬件,一键合并部署 |
成本结构 | 持续云端算力租用费用 | 一次性硬件投入,本地完成迭代 |
响应延迟 | 受网络往返影响 | 本地实时解析 |
限制说明
受双 M50 内存与算力约束,全参数大模型微调不推荐,优先 LoRA / QLoRA 轻量微调;大参数量 Qwen-VL-32B 适合仅推理,微调优先选用 8B 及以下 VL 版本。
微调速度弱于云端 A100 等 GPU,适合小样本行业数据集迭代,不适合百万级海量数据集大规模训练。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部